📚 기술사 수험서 찾아보기

토목시공기술사 → 건축시공기술사 → 건설안전기술사 → 측량및지형공간정보기술사 →

이 포스팅은 쿠팡 파트너스 활동의 일환으로, 이에 따른 일정액의 수수료를 제공받습니다.

레이블이 QGIS 실습인 게시물을 표시합니다. 모든 게시물 표시

2026-11-21

Whitebox 실제 QGIS 실습 32 — 유사이송지수(STI)로 다시 본 두 유역: 집수면적 0.4제곱이 본류 쏠림을 걷어냈다

31편에서 하천강도지수(SPI)로 두 유역을 비교했더니 평균은 중간유역 A−B가, 중앙값은 유역 B가 컸다. 평균을 끌어올린 것은 A 본류가 지나가는 셀 1%였다. 그렇다면 같은 재료로 침식을 보는 다른 지수를 쓰면 어떻게 될까. 이번에는 Whitebox SedimentTransportIndex로 유사이송지수(Sediment Transport Index, STI)를 만들어 같은 두 유역을 다시 비교했다.

STI는 토양유실 식(USLE·RUSLE)의 경사장 인자 LS를 지형 자료로 계산하려고 만든 꼴이다. 식은 STI = (n+1) × (SCA / 22.13)n × (sin β / 0.0896)m이고, Whitebox 기본값은 n = 0.4, m = 1.3이다. 22.13 m는 USLE 표준 시험구의 사면 길이, 0.0896은 9% 경사의 sin 값이다. 두 값으로 나눠 단위를 없앤 꼴이다. SPI와 가장 큰 차이는 집수면적에 0.4제곱을 씌운다는 점이다. SCA가 만 배 커져도 STI 쪽 몫은 약 40배밖에 커지지 않는다.

자료

31편 입력 폴더를 새 입력 폴더(WB32_Input_20261121)로 복사하고, 비교용으로 31편 출력 SPI도 같이 복사했다. 복사본 해시는 원본과 같다.

입력원래 출처내용
wb32_input_sca_dinf.tif30편 DInf Flow Accumulation18편 함몰지 절개 DEM(최대 비용 0.03)에서 만든 D-무한대 비집수면적(m²/m). 1 m 셀, NAD83 UTM 13N EPSG:26913, 1,500×1,500 셀
wb32_input_slope_deg.tif30편 Slope같은 DEM의 경사, 도 단위
wb32_input_spi_wb31.tif31편 StreamPowerIndex비교용 하천강도지수
wb32_input_basins_merged.shp26편 병합 폴리곤VALUE 1 = 중간유역(A−B) 1,218,780 m², VALUE 2 = B 유역 211,372 m²
wb32_input_streams_cap0p03.tif18편 하천집수면적 1 ha 기준 하천(지도와 하천 셀 통계용)

SCA와 경사를 30편 것 그대로 쓴 이유는 31편과 같다. 지수끼리 비교하려면 입력이 셀 단위로 같아야 한다.

1단계: SedimentTransportIndex

공간 처리 툴박스 → WhiteboxTools → Geomorphometric Analysis → SedimentTransportIndex를 연다.

입력란값이유
Input Specific Contributing Area (SCA) FileSpecific contributing area, D-inf (m2/m, practice 30)로그 변환을 하지 않은 SCA. 식 안에서 22.13 m로 나누므로 단위가 m²/m여야 한다.
Input Slope FileSlope, degrees (practice 30)도 단위 경사. 아래 독립 계산에서 도를 라디안으로 바꿔 sin을 취한 값과 맞았다.
Specific Contributing Area (SCA) Exponent0.4(기본값)식의 n. 보통 0.4~0.6 사이 값을 쓴다. 첫 비교라 기본값으로 두었다.
Slope Exponent1.3(기본값)식의 m.
Output Filewb32_sti.tif
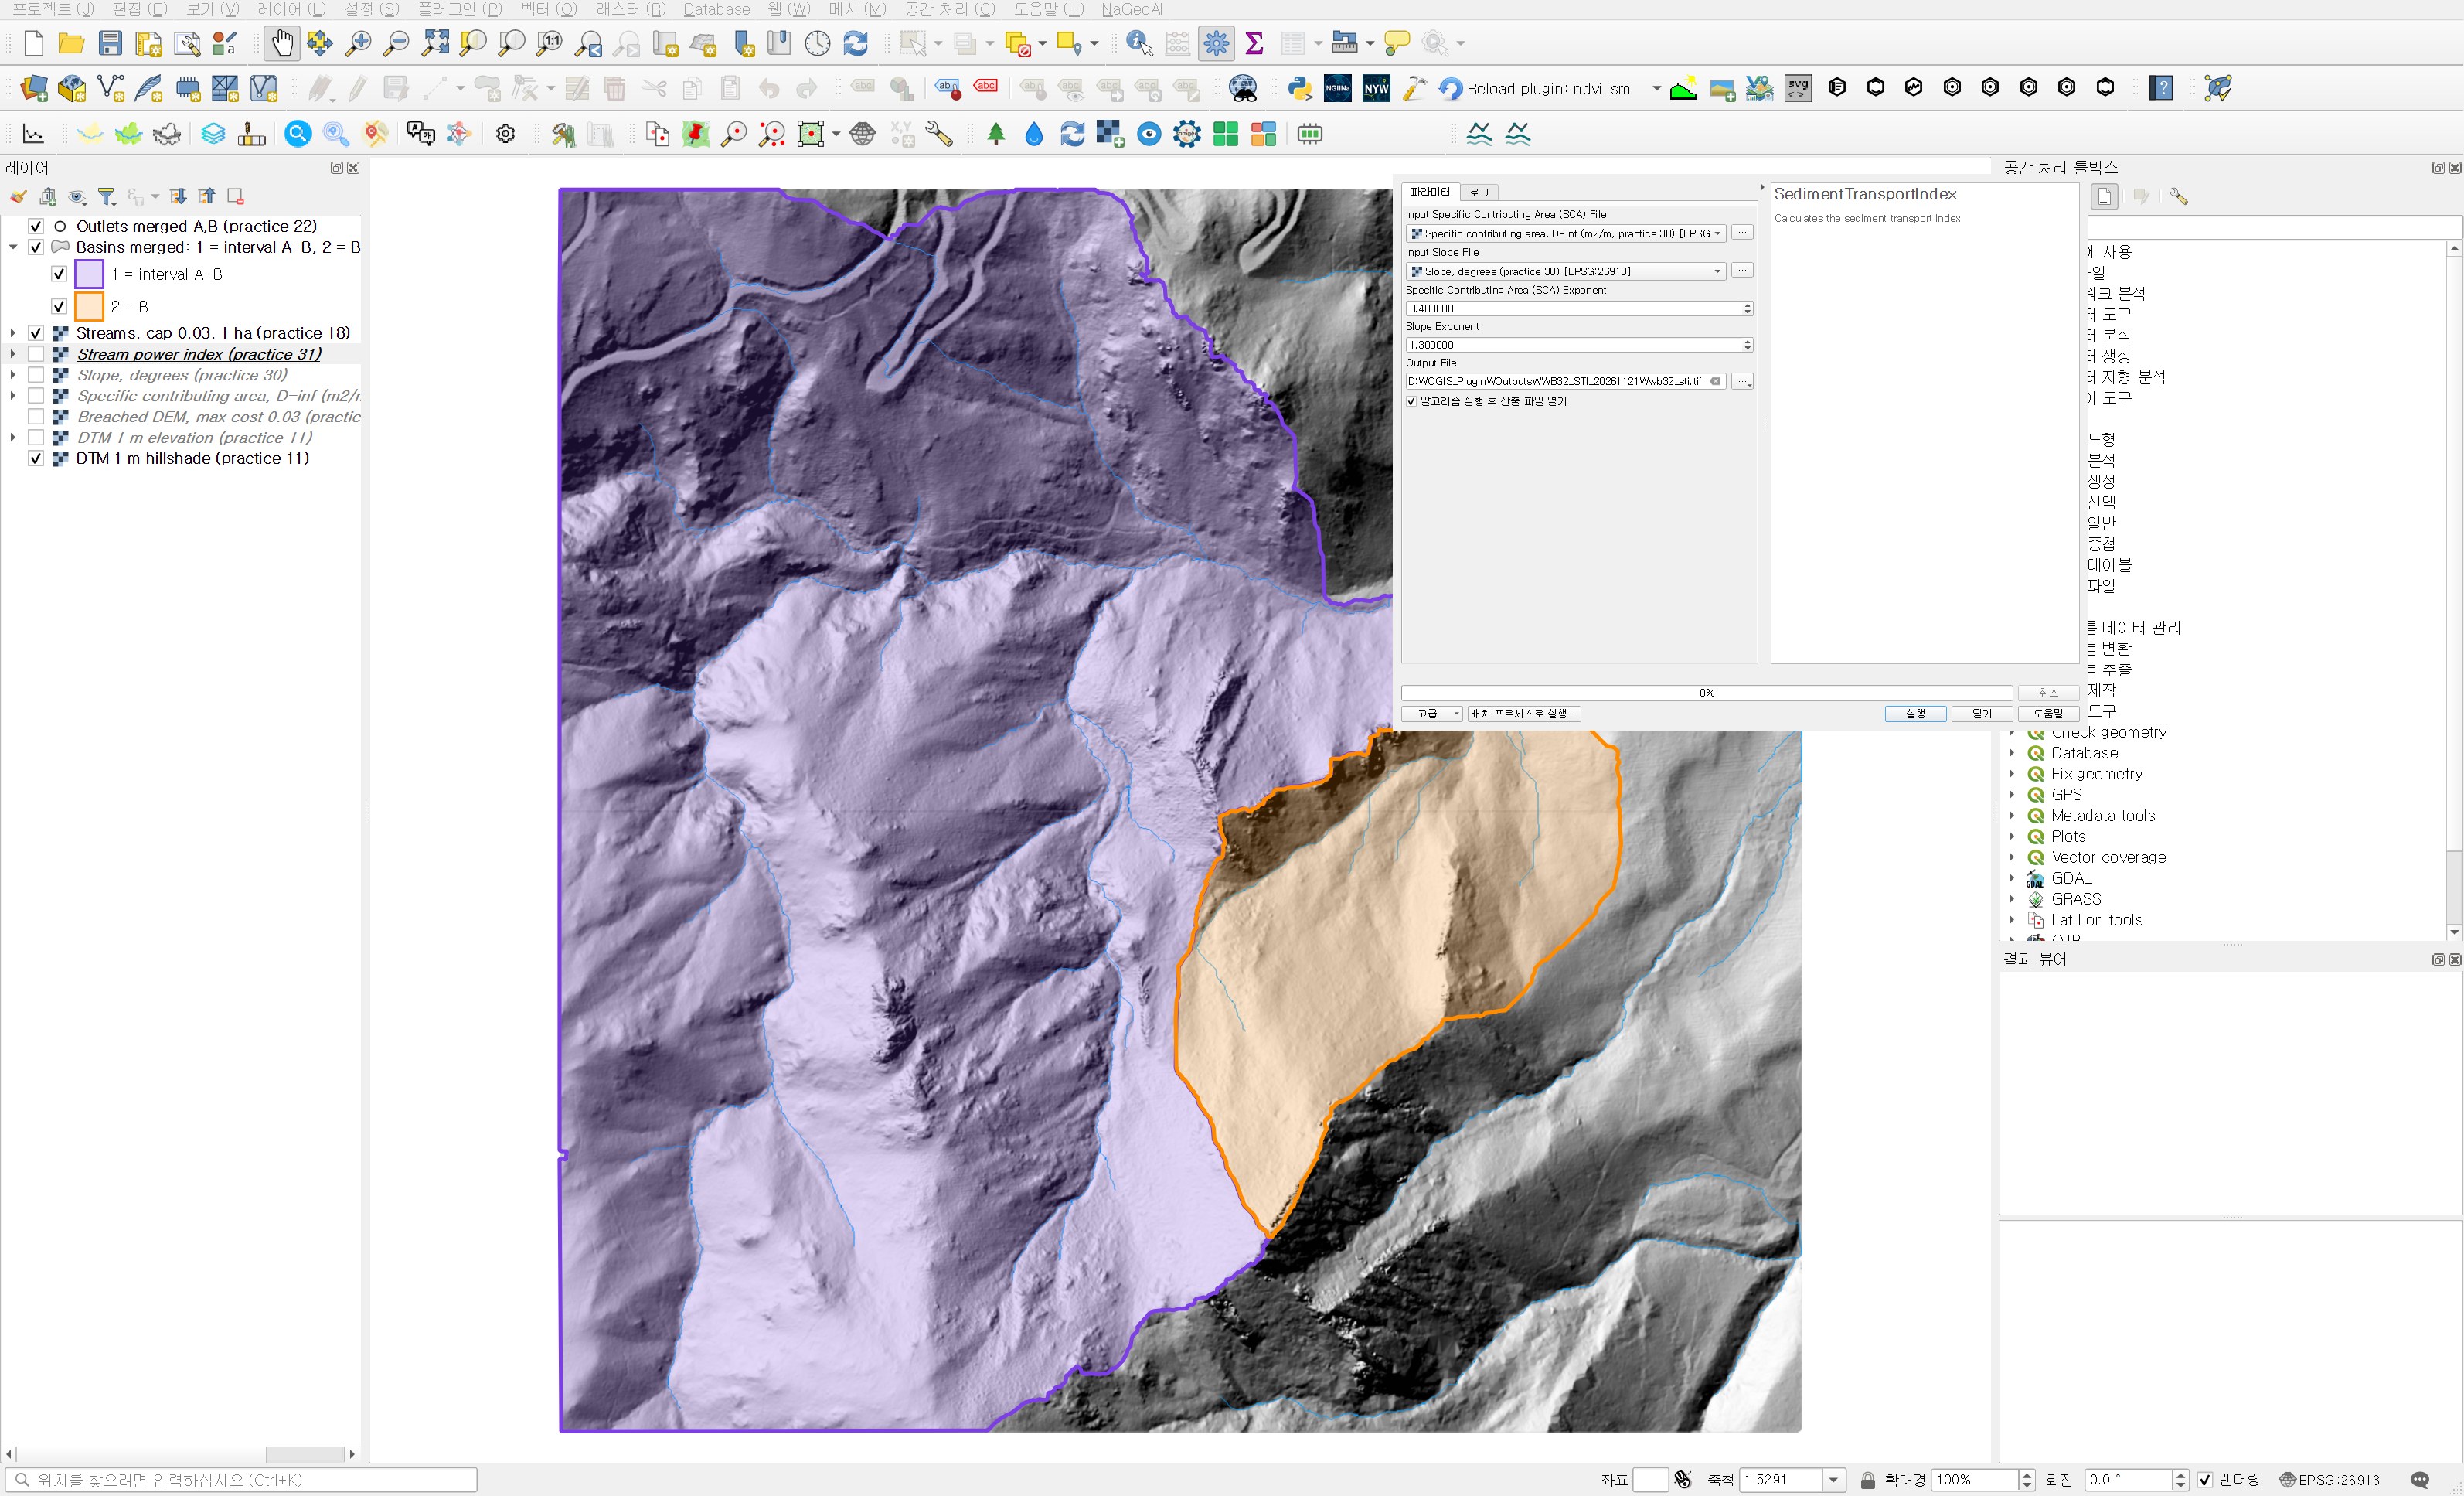
QGIS SedimentTransportIndex 대화상자. Input Specific Contributing Area (SCA) File은 Specific contributing area, D-inf (m2/m, practice 30), Input Slope File은 Slope, degrees (practice 30), SCA Exponent는 0.400000, Slope Exponent는 1.300000, 출력은 WB32_STI_20261121 폴더의 wb32_sti.tif다. 뒤 지도에는 음영기복 위에 연보라 중간유역과 주황 B 유역이 칠해져 있다.
그림 1. SedimentTransportIndex 대화상자. 30편의 SCA와 경사를 넣고 두 지수는 기본값으로 두었다.

Whitebox 도움말에는 식이 적혀 있지 않아서, 출력이 위 식과 맞는지 numpy로 다시 계산해 봤다. (n+1) 계수가 붙은 꼴과 유효 셀 전체에서 상대 차이 6×10⁻⁸ 이내로 맞았다. 계수를 빼면 모든 셀이 정확히 1/1.4배가 되니, 다른 프로그램의 LS와 견줄 때는 이 1.4배부터 확인해야 한다.

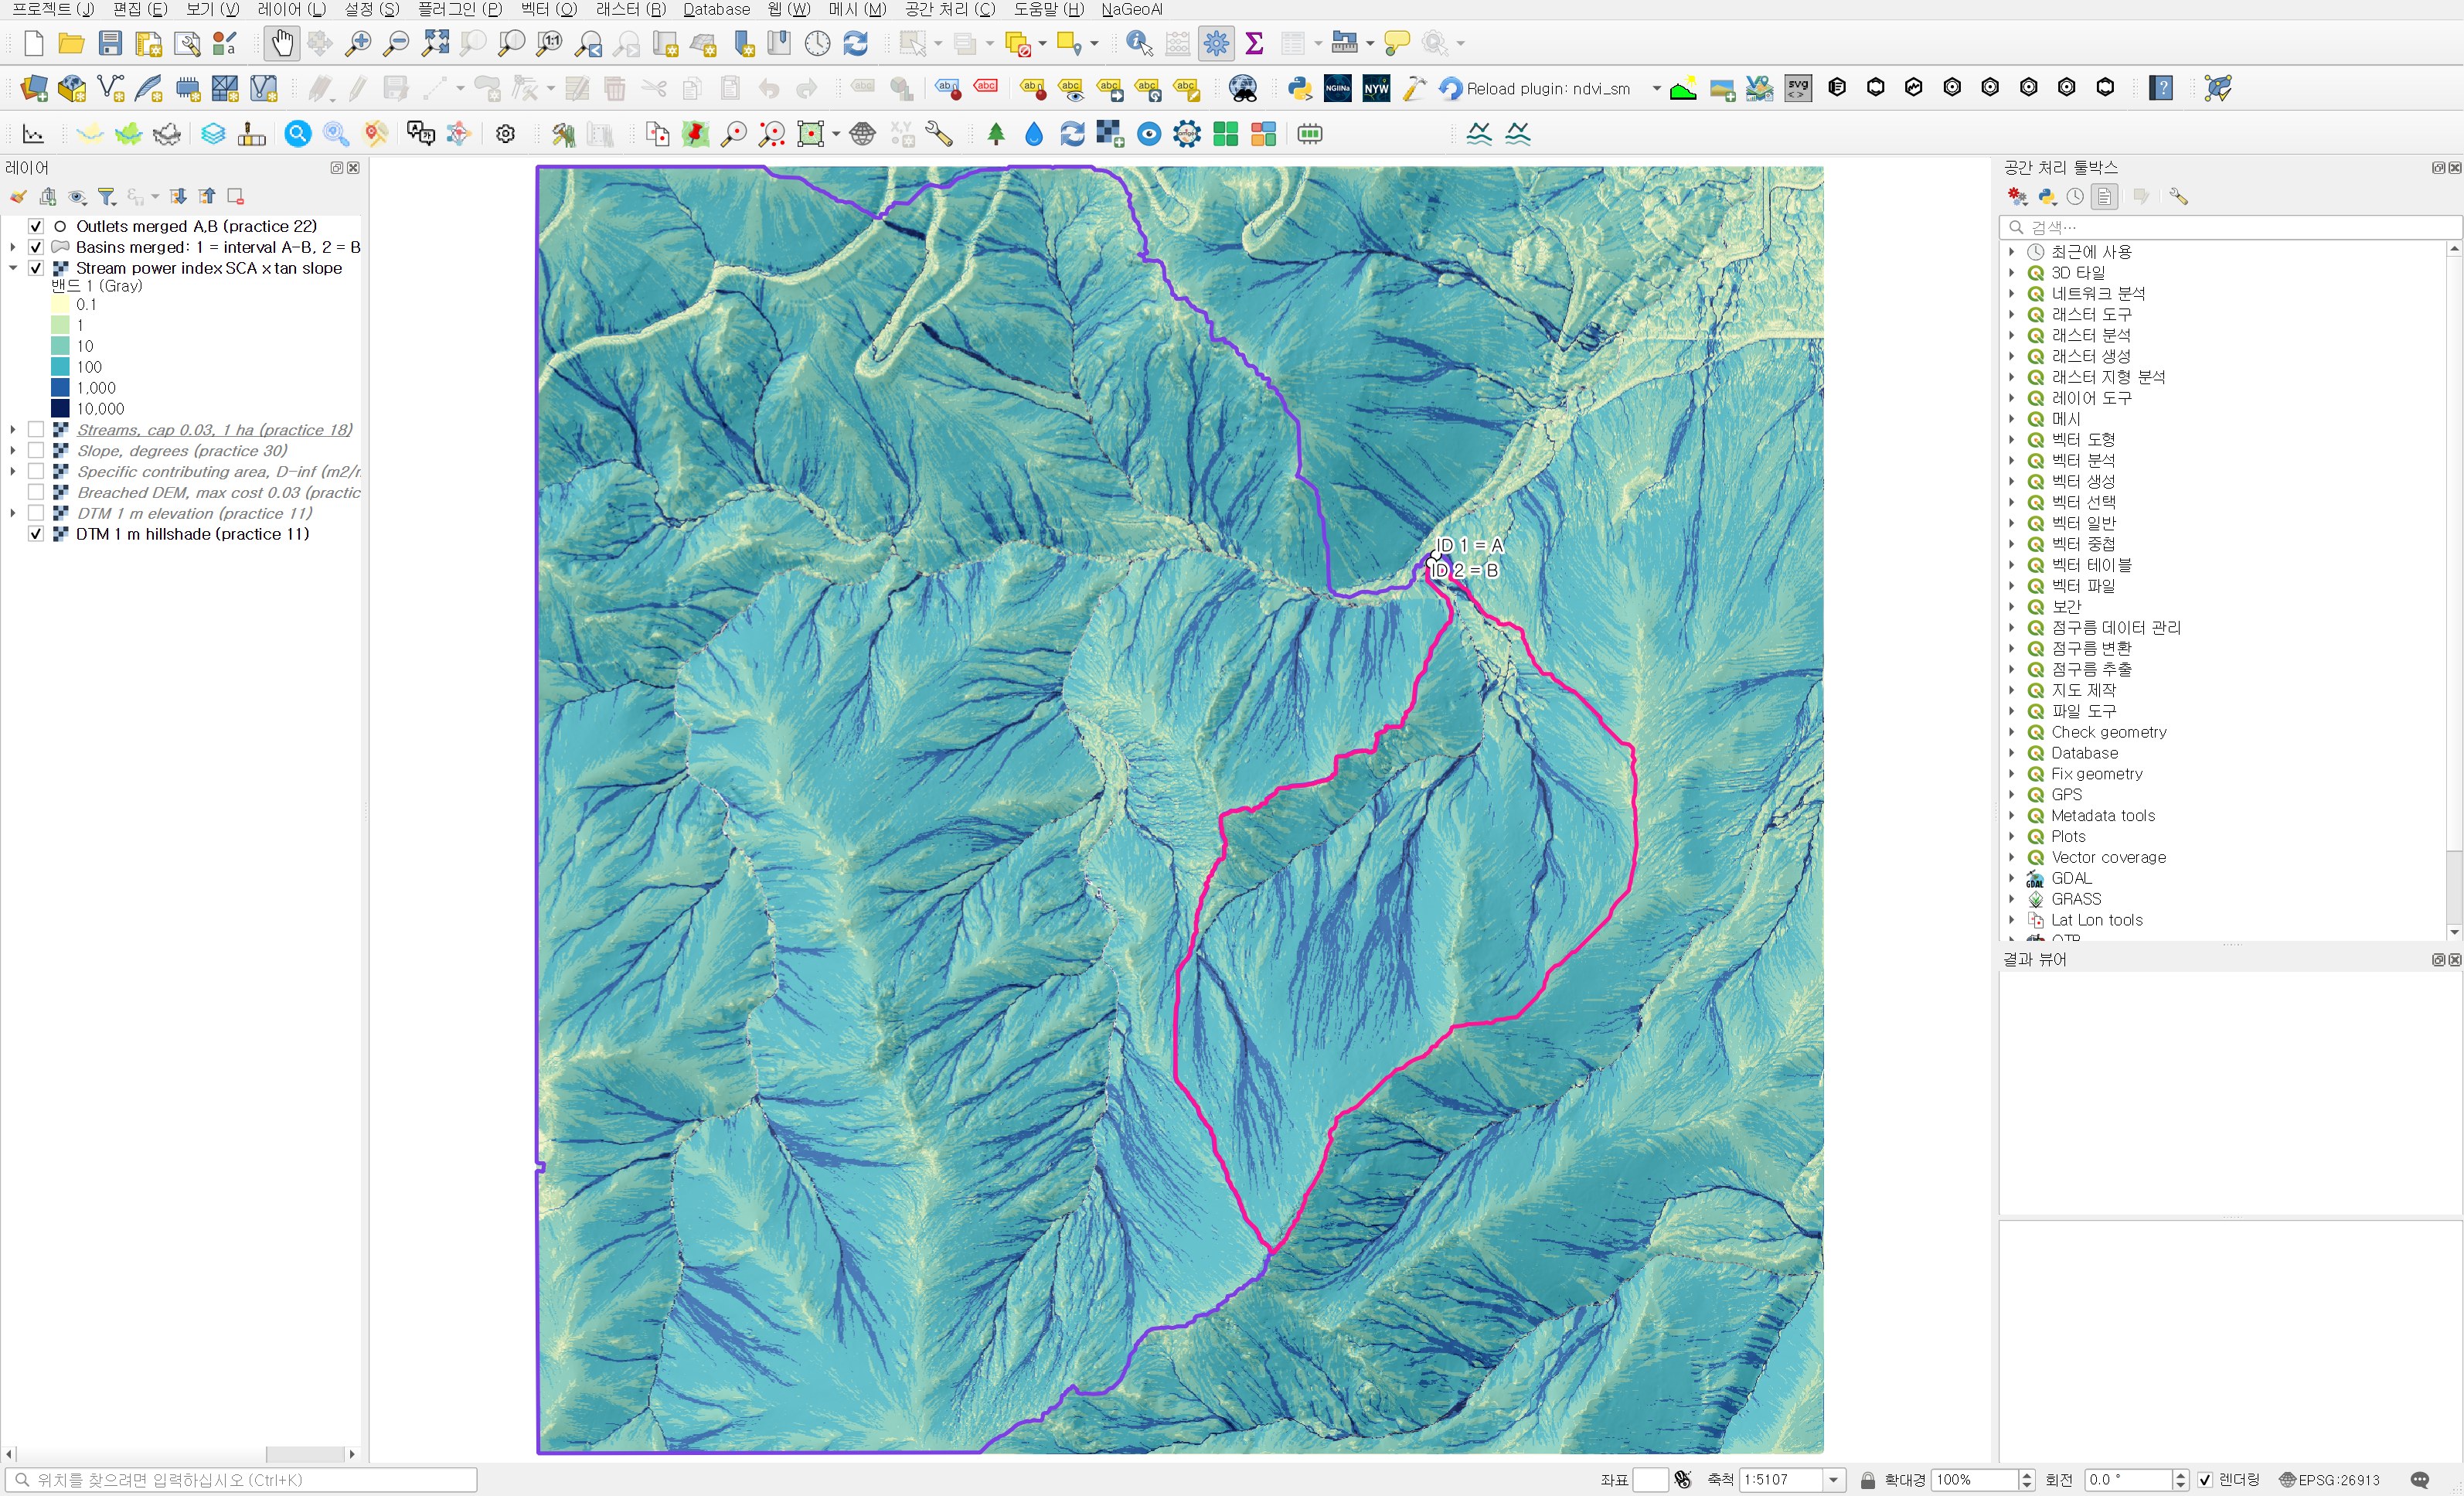
값의 범위부터 31편과 다르다. STI는 0.0004부터 1,870까지이고 중앙값 12.8, 99백분위 73.0이다. SPI가 170만까지 열 자리 가까이 퍼졌던 것과 비교하면 꼬리가 크게 짧아졌다. 지도는 0.5, 2, 5, 10, 20, 50, 100을 경계로 한 단계 색으로 칠했다. 범례 값은 구간의 위쪽 끝이다.
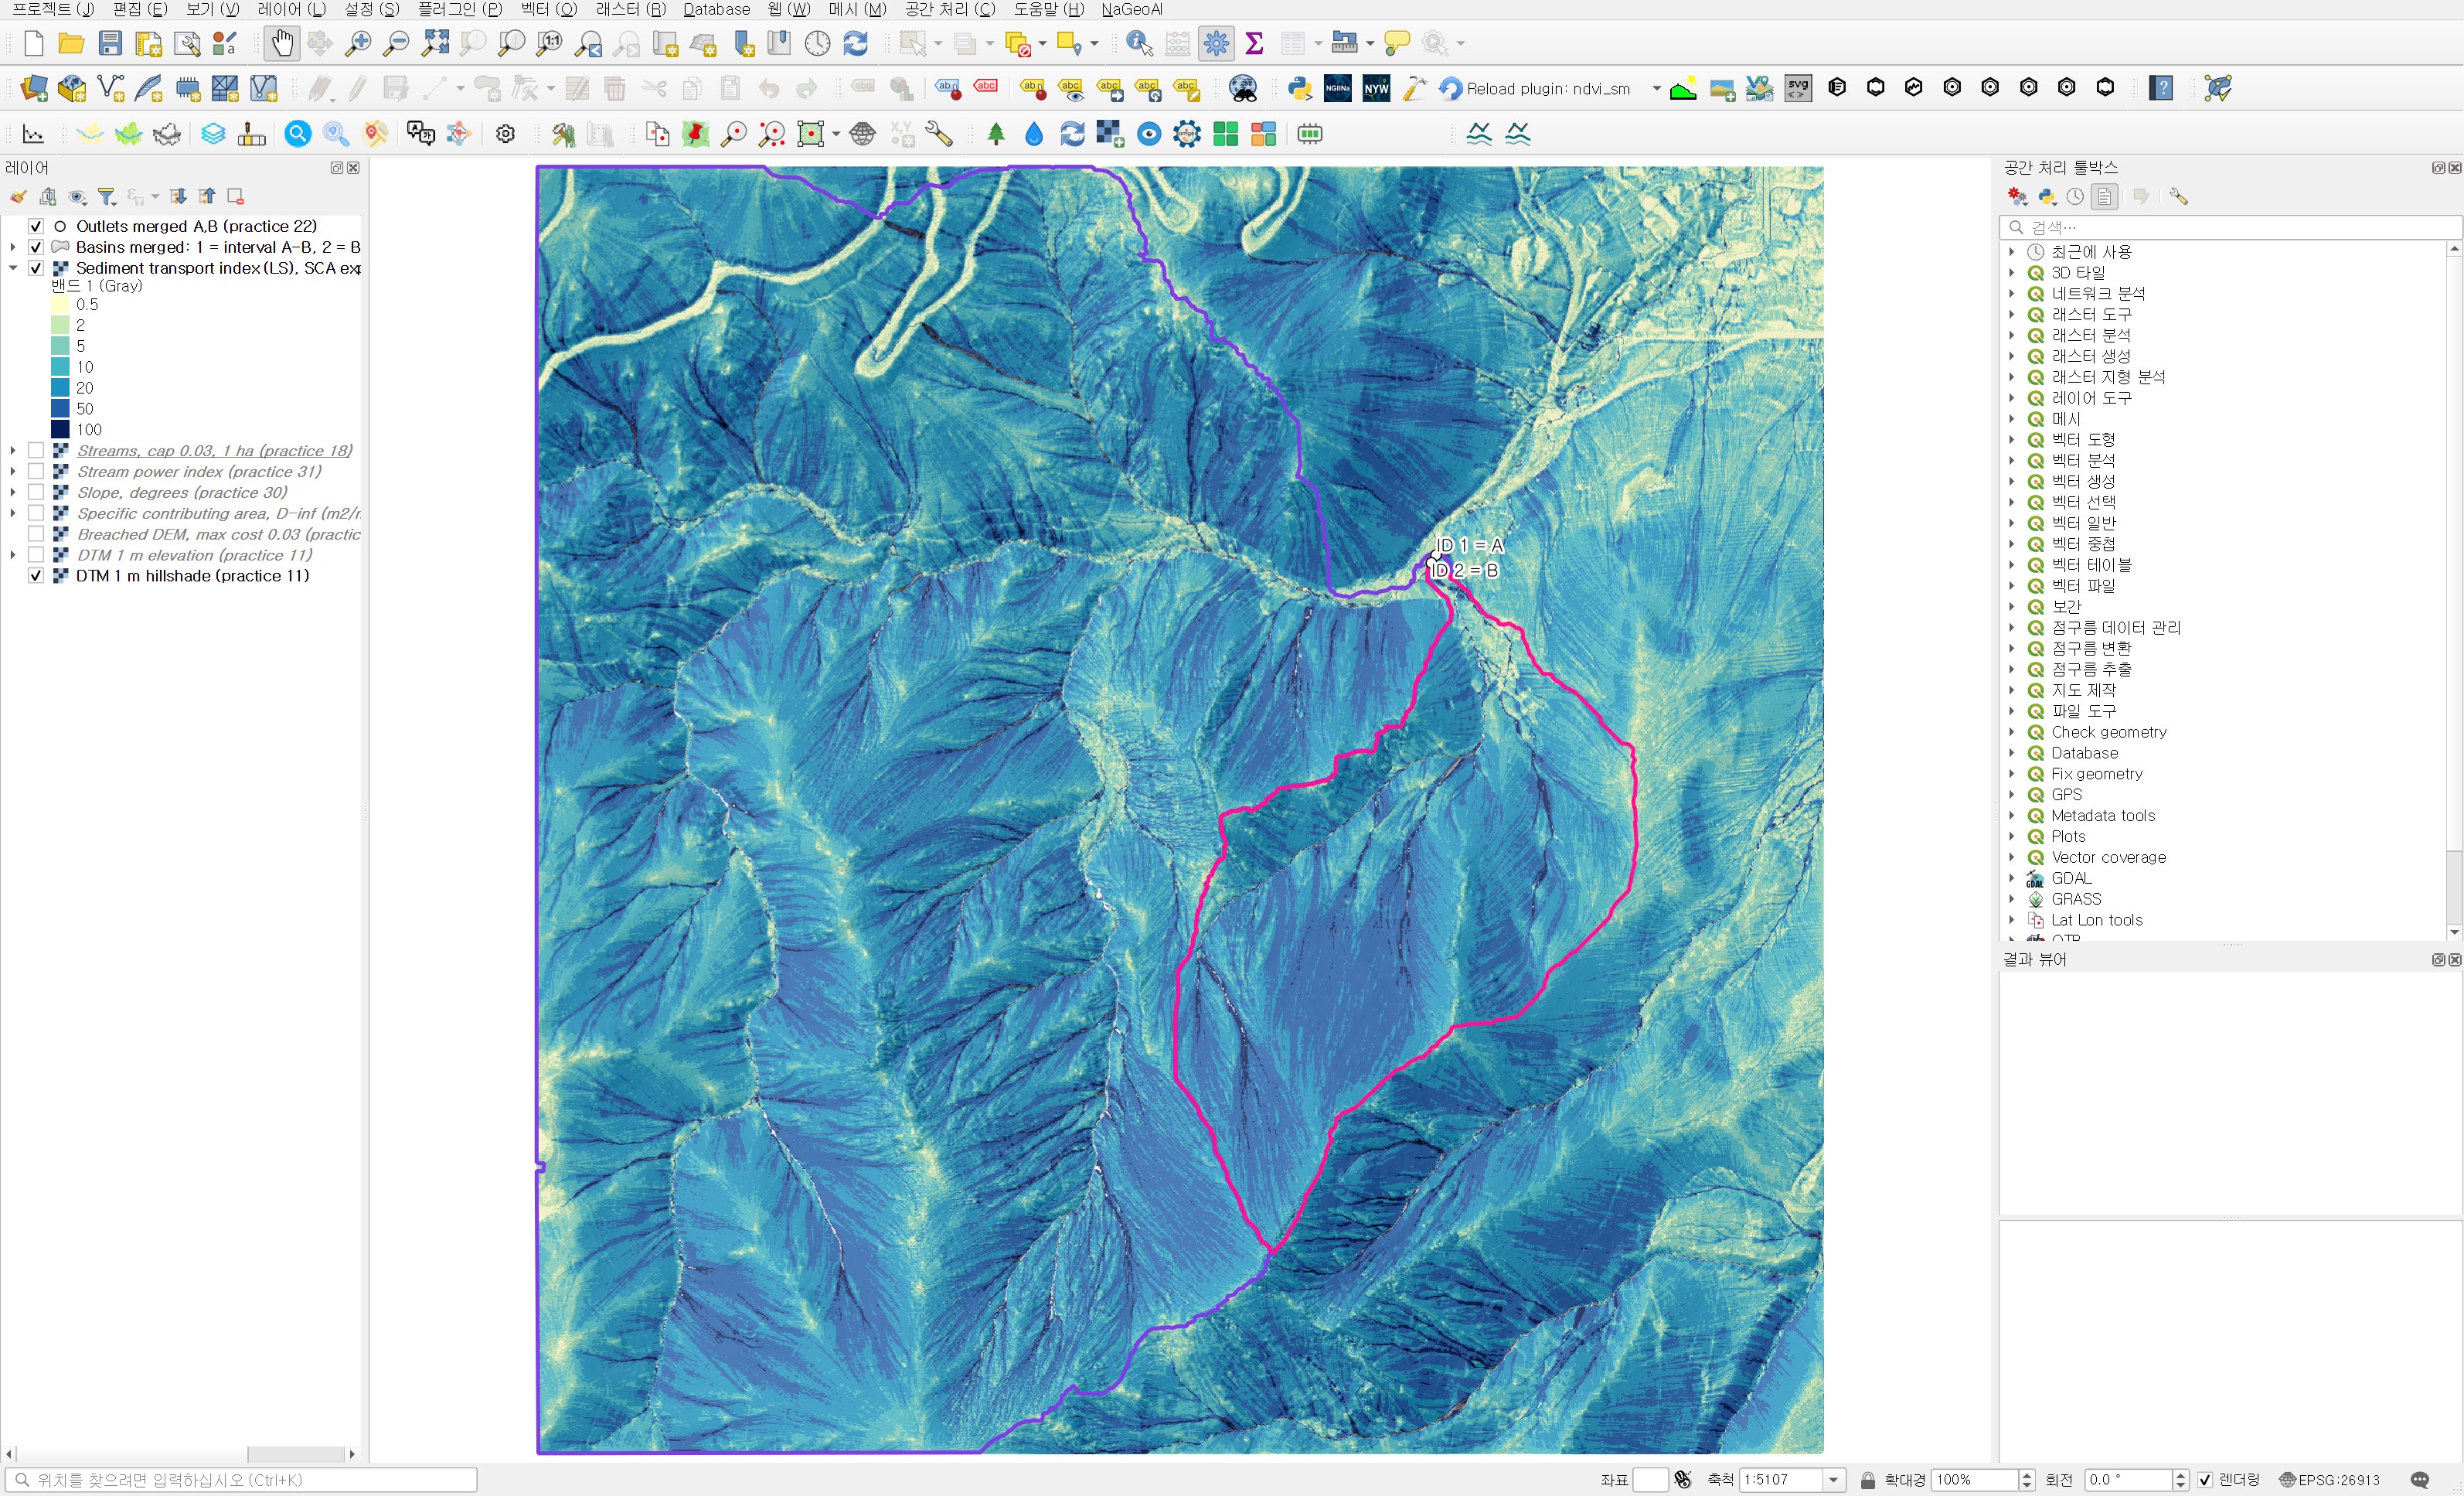
유사이송지수 지도. 범례는 0.5 연노랑, 2 연두, 5 민트, 10 청록, 20 하늘색, 50 파랑, 100 남색이다. 능선과 넓은 골짜기 바닥은 연노랑과 연두, 사면 대부분은 청록과 파랑이고 가파른 사면 골을 따라 남색 줄이 나뭇가지처럼 뻗는다. 보라 선은 중간유역, 분홍 선은 B 유역 경계이고 위쪽 가운데에 ID 1 = A, ID 2 = B 유출구 표시가 있다.
그림 2. 유사이송지수(SCA 지수 0.4, 경사 지수 1.3).

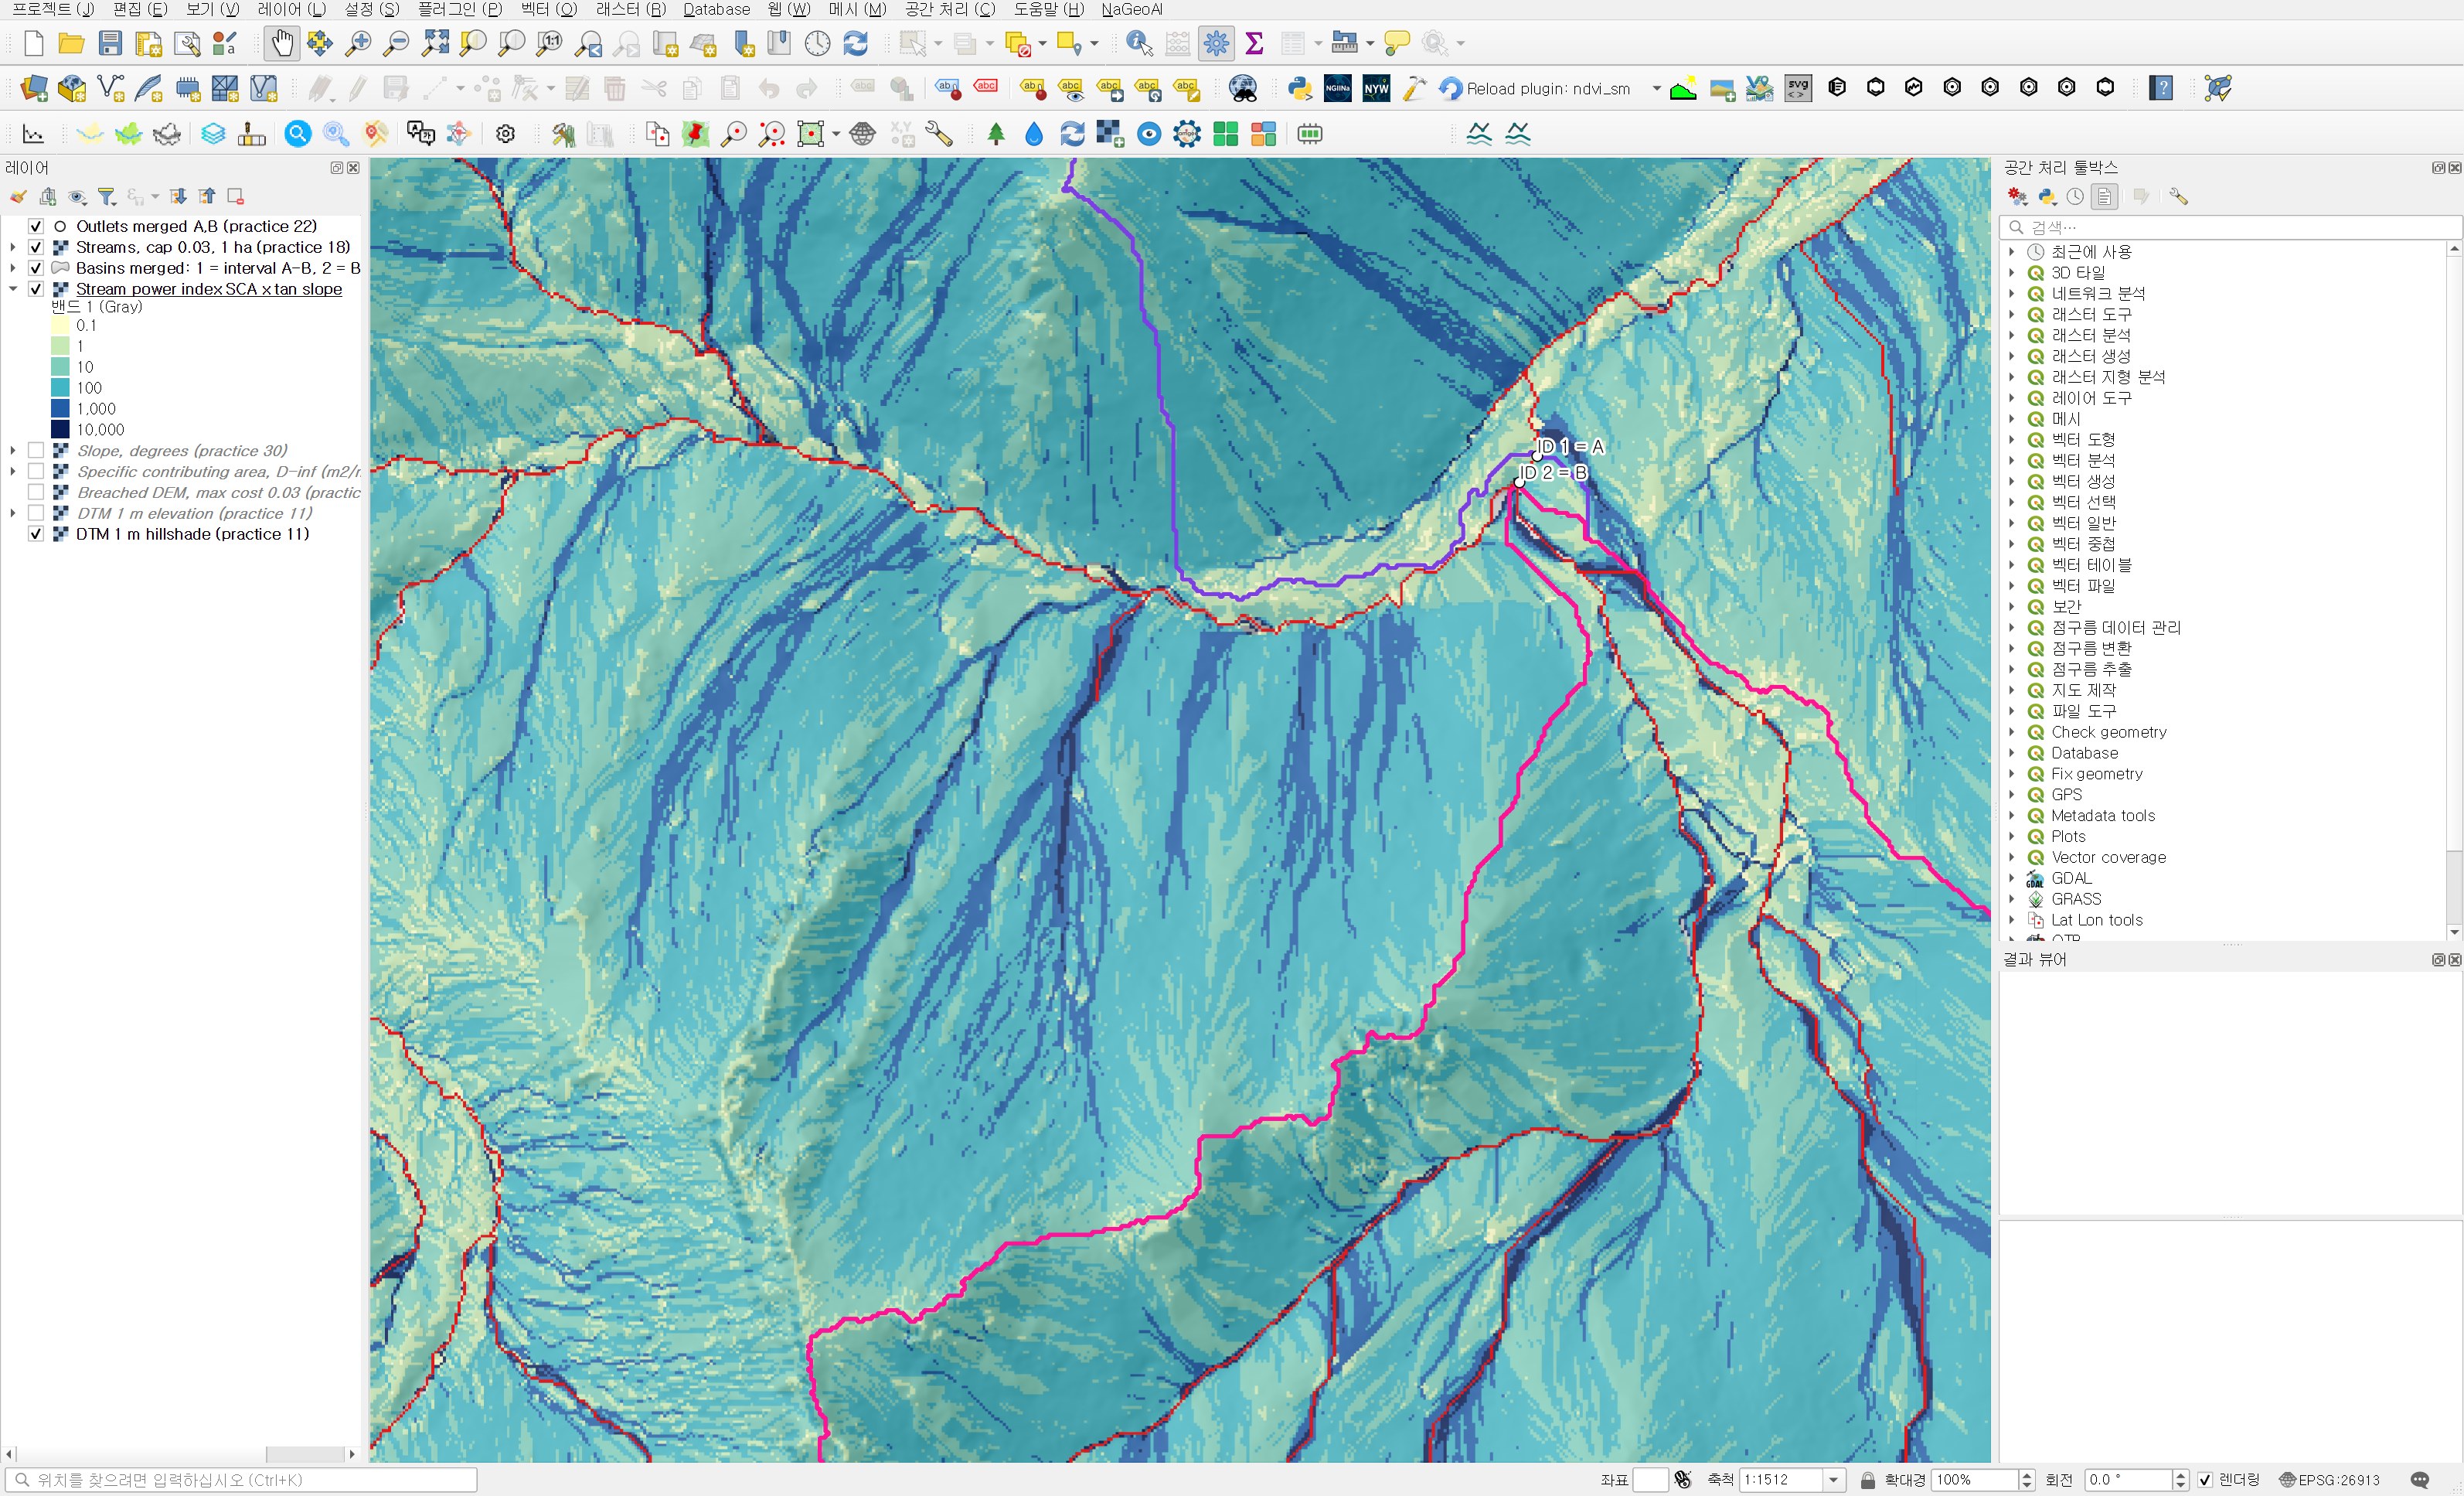
31편 SPI 지도와 셀 순위를 맞대 보면 스피어만 순위상관이 0.908이다. 크게는 같은 곳을 높게 보지만 순서가 꽤 바뀐다. 유출구 쪽을 확대하면 어디서 바뀌는지 보인다.
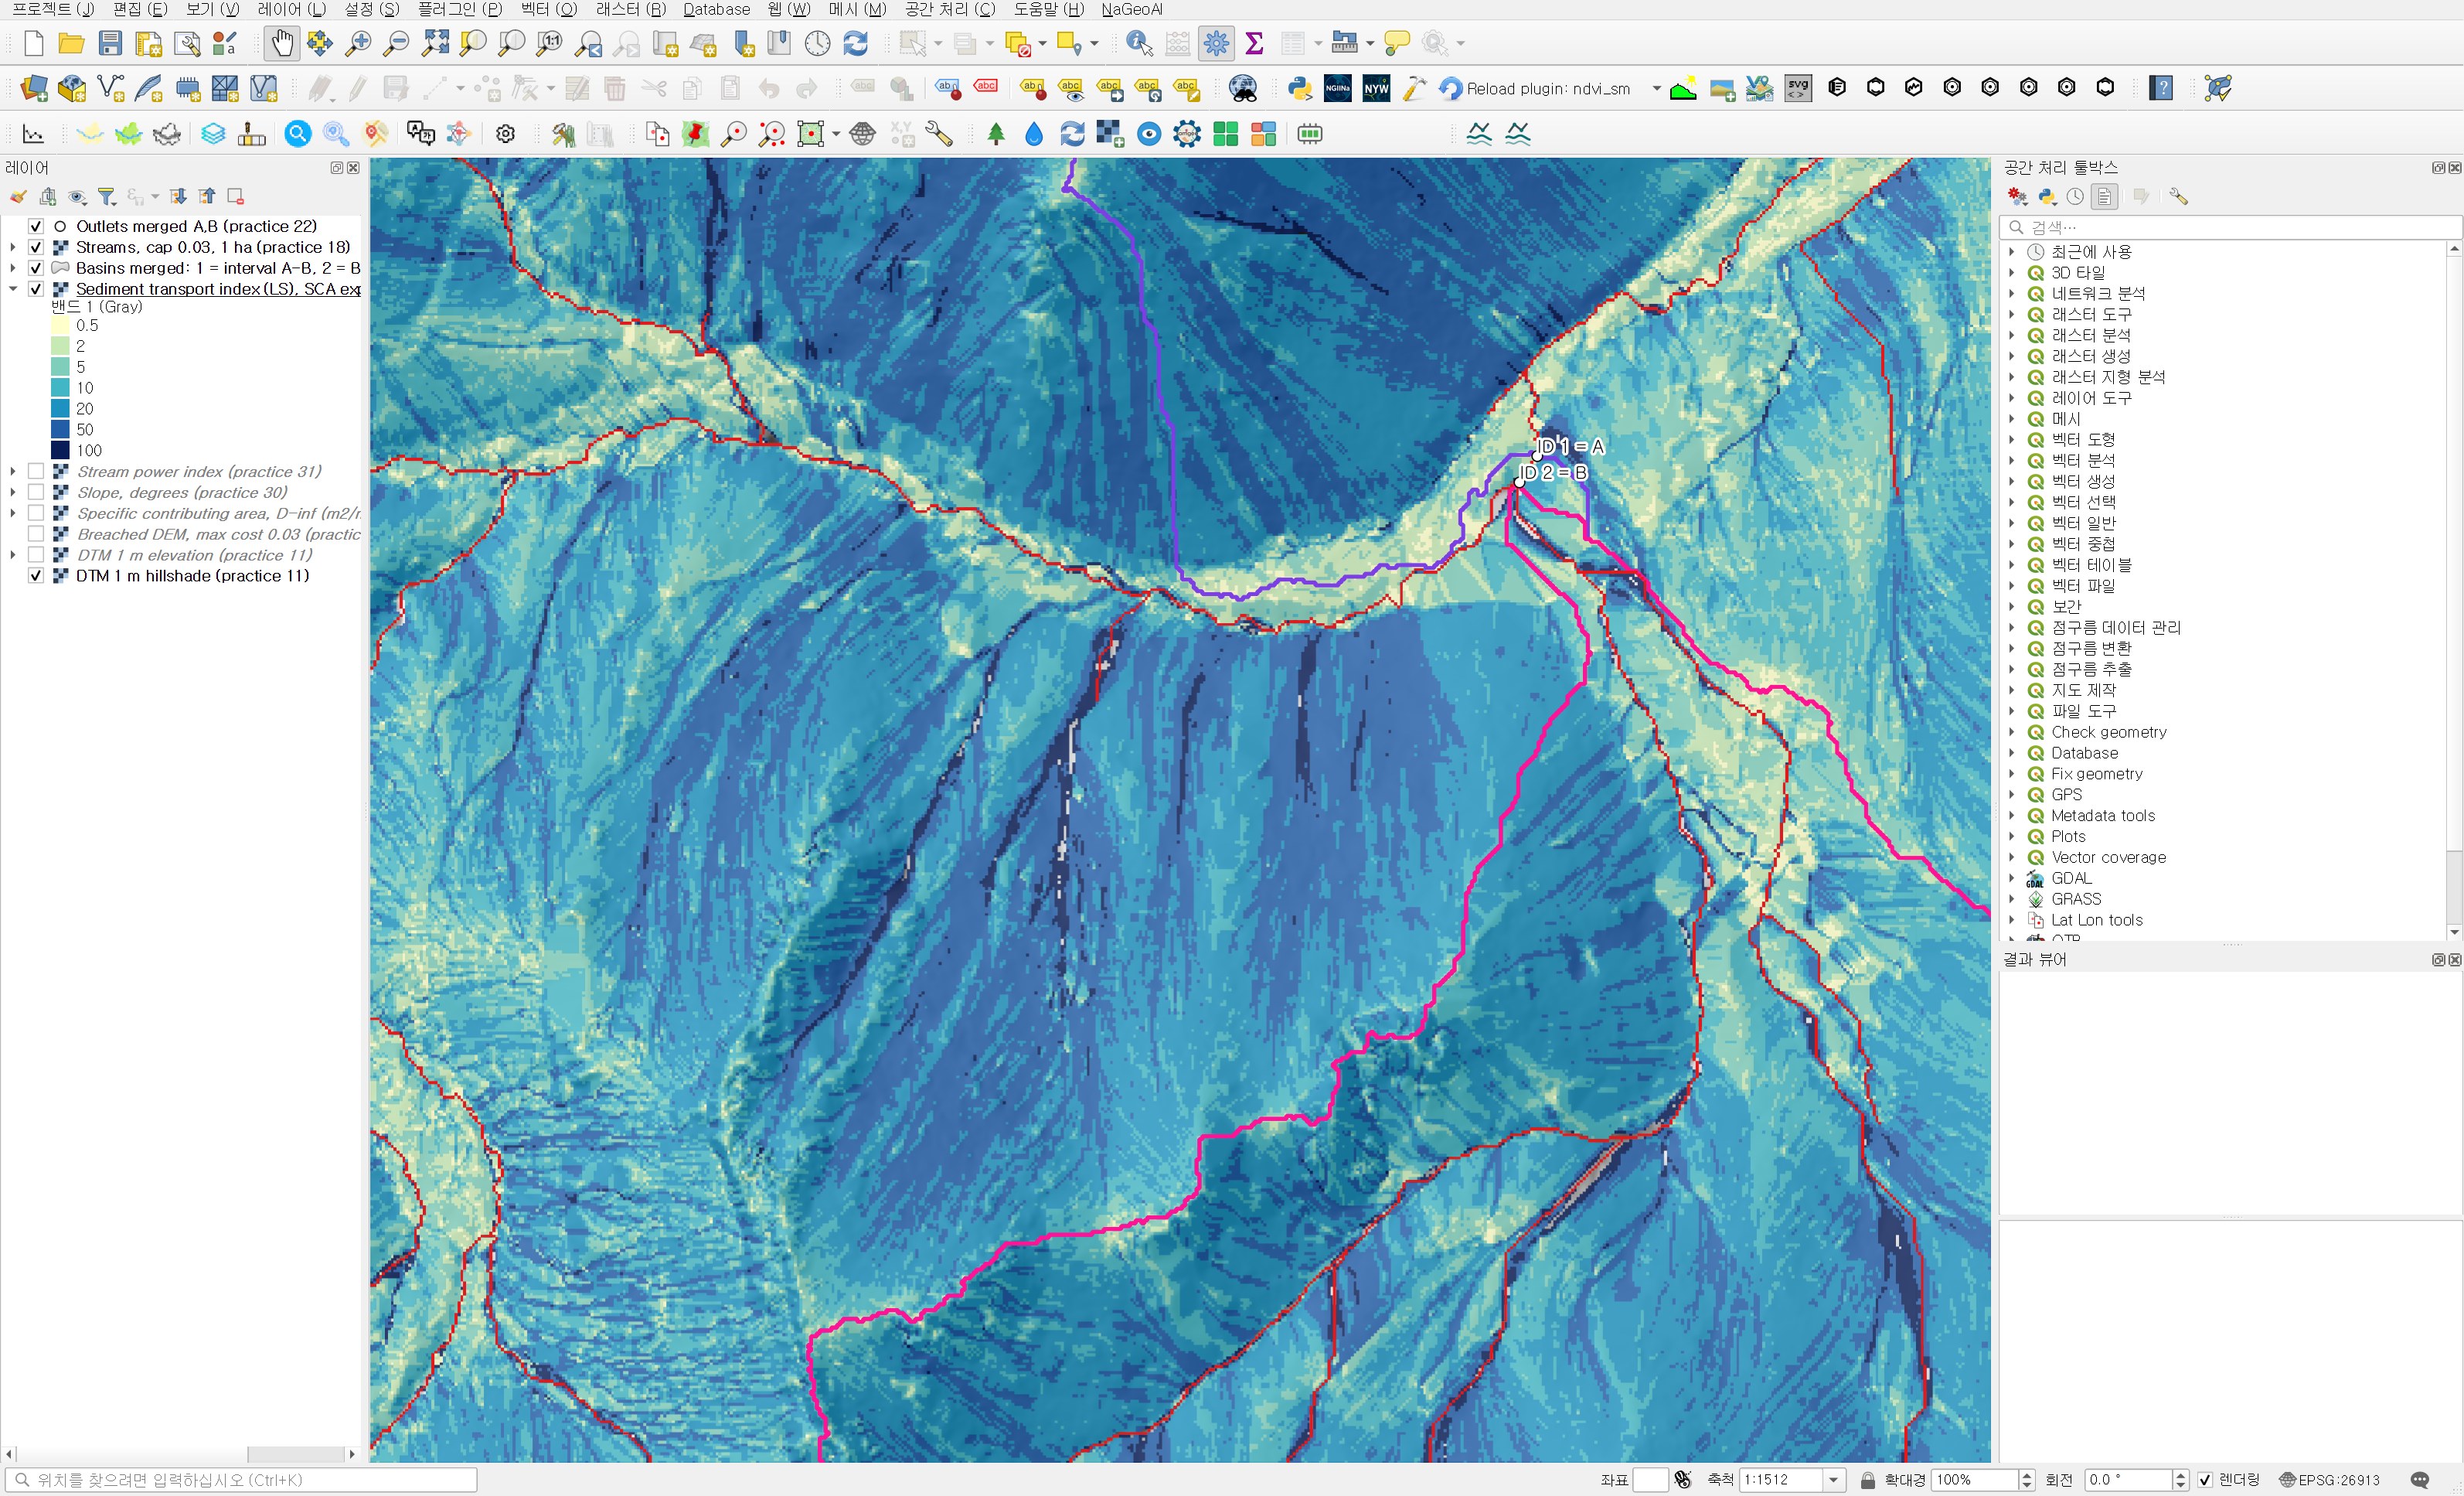
유출구 부근 확대 지도. 유사이송지수 단계 색 위에 빨간 하천선과 보라 중간유역, 분홍 B 유역 경계가 겹쳐 있다. 유출구에서 오른쪽 위로 이어지는 넓은 골짜기 바닥은 연노랑과 연두로 낮고, 그 옆 사면과 가파른 사면 골은 파랑과 남색이다. 오른쪽 위에 ID 1 = A, ID 2 = B 유출구 표시가 있다.
그림 3. 유출구 부근 확대(축척 약 1:1,500). 빨간 선이 1 ha 기준 하천이다.

유출구 쪽 넓은 골짜기 바닥이 연노랑, 연두로 낮게 나온다. SPI에서는 이 본류 셀들이 집수면적 덕에 최상위였는데, STI에서는 집수면적이 0.4제곱으로 눌리고 바닥의 완만한 경사가 1.3제곱으로 깎이면서 순위가 내려갔다. 반대로 가파른 사면과 사면 골은 경사 몫이 커서 SPI 때보다 상대적으로 올라온다. 하천 셀 전체로 보면 STI 중앙값이 중간유역 117.6, B 80.1로 여전히 사면보다 높지만, 31편처럼 수천~수만 단위로 튀지는 않는다.

2단계: 유역별 구역통계

공간 처리 툴박스 → 래스터 분석 → 구역통계(Zonal statistics)에 26편 병합 폴리곤과 STI를 넣었다. 접두어 sti_, 통계는 31편과 같이 개수, 평균, 중앙값, 표준편차, 최소, 최대다. 출력은 wb32_basin_sti_stats.shp.
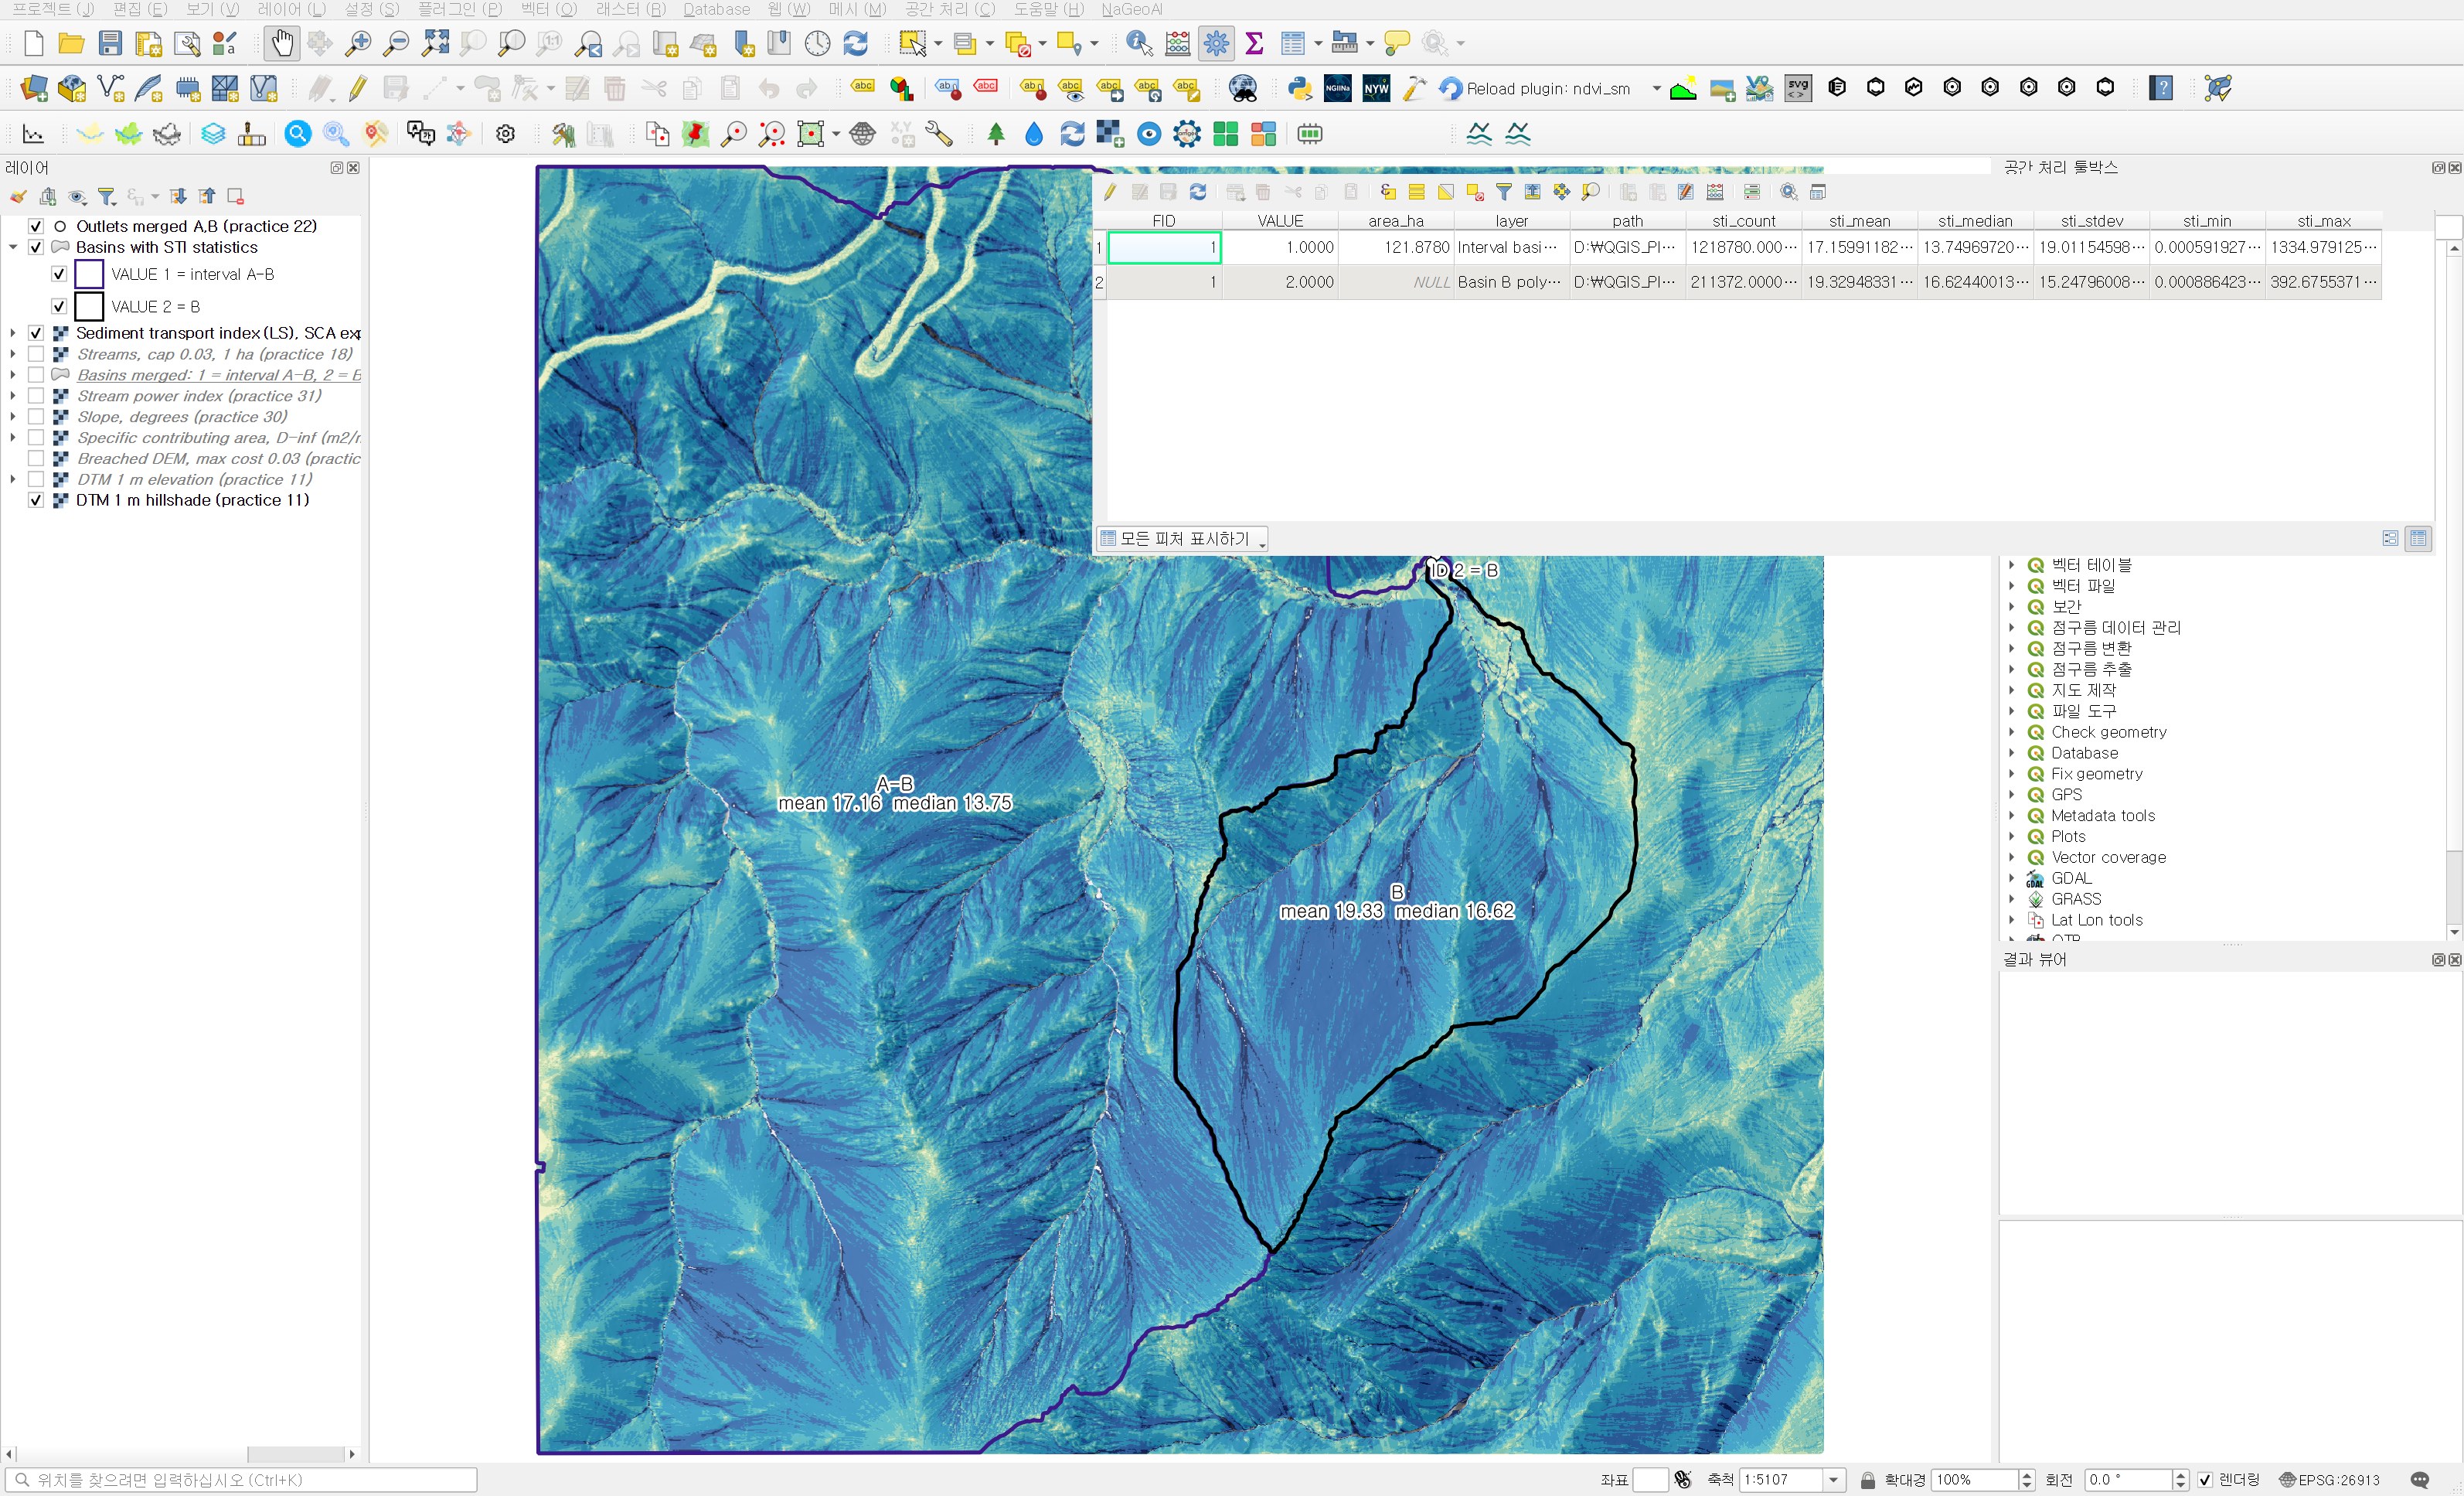
구역통계 속성 테이블. VALUE 1 행은 sti_count 1218780, sti_mean 17.15991182, sti_median 13.74969720, sti_stdev 19.01154598, sti_min 0.000591927, sti_max 1334.979125이고 VALUE 2 행은 sti_count 211372, sti_mean 19.32948331, sti_median 16.62440013, sti_stdev 15.24796008, sti_min 0.000886423, sti_max 392.6755371이다. 뒤 지도에는 유역 안에 A-B mean 17.16 median 13.75, B mean 19.33 median 16.62 라벨이 있다.
그림 4. 구역통계 결과 표와 유역 라벨.
항목중간유역 A−B유역 B
셀 수(m²)1,218,780211,372
평균17.1619.33
중앙값13.7516.62
표준편차19.0115.25
최댓값1,335.0392.7
10 / 90백분위5.38 / 29.496.20 / 33.49
기하평균12.8215.15

이번에는 평균, 중앙값, 기하평균, 10·90백분위 모두 B가 크다. 31편에서 평균만 순서가 뒤집혔던 일이 사라졌다. 표준편차도 평균과 비슷한 크기로 내려왔다(SPI는 평균의 17배와 8.5배였다).

본류 쏠림이 어디로 갔나

31편과 같은 방식으로 값을 큰 순서로 세워 상위 1% 셀을 따로 떼어 봤다.

항목중간유역 A−B유역 B
상위 1% 셀이 합계에서 차지하는 비율, SPI(31편)83.4%58.1%
상위 1% 셀이 합계에서 차지하는 비율, STI8.4%5.8%
상위 1% 셀을 뺀 STI 평균15.8718.39
평균 ÷ 중앙값, SPI(31편)17.46.2
평균 ÷ 중앙값, STI1.251.16
하천 밖 셀 STI 중앙값13.7016.55

SPI에서 셀 1%가 합계의 83%를 쥐고 있던 중간유역이 STI에서는 8.4%다. 상위 1%가 전체 셀 비율의 8배 남짓을 차지하는 정도라 평균이 분포 가운데에서 크게 벗어나지 않는다. 평균과 중앙값의 비가 1.25와 1.16이니 이번에는 평균을 대표값으로 써도 판단이 틀어지지 않는다.
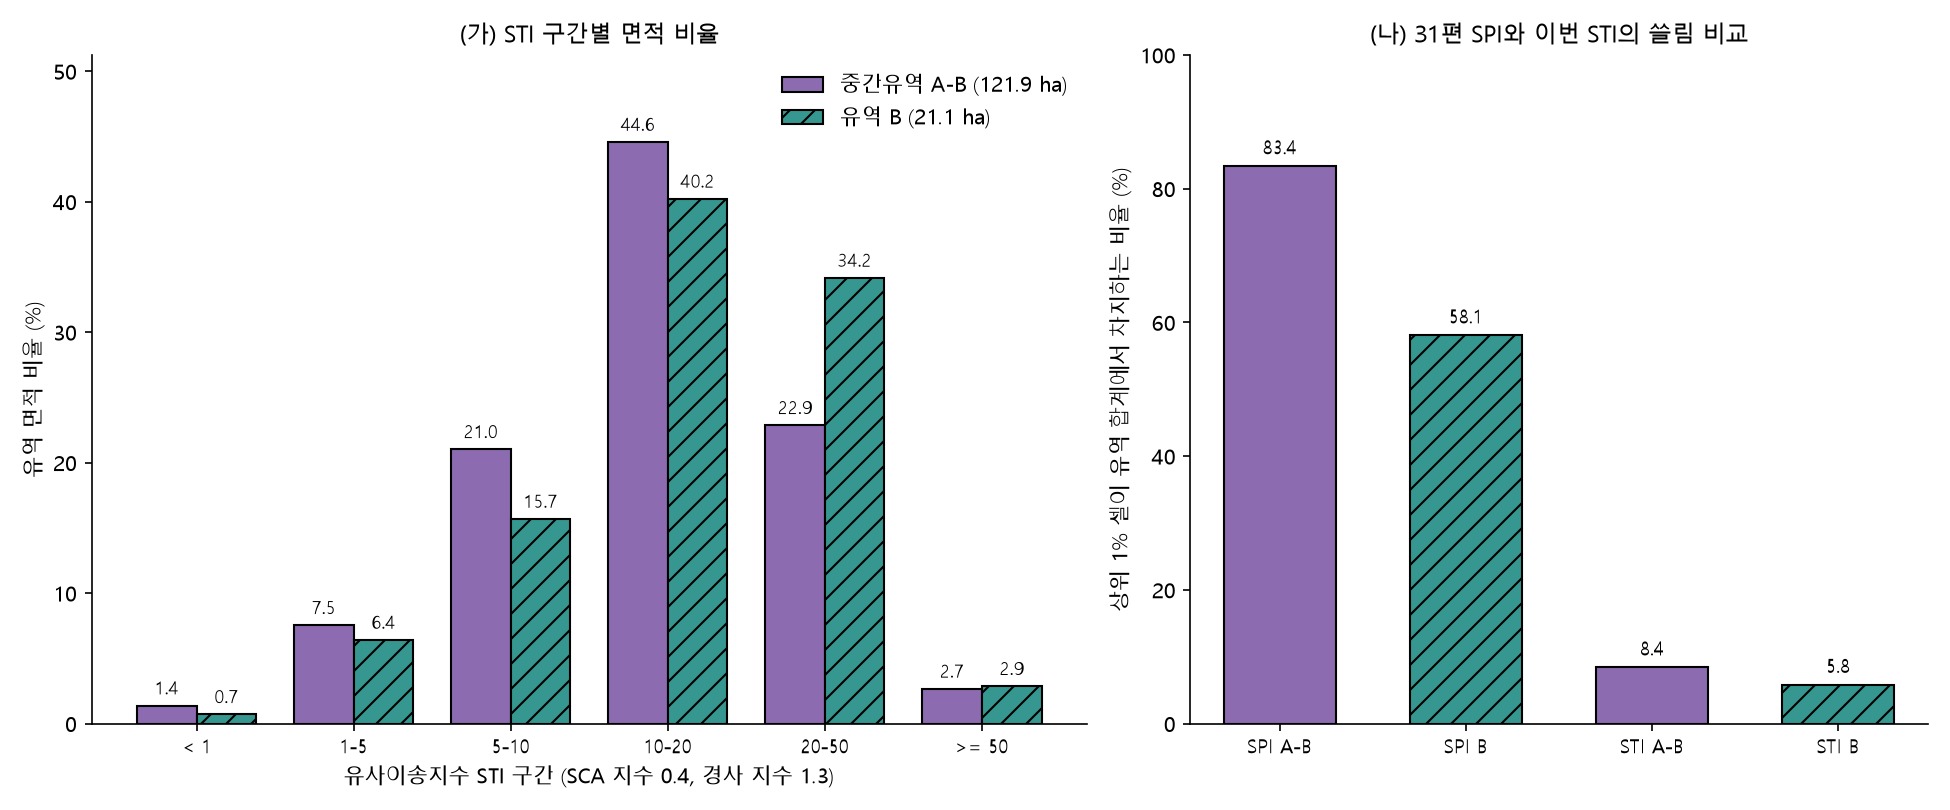
두 개의 패널로 된 막대그래프. 왼쪽 (가)는 STI 구간별 면적 비율로, 중간유역 A-B(보라)와 B(청록 빗금)가 1 미만 1.4와 0.7, 1-5 7.5와 6.4, 5-10 21.0과 15.7, 10-20 44.6과 40.2, 20-50 22.9와 34.2, 50 이상 2.7과 2.9퍼센트다. 오른쪽 (나)는 상위 1% 셀이 유역 합계에서 차지하는 비율로 SPI A-B 83.4, SPI B 58.1, STI A-B 8.4, STI B 5.8퍼센트다.
그림 5. (가) STI 구간별 면적 비율, (나) 31편 SPI와 이번 STI의 상위 1% 셀 비중.

그림 5 (가)를 보면 차이는 20~50 구간에서 난다. B는 유역 면적의 34.2%가 이 구간인데 중간유역은 22.9%다. 대신 중간유역은 5~10 구간이 21.0%로 B(15.7%)보다 많다. B 사면 전체가 한 단계 위로 올라가 있는 모양이고, 31편에서 SPI 하천 밖 셀 중앙값이 B 쪽에서 높았던 것과 같은 그림이다.

무엇이 B를 올렸나

ln STI = ln 1.4 + 0.4(ln SCA − ln 22.13) + 1.3(ln sin β − ln 0.0896)이므로, 기하평균의 차이는 SCA 항과 경사 항으로 나뉜다.

  • SCA 항: 0.4 × (3.7625 − 3.2619) = +0.200
  • 경사 항: 1.3 × (−0.7853 − (−0.7596)) = −0.034
  • 합 0.167, 기하평균 비 15.15 / 12.82 ≈ 1.18배

ln SCA 평균의 차이 0.500은 30편, 31편과 같은 값이다. 바뀐 것은 앞에 붙는 계수다. SPI에서는 1이 곱해져 0.500이 그대로 들어갔고, STI에서는 0.4가 곱해져 0.200으로 줄었다. 경사는 두 유역 평균이 30.3°와 29.5°로 거의 같아서 경사 항은 이번에도 작고, 1.3제곱 때문에 B 쪽을 조금 깎는다. 결국 B가 앞서는 이유는 31편과 같다. B 사면 셀이 위에서 받는 면적이 평균적으로 더 많다. 다만 그 효과가 줄어든 대신 본류 셀의 극단값도 같이 눌려서, 평균이 그 차이를 그대로 보여 주게 됐다.

현장 판단으로 옮기면 31편의 해석이 한쪽으로 정리된다. 사면 침식과 토사 유출을 먼저 볼 곳은 B다. 본류 하상 세굴은 STI가 아니라 SPI나 하천 수리 계산으로 봐야 할 문제다. 이 역시 지형 지수만으로 한 해석이고 실제 유실량으로 확인한 것은 아니다.

독립 계산으로 확인

  • numpy로 1.4 × (SCA/22.13)0.4 × (sin β/0.0896)1.3을 다시 계산해 Whitebox 출력과 비교했다. 유효 2,248,166 셀에서 절대 차이 최대 5.1×10⁻⁵, 상대 차이 최대 6.0×10⁻⁸, 10⁻⁵을 넘는 셀 0개.
  • 출력 STI는 EPSG:26913, 1,500×1,500 셀, float32, NoData −32768 1,834 셀로 입력 SCA·경사·SPI·DEM과 격자가 같고 NoData 셀 수도 DEM과 같다. 값이 0인 셀은 없다.
  • 구역통계 여섯 항목을 셀 중심으로 래스터화한 유역 마스크로 다시 계산하면 두 유역 모두 차이가 10⁻¹³ 이하다.

실무에서 챙길 것

  • STI는 LS 인자에 해당하는 값이지 토양유실량이 아니다. 실제 유실량을 보려면 강우(R), 토양(K), 피복(C), 보전(P) 인자를 곱해야 한다. 두 유역 비교도 이 인자들이 같다고 둔 비교다.
  • USLE 계열은 사면의 면상·세류 침식을 위한 식이다. 하천 셀의 STI 값은 하상 세굴을 뜻하지 않으므로, 유역 요약에서 하천 셀을 빼거나 따로 보는 편이 맞다.
  • USLE 표준 시험구는 9% 경사인데, 이 유역의 평균 경사는 30° 안팎이다. 시험 조건에서 많이 벗어난 사면이라 절대값보다는 유역 안 상대 순위로 쓰는 게 안전하다.
  • 다른 도구의 LS와 비교할 때는 (n+1) 계수, 지수 n·m, 경사 단위(도인지 백분율인지), SCA 단위(m²/m인지 셀 수인지)를 먼저 맞춘다. 하나만 달라도 값이 몇 배씩 차이 난다.
  • SPI와 STI는 같은 재료로 다른 질문에 답한다. 본류 하나에 힘이 몰리는지 보려면 SPI, 사면 전체의 침식 잠재력을 보려면 STI가 맞다. 유역을 비교할 때 두 지수가 같은 순서를 내는지 함께 확인하면 해석이 단단해진다.

다음 회차

이번 비교는 n = 0.4, m = 1.3 한 조합에서 나왔다. n을 0.6으로 올리거나 m을 바꾼 다른 조합에서도 B가 앞서는지, 순위상관과 유역 순서가 지수에 얼마나 민감한지 다음 회차에서 확인해 보려고 한다.

작업 메모

이번 회차는 QGIS 시작 스크립트로 같은 대화상자에 값을 넣어 실행했고, 화면은 그때 캡처한 것이다. 원본 프로젝트는 그대로 두고 복사본(QGIS_Play_NaGeoAI_20261121_32_sti.qgz)에서 작업했다. 자료 출처는 USGS 3DEP(The National Map) 타일 13SDE474426이고, 원본 DTM은 재배포하지 않는다. 그림 5, 백분위, 상위 1% 비중, 기하평균과 성분 분해, 하천 셀 통계, 순위상관, 독립 계산은 출력 파일을 다시 읽는 별도 스크립트로 만든 것이다. QGIS 3.44.15, WhiteboxTools v2.2.0(wbt_for_qgis 플러그인). SHA-256 앞 12자리:

  • 입력 비집수면적 371c0096063a
  • 입력 경사 0971ac9f4ce6
  • 유사이송지수 d2bdec73e68e
  • 구역통계 .shp / .dbf 235891ed214a / 3a4a3aaafb30

2026-11-20

Whitebox 실제 QGIS 실습 31 — 하천력 지수(SPI)로 본 두 유역: 평균은 본류가, 중앙값은 사면이 정했다

30편에서 지형습윤지수(TWI)로 두 유역의 "젖을 만한 자리"를 비교했다. 같은 재료로 반대쪽 질문도 던질 수 있다. 물이 모이는 곳이 아니라, 모인 물이 경사를 타고 내려가며 바닥을 깎을 힘이 큰 곳은 어디인가. 사방이나 배수로 설계 전에 침식 위험 구간을 먼저 훑을 때 쓰는 지표가 하천강도지수(Stream Power Index, SPI)다.

식은 SPI = SCA × tan β다. SCA는 30편에서 만든 D-무한대 비집수면적(m²/m), β는 경사다. TWI가 SCA를 tan β로 나눈 값의 로그라면, SPI는 곱한 값이다. 위에서 받는 물이 많고 경사까지 급하면 커진다. 이번 회차는 30편 결과를 그대로 받아 Whitebox StreamPowerIndex를 돌리고, 구역통계로 두 유역을 비교했다. 그런데 비교 결과가 어떤 요약값을 보느냐에 따라 뒤집혔다. 이번 글의 대부분은 그 이야기다.

자료

30편 입력과 출력을 새 입력 폴더(WB31_Input_20261120)로 복사해 썼다. 복사본 해시는 원본과 같다.

입력원래 출처내용
wb31_input_sca_dinf.tif30편 DInf Flow Accumulation18편 함몰지 보정 DEM(최대 비용 0.03)에서 만든 D-무한대 비집수면적. 1 m 셀, NAD83 UTM 13N EPSG:26913, 1500×1500 셀
wb31_input_slope_deg.tif30편 Slope같은 보정 DEM의 경사, 도 단위. 0.020°~88.65°, 0°인 셀 없음
wb31_input_basins_merged.shp26편 병합 폴리곤VALUE 1 = 중간유역(A−B) 1,218,780 m², VALUE 2 = B 유역 211,372 m²
wb31_input_streams_cap0p03.tif18편 하천집수면적 1 ha 기준 하천(지도 확인과 하천 셀 통계용)

SCA와 경사를 새로 만들지 않은 이유는 단순하다. 30편 TWI와 이번 SPI를 나란히 놓고 보려면 두 지수가 정확히 같은 SCA, 같은 경사에서 나와야 한다. 하나라도 다시 계산하면 둘의 차이가 지수 때문인지 입력 때문인지 가릴 수 없다.

1단계: StreamPowerIndex

공간 처리 툴박스 → WhiteboxTools → Geomorphometric Analysis → StreamPowerIndex를 연다. 입력란은 셋이다.

입력란값이유
Input Specific Contributing Area (SCA) FileSpecific contributing area, D-inf (m2/m, practice 30)Log-transform을 끄고 만든 SCA여야 한다. 로그를 씌운 SCA를 넣으면 곱셈이 의미를 잃는다.
Input Slope FileSlope, degrees (practice 30)도 단위 경사. 아래 독립 계산에서 도 단위로 tan을 취한 값과 맞았다.
Specific Contributing Area (SCA) Exponent1.0(기본값)SPI = SCA^p × tan β의 p. 기본 형태 그대로 두었다. 집수면적의 영향을 줄이거나 키우는 연구용 조정이라, 같은 값을 써야 다른 결과와 비교가 된다.
Output Filewb31_spi.tif
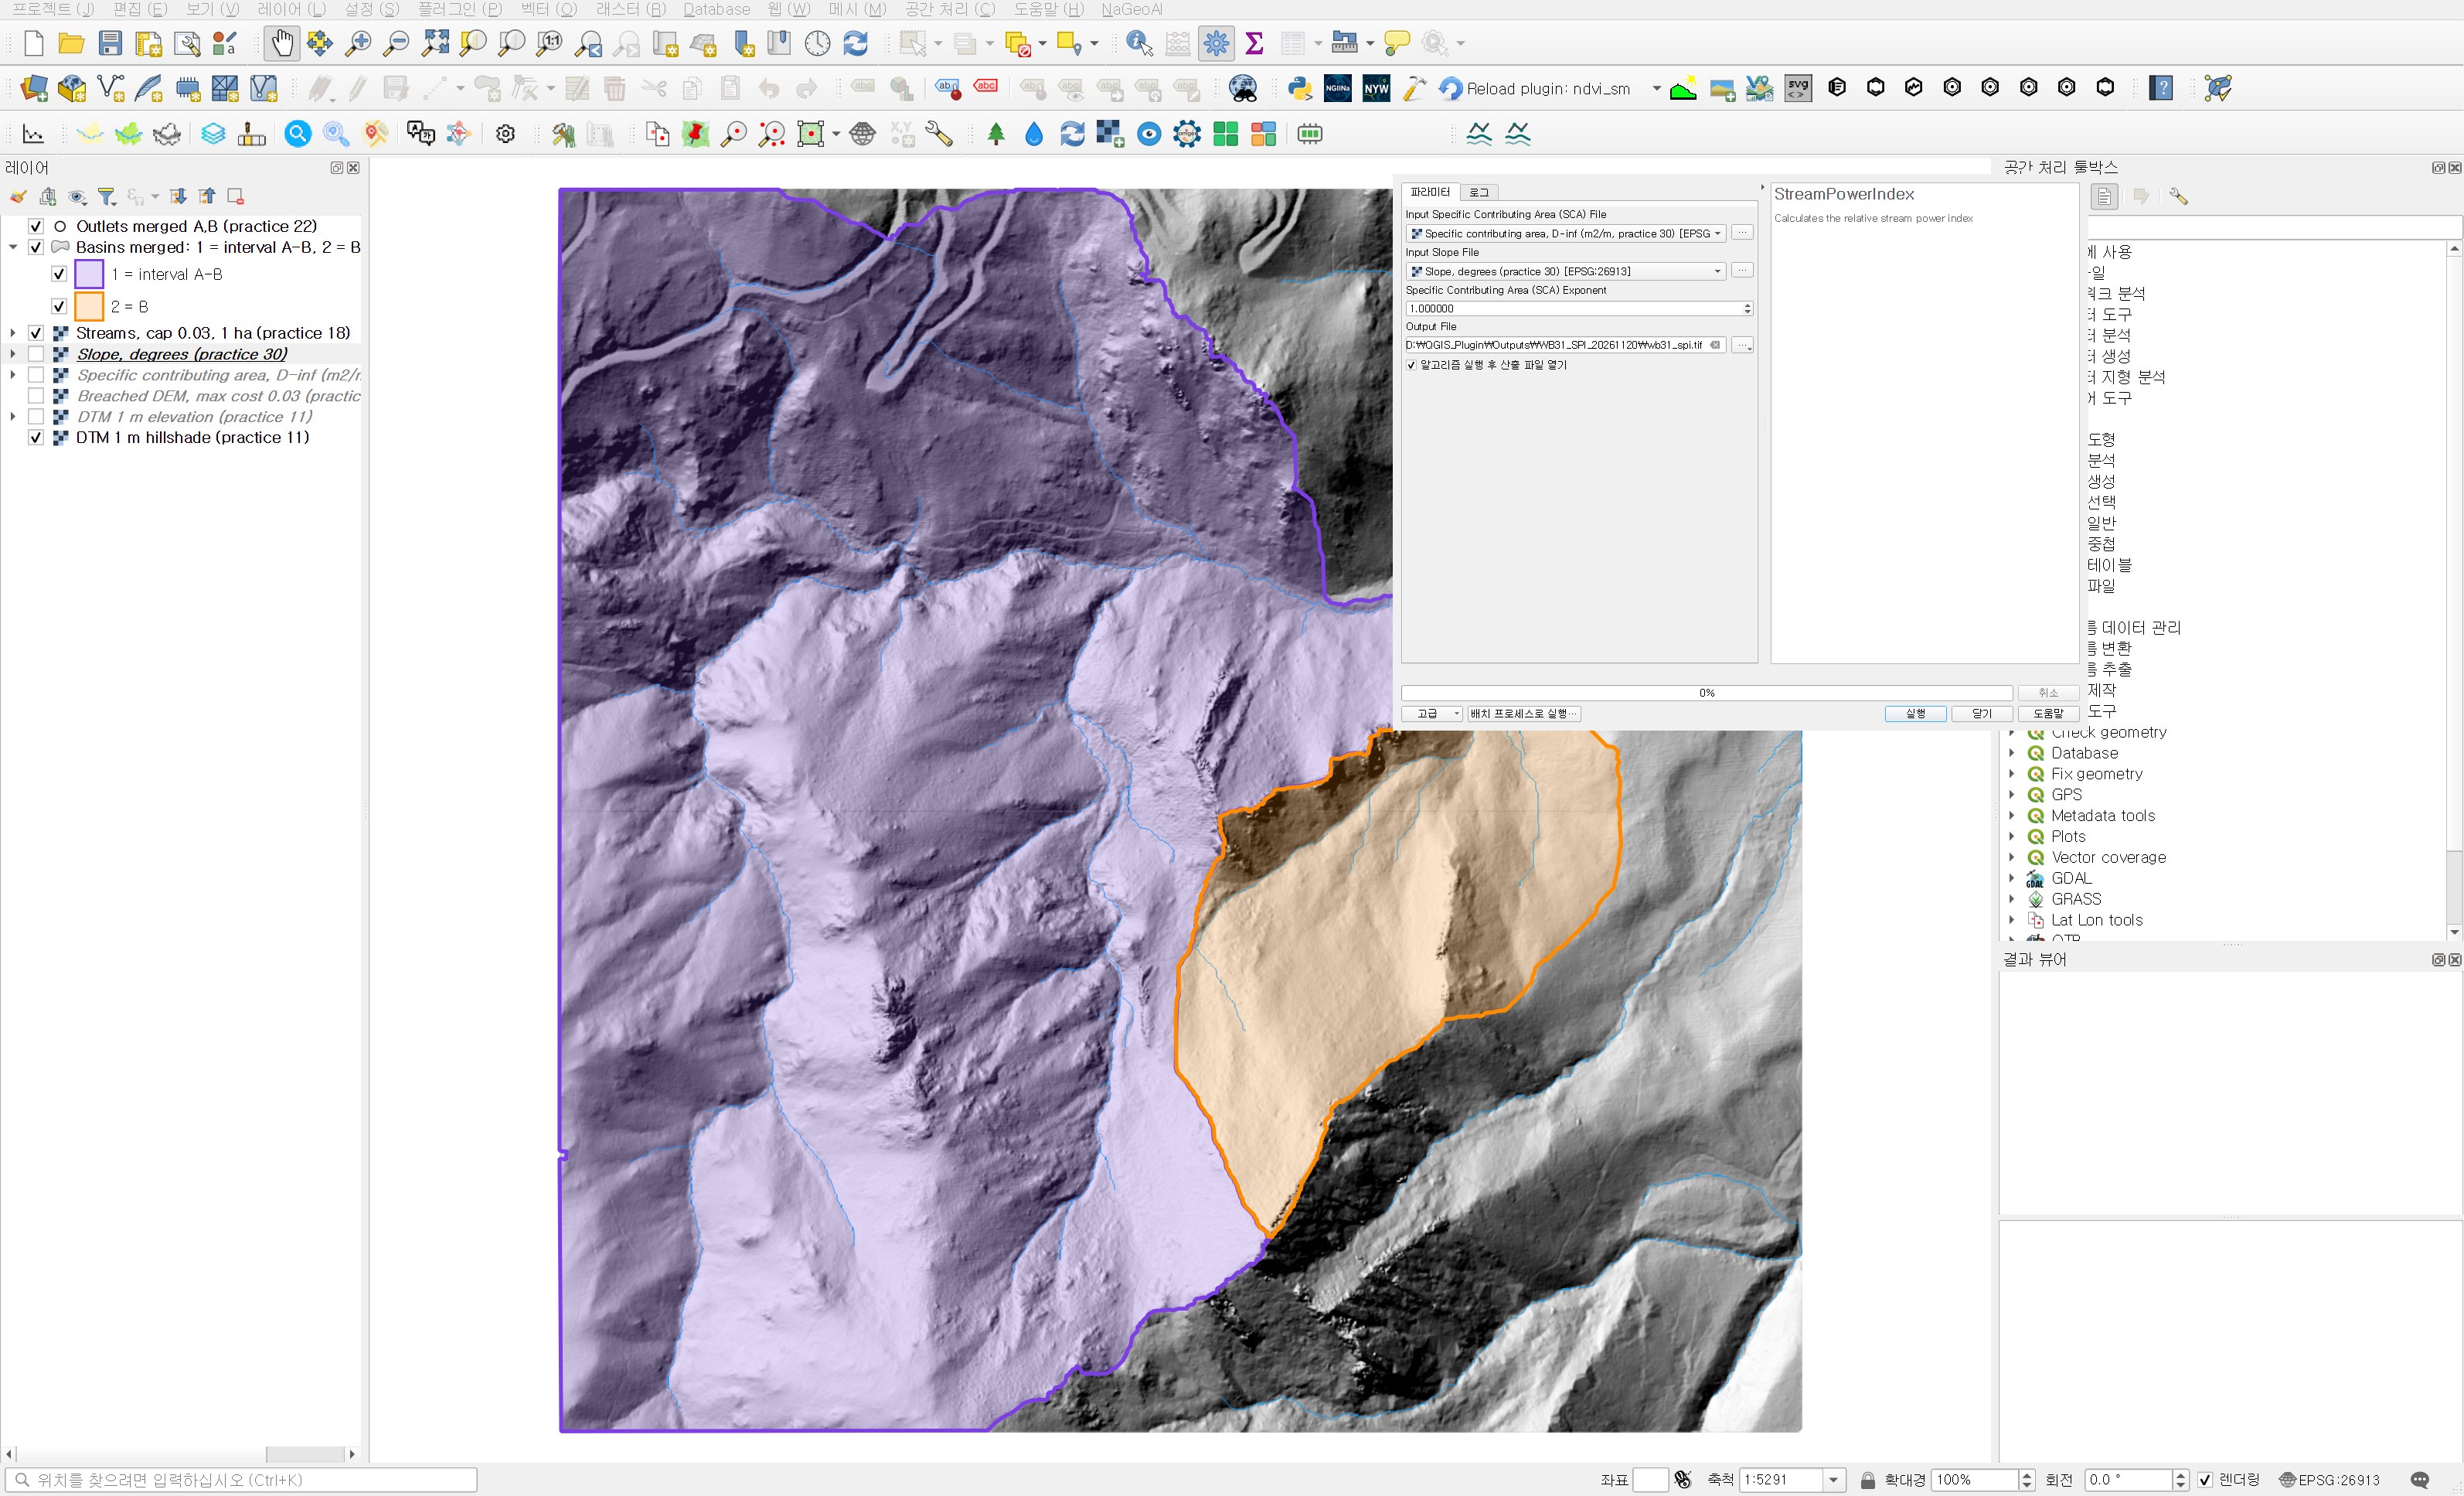
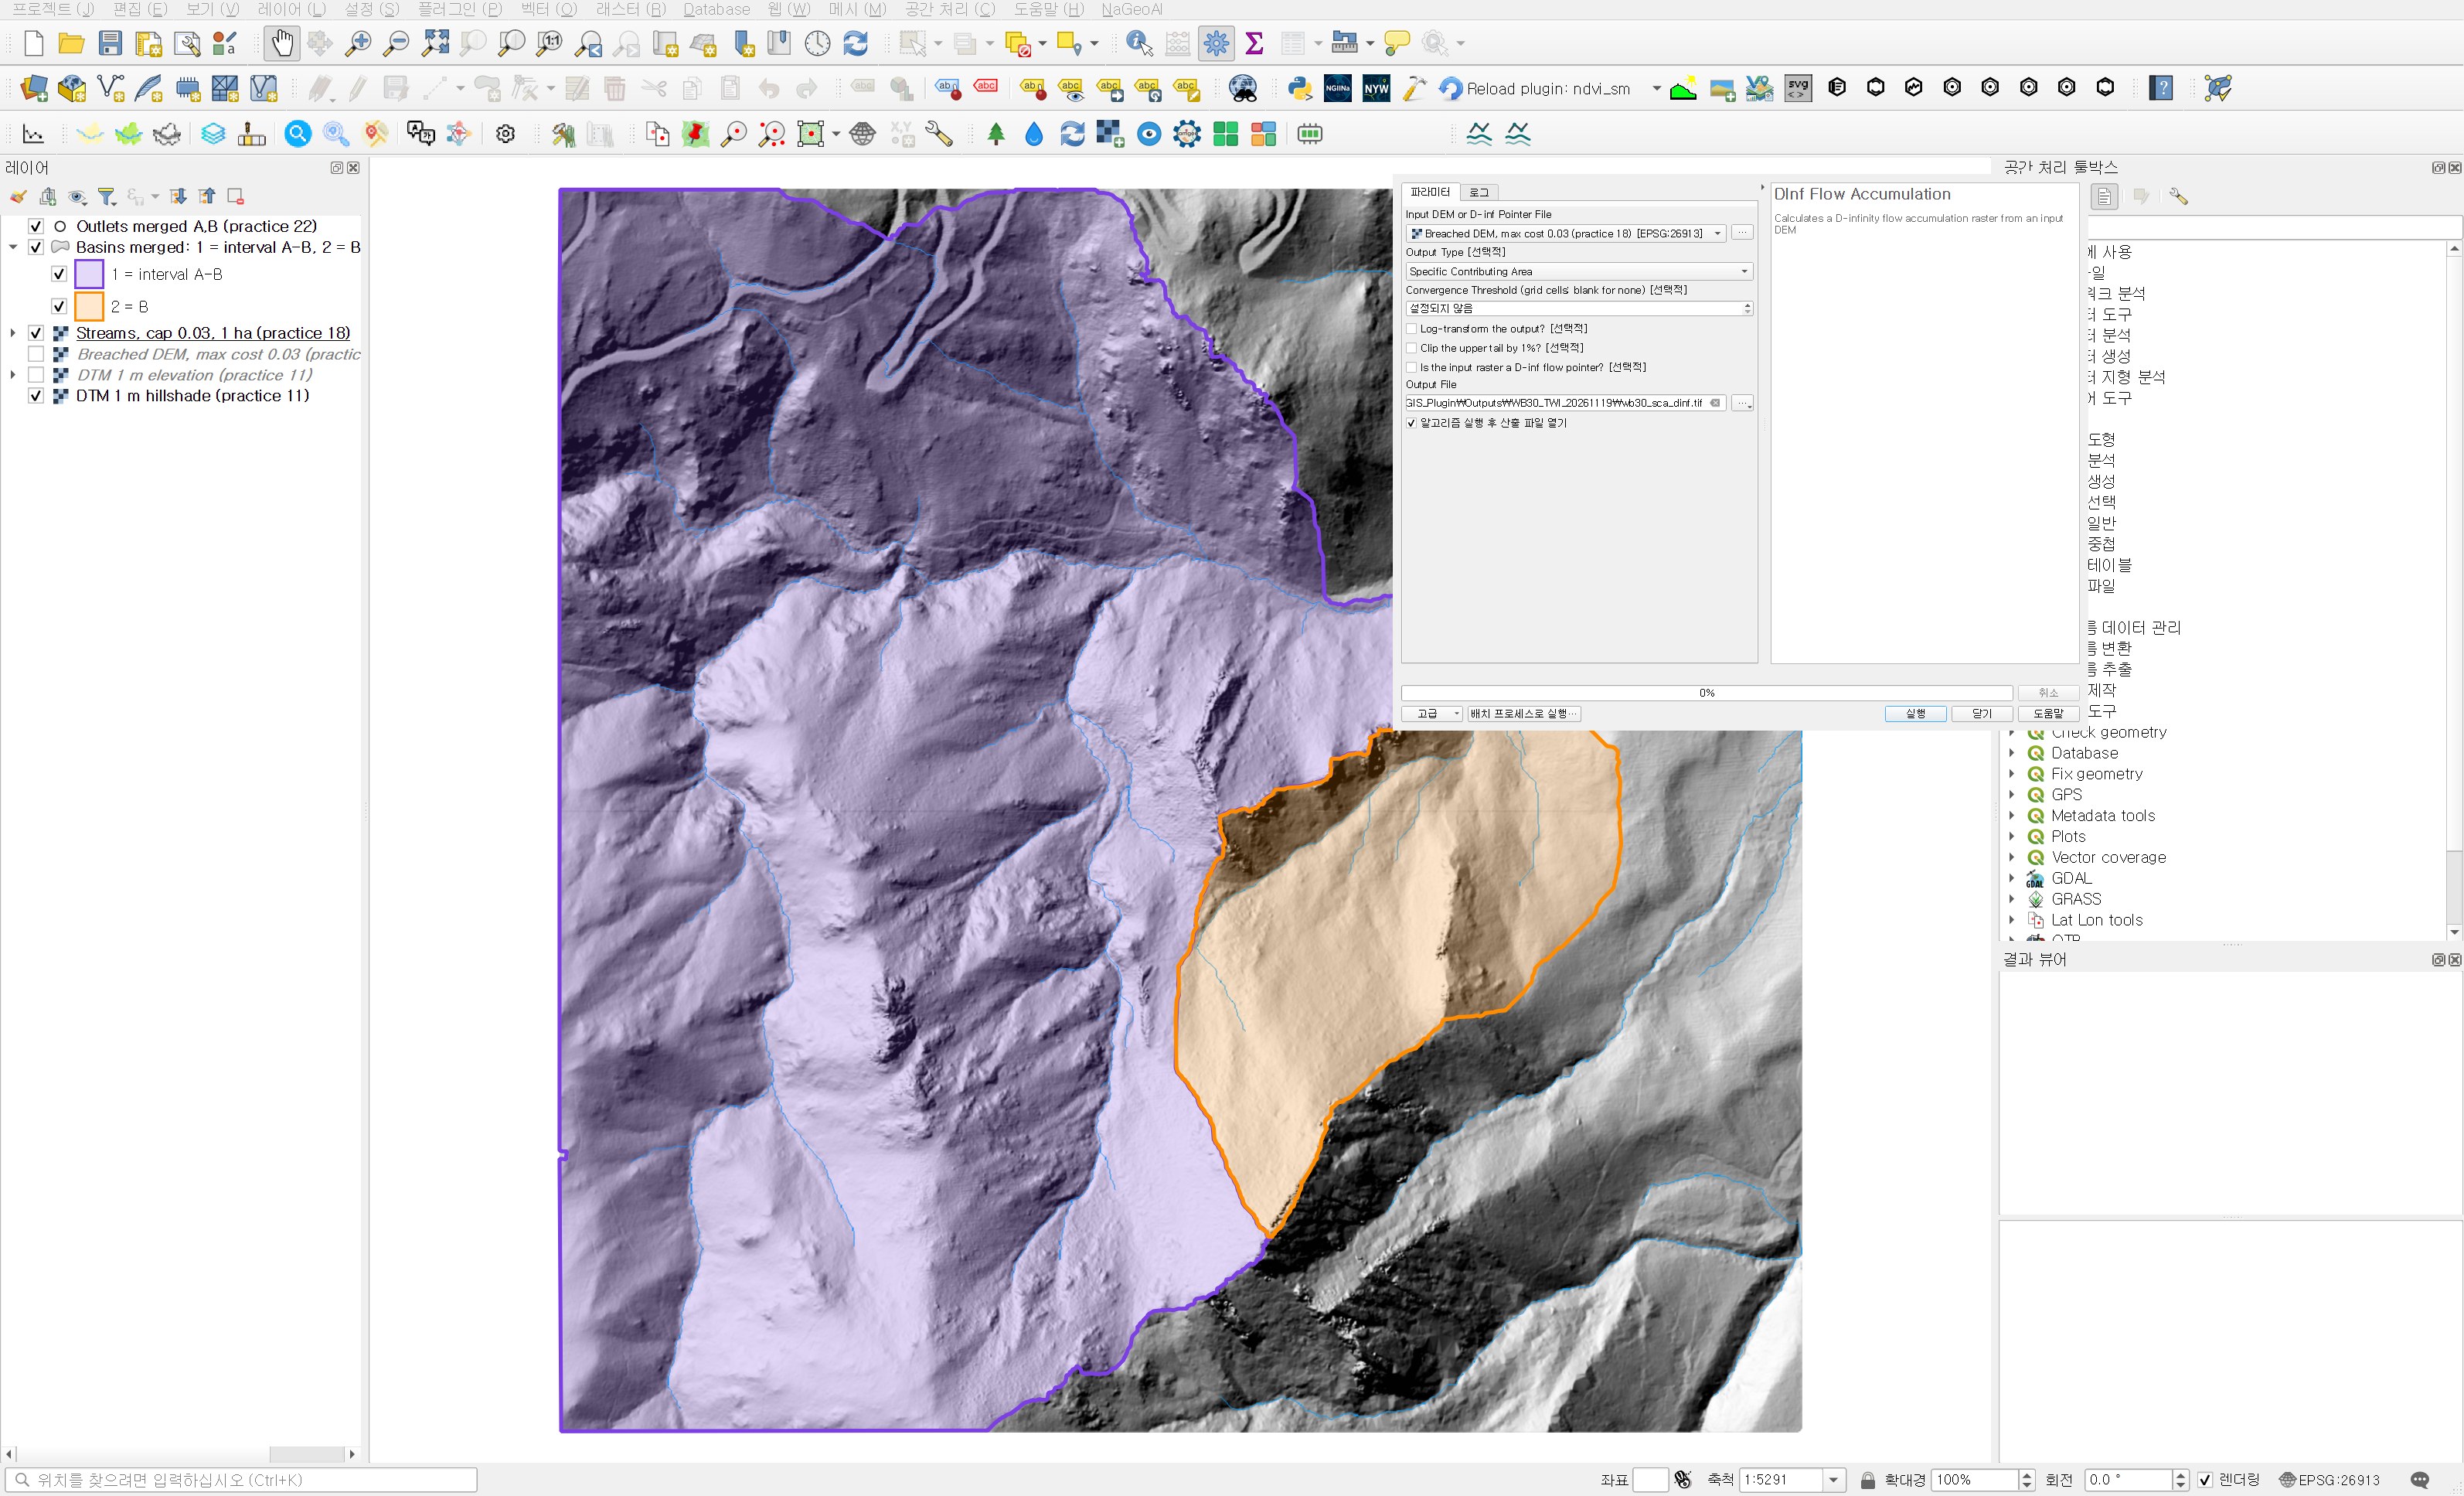
QGIS StreamPowerIndex 대화상자. Input Specific Contributing Area (SCA) File은 Specific contributing area, D-inf (m2/m, practice 30), Input Slope File은 Slope, degrees (practice 30), SCA Exponent는 1.000000, 출력은 WB31_SPI_20261120 폴더의 wb31_spi.tif다. 뒤 지도에는 음영기복 위에 연보라 중간유역과 주황 B 유역이 칠해져 있다.
그림 1. StreamPowerIndex 대화상자. 30편의 SCA와 경사를 넣고 지수는 기본값 1로 두었다.

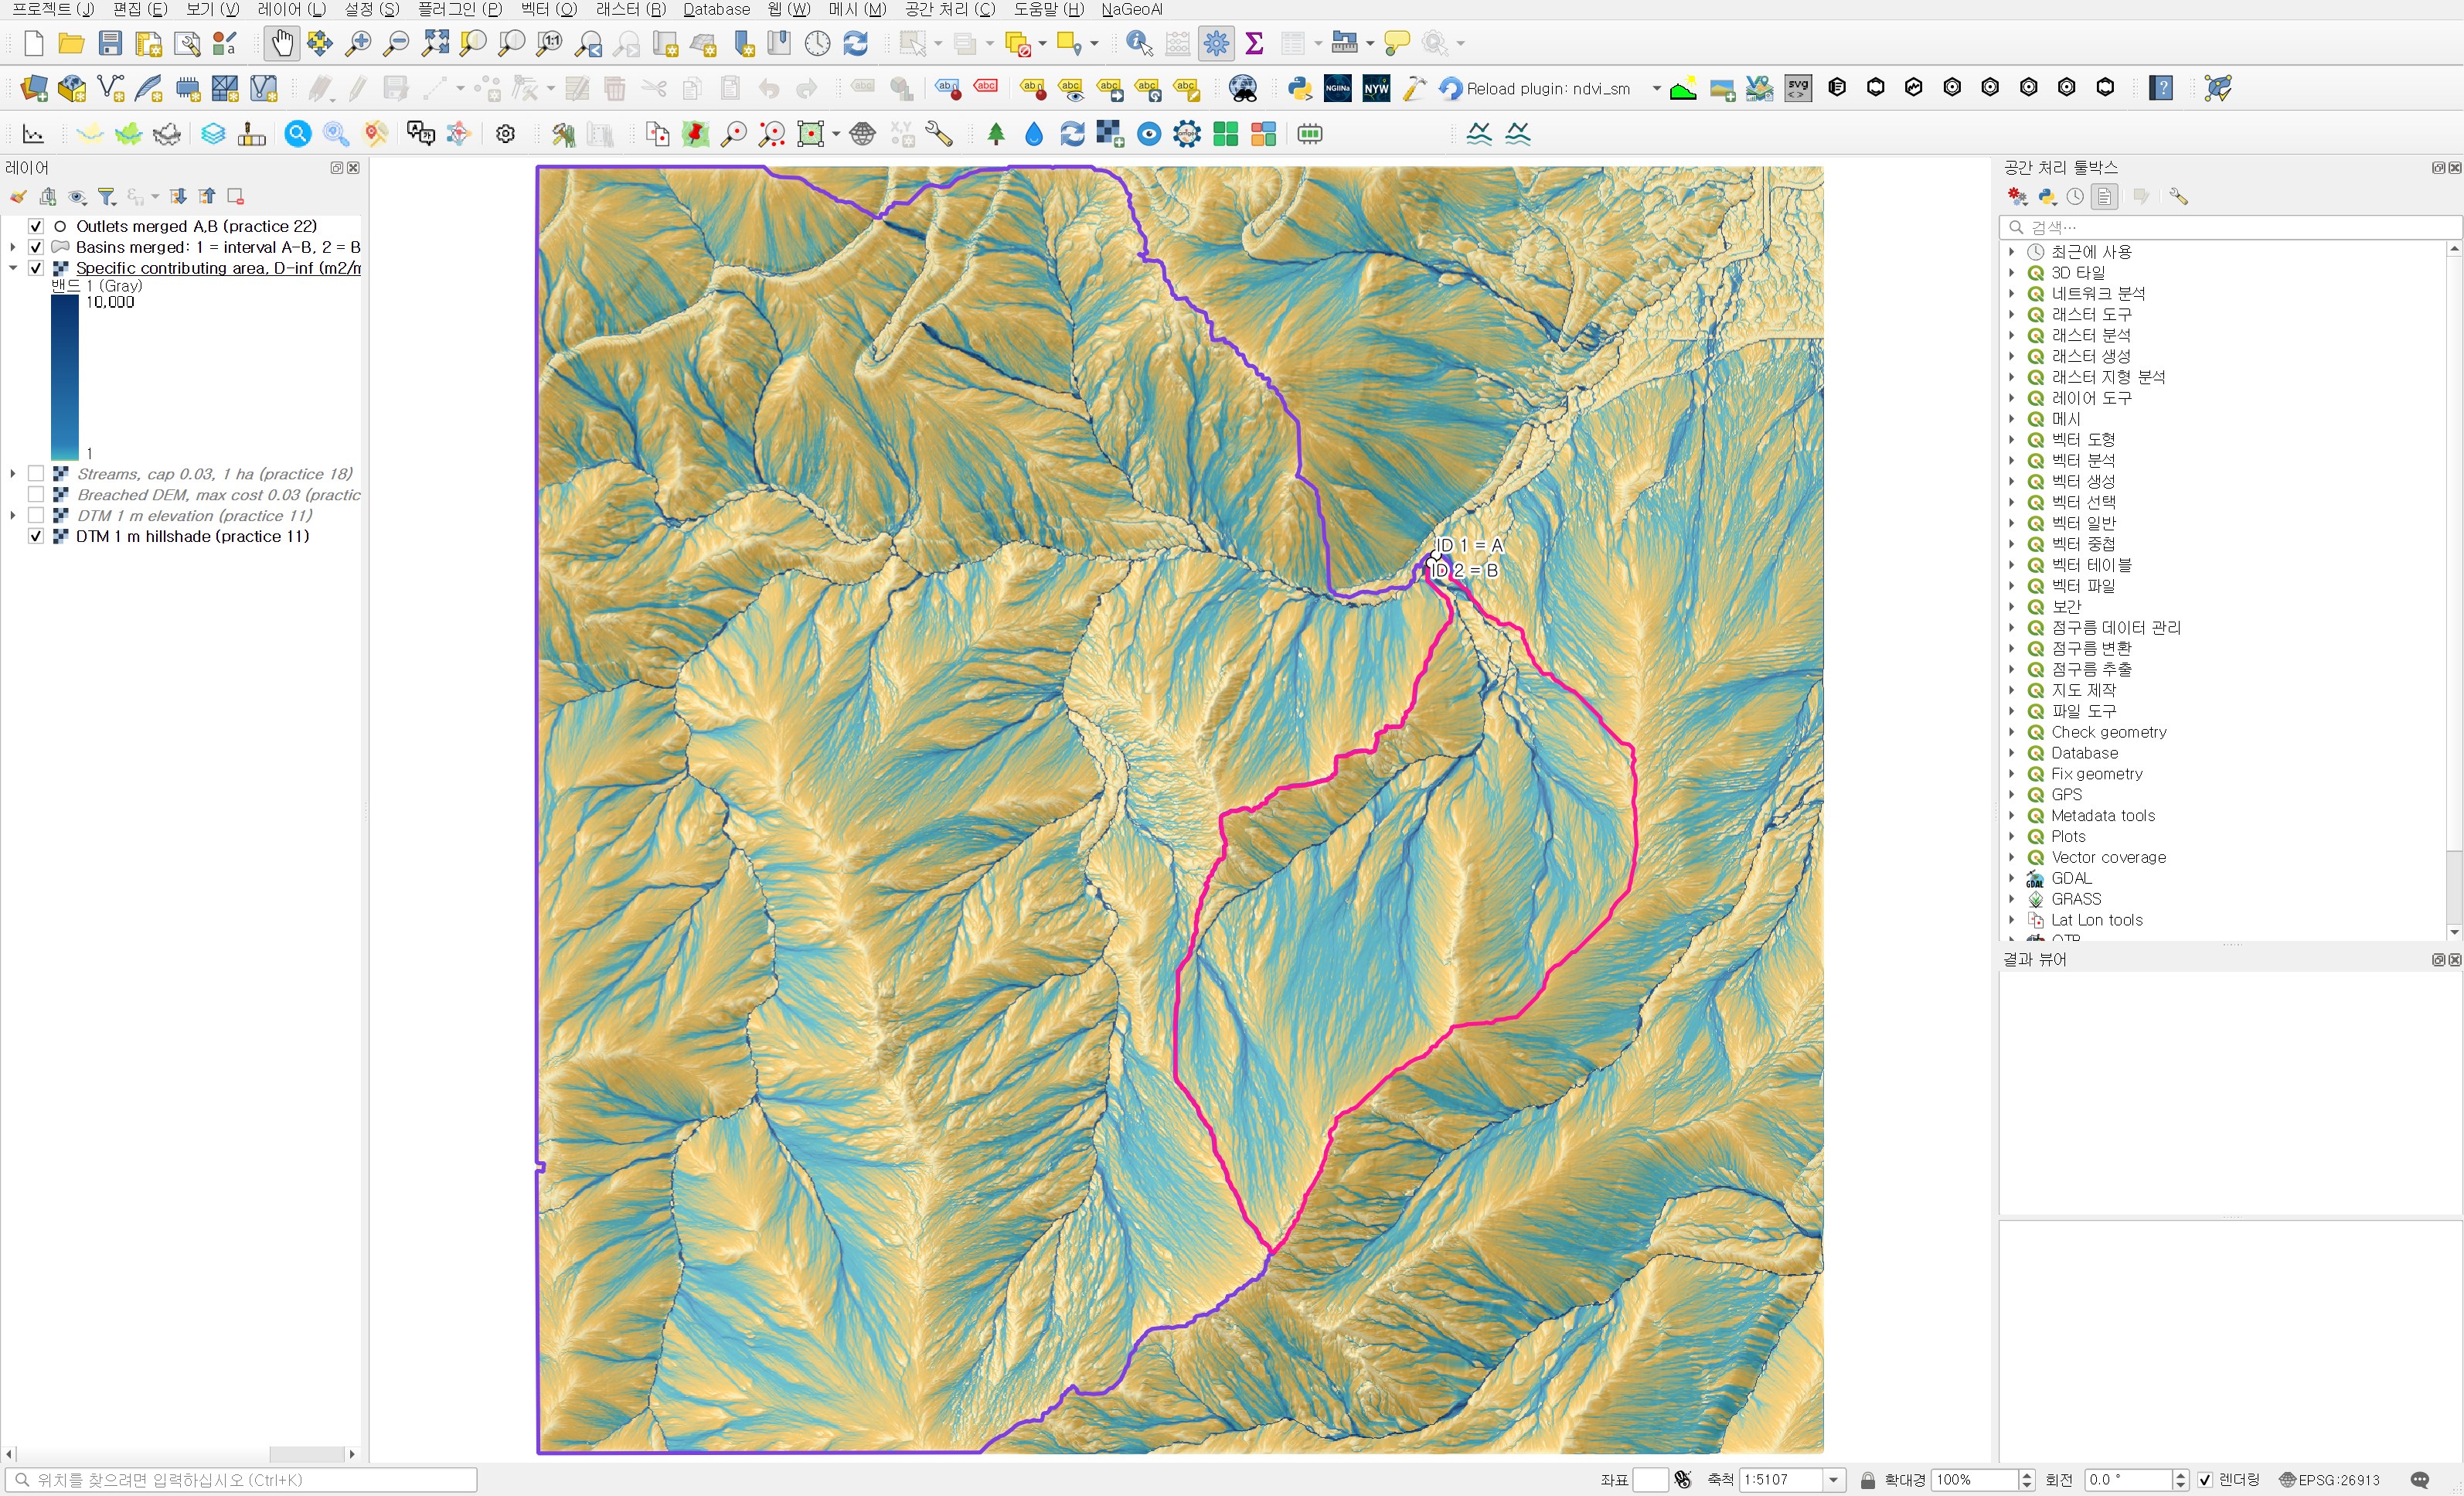
결과는 0.00044부터 1,719,393까지 열 자리 가까이 퍼진다. 중앙값은 14.1인데 99백분위가 1,469, 최댓값이 170만이다. SCA의 긴 꼬리를 그대로 물려받은 분포라서 선형으로 칠하면 하천 몇 줄만 보이고 나머지는 한 색이 된다. 0.1, 1, 10, 100, 1,000, 10,000을 경계로 한 단계 색으로 칠했다. QGIS 불연속 색 띠는 범례 값이 구간의 위쪽 끝이라, 예를 들어 남색은 1,000 초과 셀이다.

하천강도지수 지도. 범례는 0.1 연노랑, 1 연두, 10 민트, 100 청록, 1,000 파랑, 10,000 남색이다. 능선은 연노랑, 사면 대부분은 민트와 청록이고, 골짜기와 사면의 가는 줄기가 파랑과 남색으로 나뭇가지처럼 뻗는다. 보라 선은 중간유역, 분홍 선은 B 유역 경계이고 위쪽 가운데에 ID 1 = A, ID 2 = B 유출구 표시가 있다.
그림 2. 하천강도지수. 단계 색 경계는 10배 간격이다.

TWI 지도(30편 그림 4)와 겹쳐 보면 골짜기 줄기 모양은 비슷한데 성격이 다르다. TWI는 경사가 완만한 골짜기 바닥에서 더 커지고, SPI는 같은 줄기라도 경사가 급한 상류 구간에서 더 커진다. 유출구 쪽을 확대해 18편 하천(빨강)을 겹쳤다.

유출구 부근 확대 지도. 하천강도지수 단계 색 위에 빨간 하천선과 보라 중간유역, 분홍 B 유역 경계가 겹쳐 있다. 빨간 하천선을 따라 남색 셀이 이어지고, 하천선이 없는 사면에도 남색과 파랑 줄기가 여러 갈래로 내려온다. 오른쪽 위에 ID 1 = A, ID 2 = B 유출구 표시가 있다.
그림 3. 유출구 부근 확대(축척 약 1:1,500). 빨간 선이 1 ha 기준 하천이다.

눈여겨볼 곳은 빨간 선이 없는 사면이다. 하천 기준(1 ha)에 못 미치는 사면 골에도 남색(1,000 초과)과 파랑(100 초과) 줄기가 길게 내려온다. 집수면적은 작아도 경사가 급하면 곱이 커져서, 하천 셀과 같은 색 단계에 들어간다. 하천 추출만 보고 "여기는 물길이 아니니 괜찮다"고 넘기기 쉬운 자리가 바로 이런 사면 골이다.

2단계: 유역별 구역통계

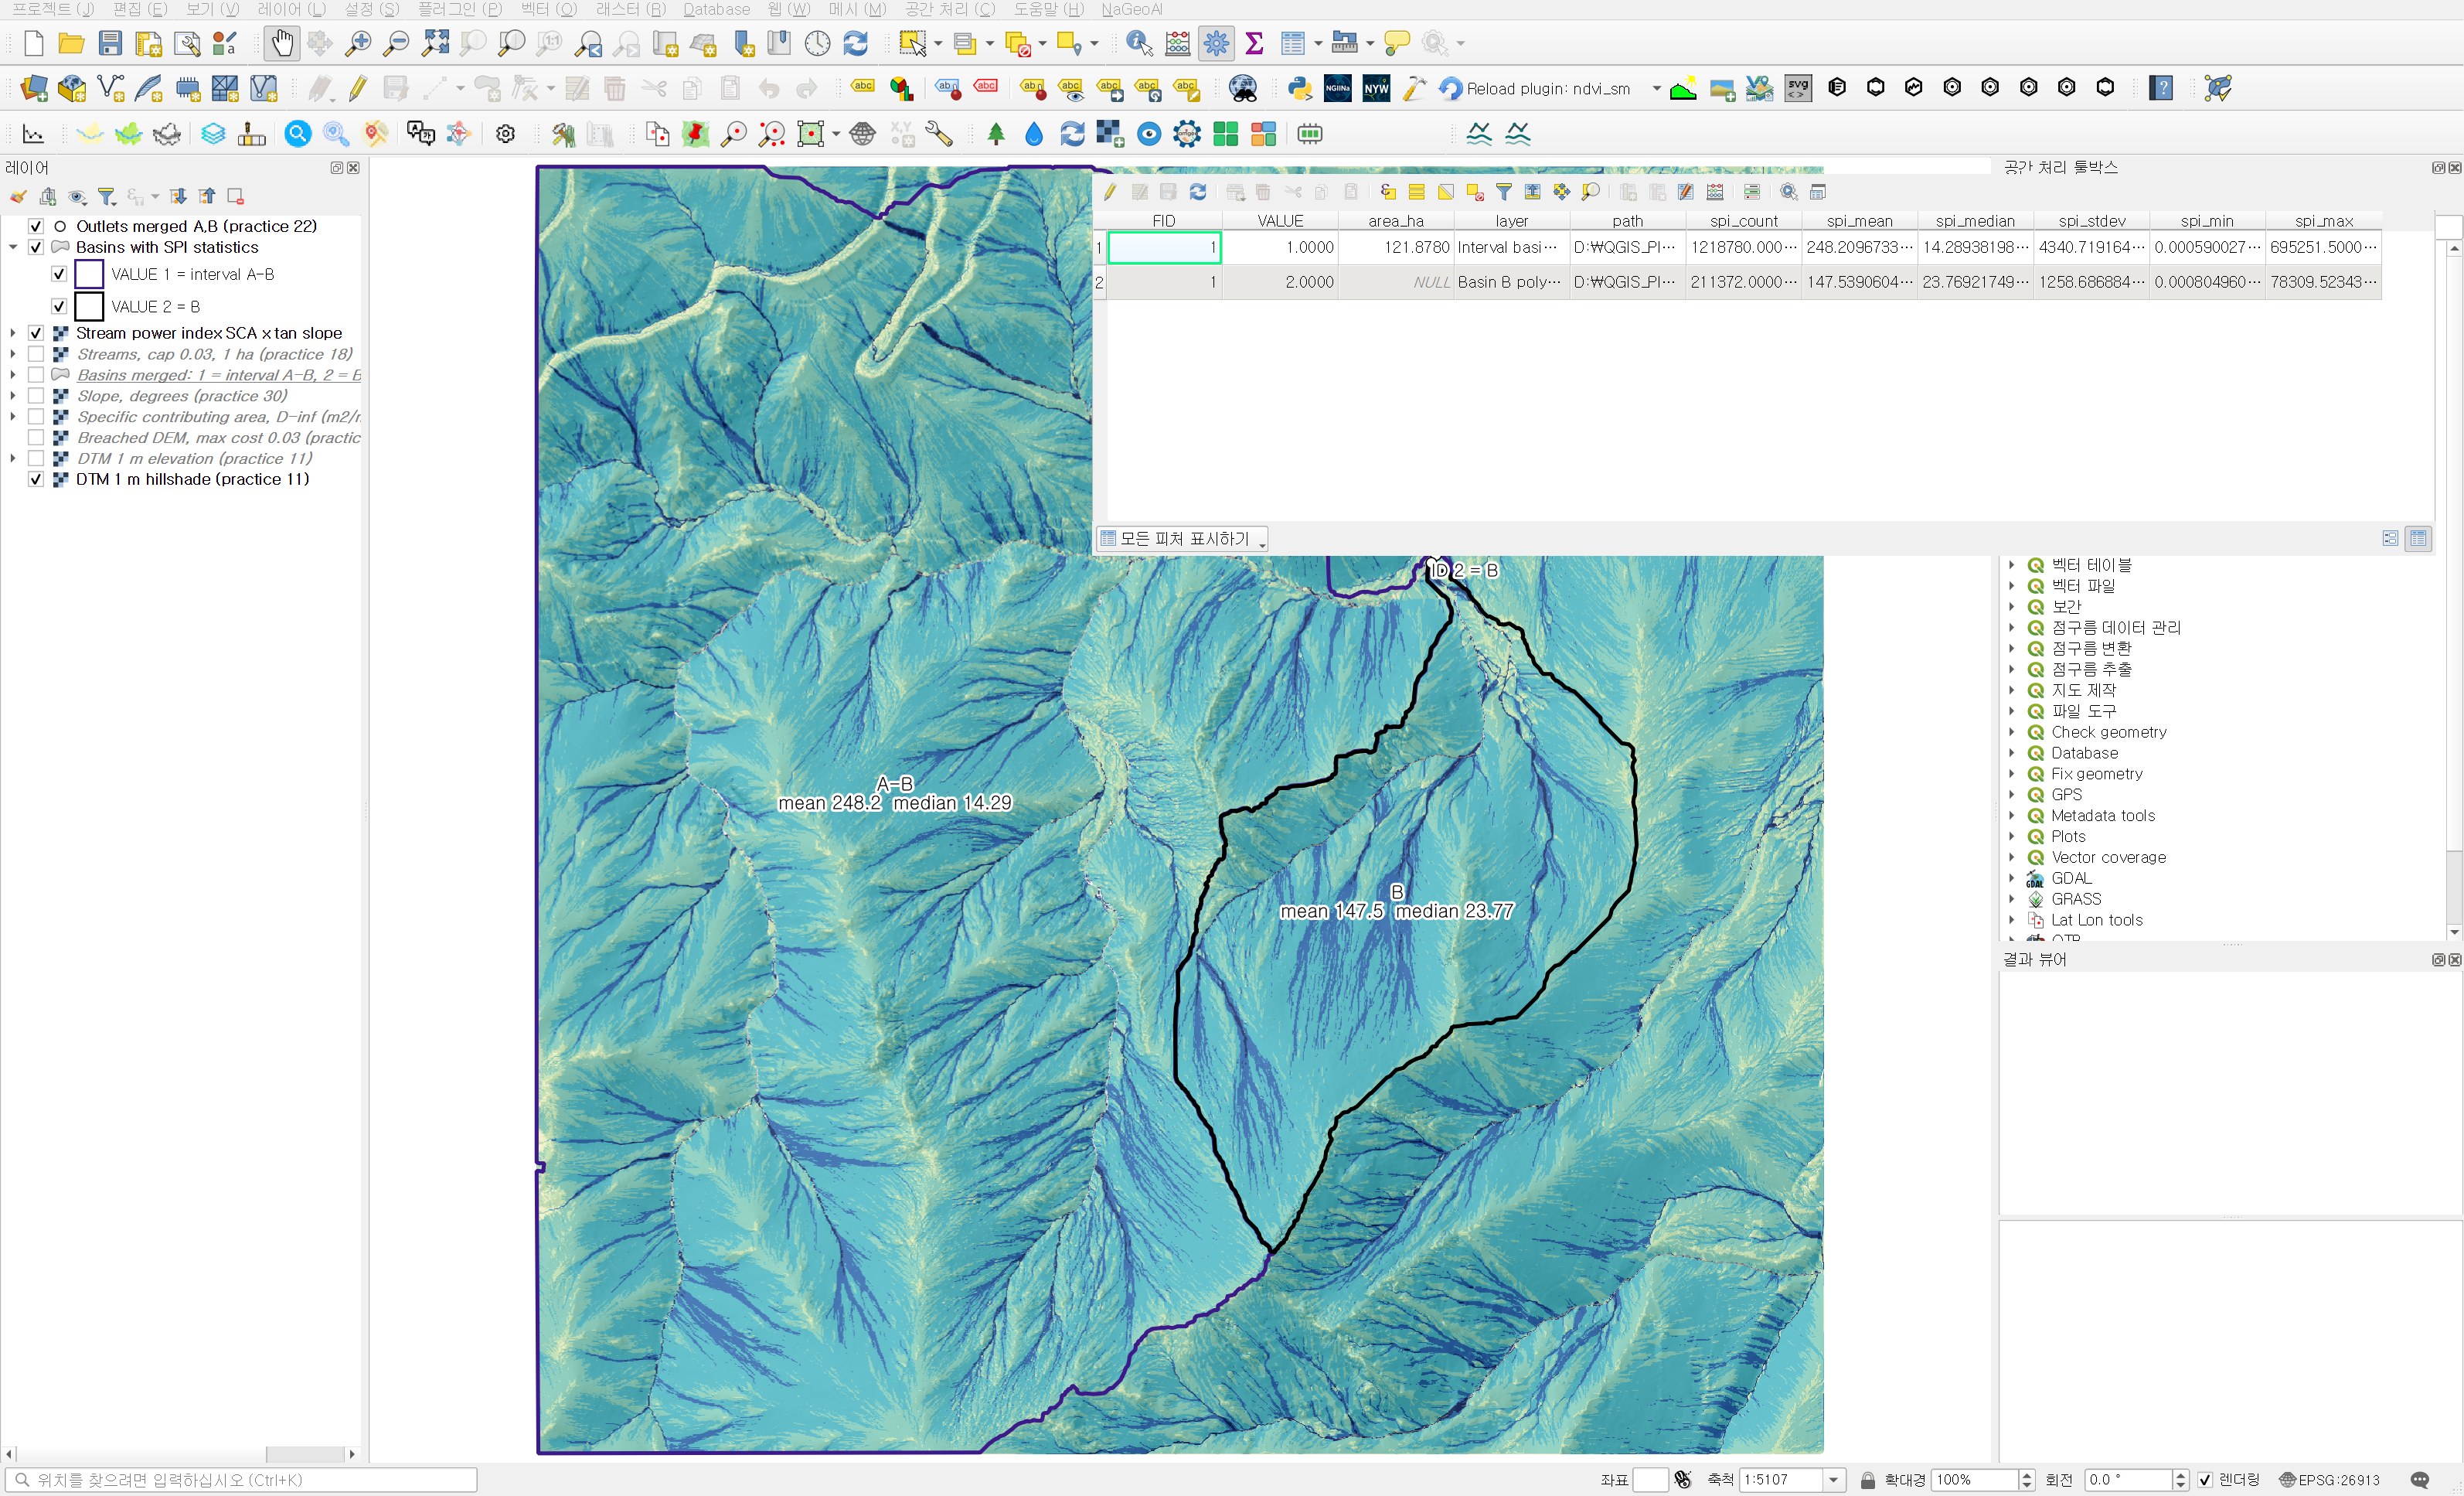
공간 처리 툴박스 → 래스터 분석 → 구역통계(Zonal statistics)에 26편 병합 폴리곤과 SPI를 넣었다. 접두어는 spi_, 통계는 30편과 같이 개수, 평균, 중앙값, 표준편차, 최소, 최대다. 출력은 wb31_basin_spi_stats.shp.

구역통계 속성 테이블. VALUE 1 행은 spi_count 1218780, spi_mean 248.2096733, spi_median 14.28938198, spi_stdev 4340.719164, spi_min 0.000590027, spi_max 695251.5이고 VALUE 2 행은 spi_count 211372, spi_mean 147.5390604, spi_median 23.76921749, spi_stdev 1258.686884, spi_min 0.000804960, spi_max 78309.52343이다. 뒤 지도에는 유역 안에 A-B mean 248.2 median 14.29, B mean 147.5 median 23.77 라벨이 있다.
그림 4. 구역통계 결과 표와 유역 라벨.
항목중간유역 A−B유역 B
셀 수(m²)1,218,780211,372
평균248.2147.5
중앙값14.2923.77
표준편차4,340.71,258.7
최댓값695,251.578,309.5
10 / 90백분위2.24 / 89.973.50 / 134.08

평균만 보면 중간유역이 B보다 1.7배 크다. 중앙값은 반대로 B가 1.7배 크다. 표준편차가 평균의 17배(A−B), 8.5배(B)다. 이 정도로 치우친 분포에서는 평균 하나로 유역을 대표하면 안 된다는 신호다.

평균이 뒤집힌 이유

값을 큰 순서로 세워 상위 1% 셀만 따로 떼어 봤다.

항목중간유역 A−B유역 B
상위 1% 셀 수12,1882,114
상위 1% 셀이 SPI 합계에서 차지하는 비율83.4%58.1%
상위 1% 셀을 뺀 평균41.662.4
기하평균14.4923.14
하천 셀(1 ha 기준) 수 / 중앙값6,390 / 11,4931,371 / 4,895
하천 밖 셀 중앙값14.1723.52

중간유역은 셀 1%가 SPI 합계의 83%를 차지한다. 그 셀들을 빼면 평균이 248에서 41.6으로 떨어지고 B(62.4)보다 작아진다. 중간유역 안에는 A 본류가 지나가고, 본류 셀은 위쪽 집수면적이 수십만 m²라 SPI가 수만에서 수십만이 된다. 최댓값 695,252가 그 본류 셀 쪽으로 보인다. 하천 셀 중앙값도 중간유역이 11,493으로 B(4,895)의 두 배가 넘는다. 즉 평균의 차이는 "본류를 품고 있느냐"의 차이였고, 사면 전체의 성격은 아니었다.

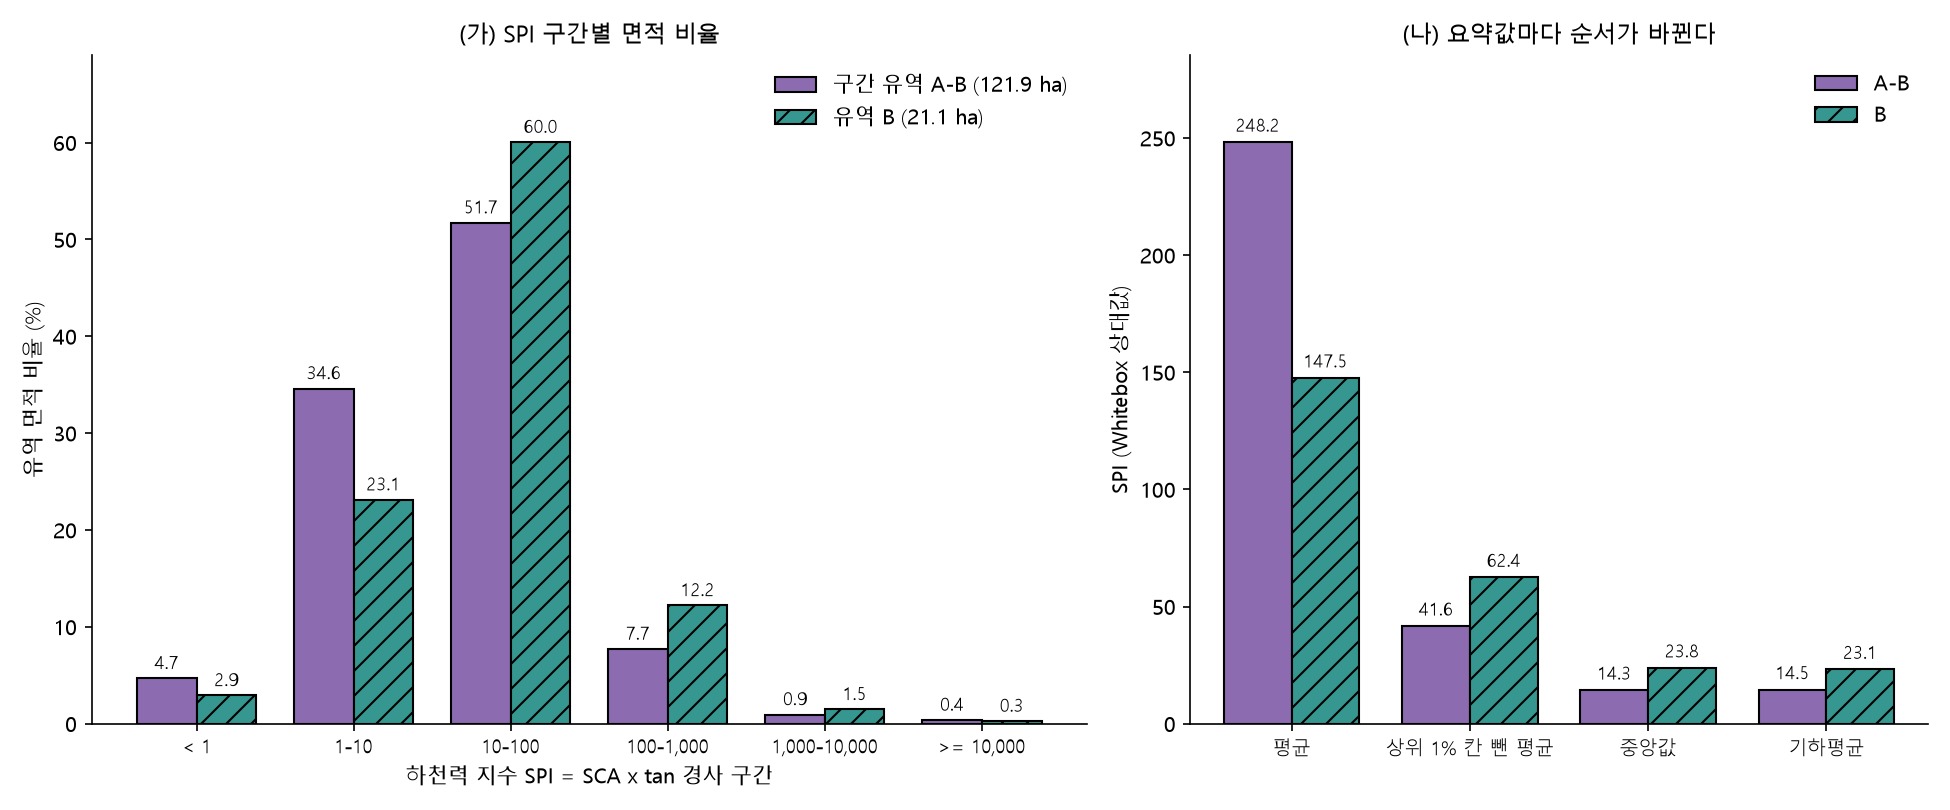
하천 밖 셀만 보면 B가 23.5, 중간유역이 14.2다. 그림 5의 구간 비율에서도 B는 100~1,000 구간이 12.2%로 중간유역(7.7%)보다 많고, 1~10 구간은 23.1%로 중간유역(34.6%)보다 적다. 사면 셀 대부분이 한 단계 위로 올라가 있는 셈이다.

두 셀짜리 막대그래프. 왼쪽 (가)는 SPI 구간별 면적 비율로, 중간유역 A-B(보라)와 B(청록 빗금)가 1 미만 4.7과 2.9, 1-10 34.6과 23.1, 10-100 51.7과 60.0, 100-1,000 7.7과 12.2, 1,000-10,000 0.9와 1.5, 10,000 이상 0.4와 0.3퍼센트다. 오른쪽 (나)는 요약값 비교로 평균 248.2와 147.5, 상위 1% 셀 뺀 평균 41.6과 62.4, 중앙값 14.3과 23.8, 기하평균 14.5와 23.1이다.
그림 5. (가) SPI 구간별 면적 비율, (나) 요약값별 비교. 평균만 중간유역이 크고 나머지는 B가 크다.

TWI와 같은 재료, 다른 부호

기하평균은 ln SPI의 평균을 되돌린 값이라 성분으로 쪼갤 수 있다. ln SPI = ln SCA + ln tan β이므로 두 유역의 차이는 다음과 같다.

  • ln SCA 평균: B 3.7625, 중간유역 3.2619, 차이 +0.500
  • ln tan β 평균: B −0.6208, 중간유역 −0.5885, 차이 −0.032
  • 합 0.468, 즉 기하평균 비 23.14 / 14.49 = 1.60배

30편 TWI에서는 같은 두 성분이 0.500 + 0.032 = 0.533으로 더해졌다. TWI는 tan β를 나누니 B의 경사가 조금 완만한 것이 TWI를 올렸고, SPI는 곱하니 같은 차이가 SPI를 조금 깎는다. 다만 경사 항은 0.03 수준이고 차이 대부분은 ln SCA 0.5에서 나온다. B 사면이 셀마다 위쪽에서 받는 면적이 평균적으로 e^0.5 ≈ 1.65배 많기 때문에, B는 TWI도 높고 SPI도 높다. 같은 사면이 더 젖고 더 깎일 수 있다는 말이 모순처럼 들리지만, 둘 다 "물이 많이 지나간다"는 같은 사실을 다른 각도에서 본 것이다.

현장 판단으로 옮기면 이렇다. 본류 하나를 관리하는 문제라면 중간유역이 우선이다. 사면 골 여러 줄에서 생기는 세굴이나 토사 유출을 걱정한다면 B 쪽 사면을 먼저 봐야 한다. 이건 지형 지수만으로 한 해석이고, 실제 침식량이나 토양 조건으로 확인한 것은 아니다.

독립 계산으로 확인

  • numpy로 SCA × tan(경사°)를 다시 계산해 Whitebox 출력과 비교했다. 유효 2,248,166개 셀에서 상대 차이 최대 6.0×10⁻⁸, 10⁻⁵을 넘는 셀 0개다. 지수 1.0과 도 단위 경사가 의도대로 들어갔다.
  • 출력 SPI는 EPSG:26913, 1500×1500, float32, NoData −32768 1,834개 셀로 입력 SCA·경사·DEM과 격자가 같고 NoData 셀 수도 DEM과 같다.
  • 구역통계 여섯 항목을 셀 중심으로 래스터화한 유역 마스크로 다시 계산하면 두 유역 모두 차이가 10⁻¹² 이하다.

실무에서 챙길 것

  • SPI는 꼬리가 극단적으로 긴 지표다. 유역 비교에 평균 하나만 쓰면 본류 몇 줄이 결과를 정해 버린다. 중앙값, 기하평균, 상위 몇 %의 비중을 같이 낸다.
  • 지도는 대수 간격 단계 색으로 칠한다. 선형 색 띠로는 하천 몇 셀만 보인다.
  • SPI는 상대 지수다. 값 크기는 DEM 공간해상도, 흐름 알고리즘(D8인지 D-무한대인지), SCA 지수 p에 따라 달라진다. 다른 지역과 비교할 때는 같은 공간해상도와 같은 설정으로 다시 만든다.
  • 하천 추출 기준 아래에 있는 사면 골을 따로 본다. 그림 3처럼 하천선이 없는 자리에서도 SPI가 1,000을 넘는 줄기가 나온다.
  • 1 m 라이다 DEM에서는 도로 측구, 절토 비탈 같은 인공 지형이 SPI를 크게 만들 수 있다. 높은 값이 나온 셀은 항공사진이나 현장으로 한 번 확인한다.

다음 회차

SPI는 침식 "힘"의 상대 크기만 본다. 같은 SCA와 경사로 Whitebox SedimentTransportIndex를 쓰면 토양유실 식(RUSLE)의 경사장 인자(LS)에 해당하는 값을 만들 수 있다. 다음 회차에서는 이번 SPI와 LS 계열 지수가 두 유역을 같은 순서로 보는지 비교해 보려고 한다.

작업 메모

이번 회차는 QGIS 시작 스크립트로 같은 대화상자에 값을 넣어 실행했고, 화면은 그때 캡처한 것이다. 원본 프로젝트는 그대로 두고 복사본(QGIS_Play_NaGeoAI_20261120_31_spi.qgz)에서 작업했다. 자료 출처는 USGS 3DEP(The National Map) 타일 13SDE474426이고, 원본 DTM은 재배포하지 않는다. 그림 5, 백분위, 상위 1% 비중, 기하평균과 성분 분해, 하천 셀 통계, 독립 계산은 출력 파일을 다시 읽는 별도 스크립트로 만든 것이다. QGIS 3.44.15, WhiteboxTools v2.2.0(wbt_for_qgis 플러그인). SHA-256 앞 12자리:

  • 입력 비집수면적 371c0096063a
  • 입력 경사 0971ac9f4ce6
  • 하천강도지수 17a50232deb2
  • 구역통계 .shp / .dbf 235891ed214a / eb9cdcb01867

2026-11-19

Whitebox 실제 QGIS 실습 30 — 지형 습윤지수(TWI)로 본 두 유역: 차이는 경사가 아니라 집수면적에서 났다

27~29편에서 두 유역의 표고, 경사, 경사향을 차례로 비교했다. 지형 하나씩만 본 셈이다. 실무에서 "이 유역은 어디가 젖어 있을까"를 물으면 경사 하나로는 답이 안 나온다. 같은 30° 사면이라도 위에서 물을 모아 받는 골짜기 바닥과 아무것도 받지 않는 능선은 전혀 다르게 젖는다. 그래서 많이 쓰는 지표가 지형습윤지수(Topographic Wetness Index, TWI)다.

식은 간단하다. TWI = ln(SCA / tan β). SCA(specific contributing area, 비집수면적)는 그 셀로 물을 보내는 위쪽 면적을 등고선 폭으로 나눈 값(m²/m)이고, β는 경사다. 위에서 모이는 물이 많을수록, 경사가 완만해 물이 빠져나가기 어려울수록 값이 커진다. 이번 회차는 Whitebox로 SCA와 경사를 만들고, WetnessIndex로 TWI를 계산한 뒤, 구역통계(Zonal statistics)로 두 유역을 비교했다.

자료

29편 입력을 새 폴더로 복사하고, 18편에서 만든 함몰지 보정 DEM을 하나 더 가져왔다. 복사본 해시는 원본과 같다.

입력원래 출처내용
wb30_input_breach_cap0p03.tif18편 함몰지 보정 DEM(최대 비용 0.03)11편 DTM(USGS 3DEP 타일 13SDE474426, NAD83 UTM 13N EPSG:26913, 1 m, 1500×1500 셀)을 BreachDepressionsLeastCost로 보정한 것. 하천과 유역 경계가 모두 이 DEM에서 나왔다.
wb30_input_basins_merged.shp26편 병합 폴리곤VALUE 1 = 중간유역(A−B) 1,218,780 m², VALUE 2 = B 유역 211,372 m²
wb30_outlets_ab.shp22편 유출구점A, B 유출구 두 점(지도 표시와 SCA 확인용)

입력 DEM을 원래 DTM이 아니라 보정 DEM으로 잡은 이유가 있다. SCA는 흐름을 위에서 아래로 끝까지 따라가며 면적을 쌓는 계산이라, 작은 함몰지가 남아 있으면 그 자리에서 흐름이 멈춘다. 유역 경계를 만든 DEM과 같은 DEM을 써야 "이 유역 안의 물"이라는 말도 앞뒤가 맞는다. 경사도 같은 DEM에서 뽑았다. SCA와 경사를 서로 다른 DEM에서 만들면 셀마다 두 값의 기준이 어긋난다.

1단계: D-무한대 비집수면적

공간 처리 툴박스 → WhiteboxTools → Hydrological Analysis → DInf Flow Accumulation을 연다. 지금까지 하천 추출에는 D8(가장 가파른 이웃 한 셀로만 흘려보내는 방식)을 썼는데, TWI에는 D-무한대(D-infinity)를 골랐다. D8은 사면 위의 흐름을 한 줄로 몰아 버려서 사면에 가는 줄무늬가 생기고, 사면에서 물이 퍼지는 모양을 TWI에 담기 어렵다. D-무한대는 흐름방향을 연속 각도로 잡고 아래쪽 두 셀에 나눠 보낸다.

입력란값이유
Input DEM or D-inf Pointer FileBreached DEM, max cost 0.03 (practice 18)유역 경계를 만든 DEM과 같은 것
Output TypeSpecific Contributing AreaWetnessIndex가 요구하는 입력. Cells나 Catchment Area를 넣으면 단위가 달라진다.
Convergence Threshold비움하천 구간에서 흐름을 한 셀로 모으는 기준. 이번에는 사면 그대로 보려고 쓰지 않았다.
Log-transform / Clip the upper tail / Is the input a D-inf pointer모두 체크 안 함로그를 미리 씌우면 WetnessIndex에서 ln을 한 번 더 하게 된다. 상위 1% 자르기도 하천 셀 값을 바꾼다.
Output Filewb30_sca_dinf.tif
QGIS DInf Flow Accumulation 대화상자. Input DEM은 Breached DEM, max cost 0.03 (practice 18), Output Type은 Specific Contributing Area, Convergence Threshold는 설정되지 않음, 세 체크박스는 모두 꺼져 있고 출력은 wb30_sca_dinf.tif다. 뒤 지도에는 음영기복도 위에 연보라 중간유역과 주황 B 유역이 칠해져 있다.
그림 1. DInf Flow Accumulation 대화상자. 출력 형식만 Specific Contributing Area로 바꾸고 나머지 선택 항목은 기본값으로 두었다.

결과 값은 1부터 1,669,852까지 퍼져 있고 중앙값은 26.7 m²/m다. 1 m 셀이라 SCA 숫자는 위쪽 면적(m²)과 같다. 99백분위가 4,279라서 몇 안 되는 하천 셀이 위쪽 꼬리를 길게 끈다. 그대로 칠하면 지도 전체가 한 색이 되기 때문에 1, 10, 100, 1,000, 10,000에 색을 찍어 대수 눈금처럼 보이게 칠했다.

비집수면적 지도. 노랑(1)에서 하늘색(100), 진한 파랑(10,000 m2/m)으로 칠했다. 능선은 노랑, 사면을 따라 파랑 줄기가 부채꼴로 퍼지며 골짜기로 모인다. 보라 선은 중간유역, 분홍 선은 B 유역 경계이고 위쪽 가운데에 ID 1 = A, ID 2 = B 유출구 표시가 있다.
그림 2. D-무한대 비집수면적. 사면에서 흐름이 줄 하나로 모이지 않고 부채꼴로 퍼지는 모양이 보인다.

계산이 맞게 됐는지 유출구 셀로 한 번 대 봤다. A 유출구 셀의 SCA는 1,407,308인데, A 전체 유역(중간유역 + B)은 1,430,152 m²라 98.4%다. B 유출구 셀은 224,584로 B 유역 211,372 m²보다 6%가량 크다. D-무한대는 흐름을 두 셀에 나눠 보내는 방식이고 유역 경계는 D8로 그은 것이라, 유출구 한 셀 값이 유역 면적과 딱 맞지는 않는 것으로 보인다. 자릿수와 크기 순서가 맞으니 입력으로 쓰기에는 충분하다고 판단했다.

2단계: 경사

Geomorphometric Analysis → Slope에 같은 보정 DEM을 넣고 Units는 degrees로 두었다. WetnessIndex 설명에는 경사 입력 단위가 따로 적혀 있지 않은데, 이번 결과를 numpy로 ln(SCA/tan(경사°))로 다시 계산해 보니 맞았다(아래 독립 계산). 그래서 도 단위가 맞다. Z Conversion Factor는 29편 경험대로 비워 두었다. 경사는 크기만 보는 값이라 29편의 180° 뒤집힘과는 상관없지만, 비워도 결과가 같다면 굳이 넣을 이유가 없다.

보정 DEM의 경사는 0.020°~88.65°, 중앙값 28.3°다. 0°인 셀이 하나도 없다는 점이 중요하다. tan 0 = 0이면 TWI가 무한대로 간다. 18편 함몰지 보정에서 평탄지 증분(flat increment) 0.001을 넣어 메운 자리에 아주 작은 기울기가 생긴 덕분으로 보인다.

3단계: WetnessIndex

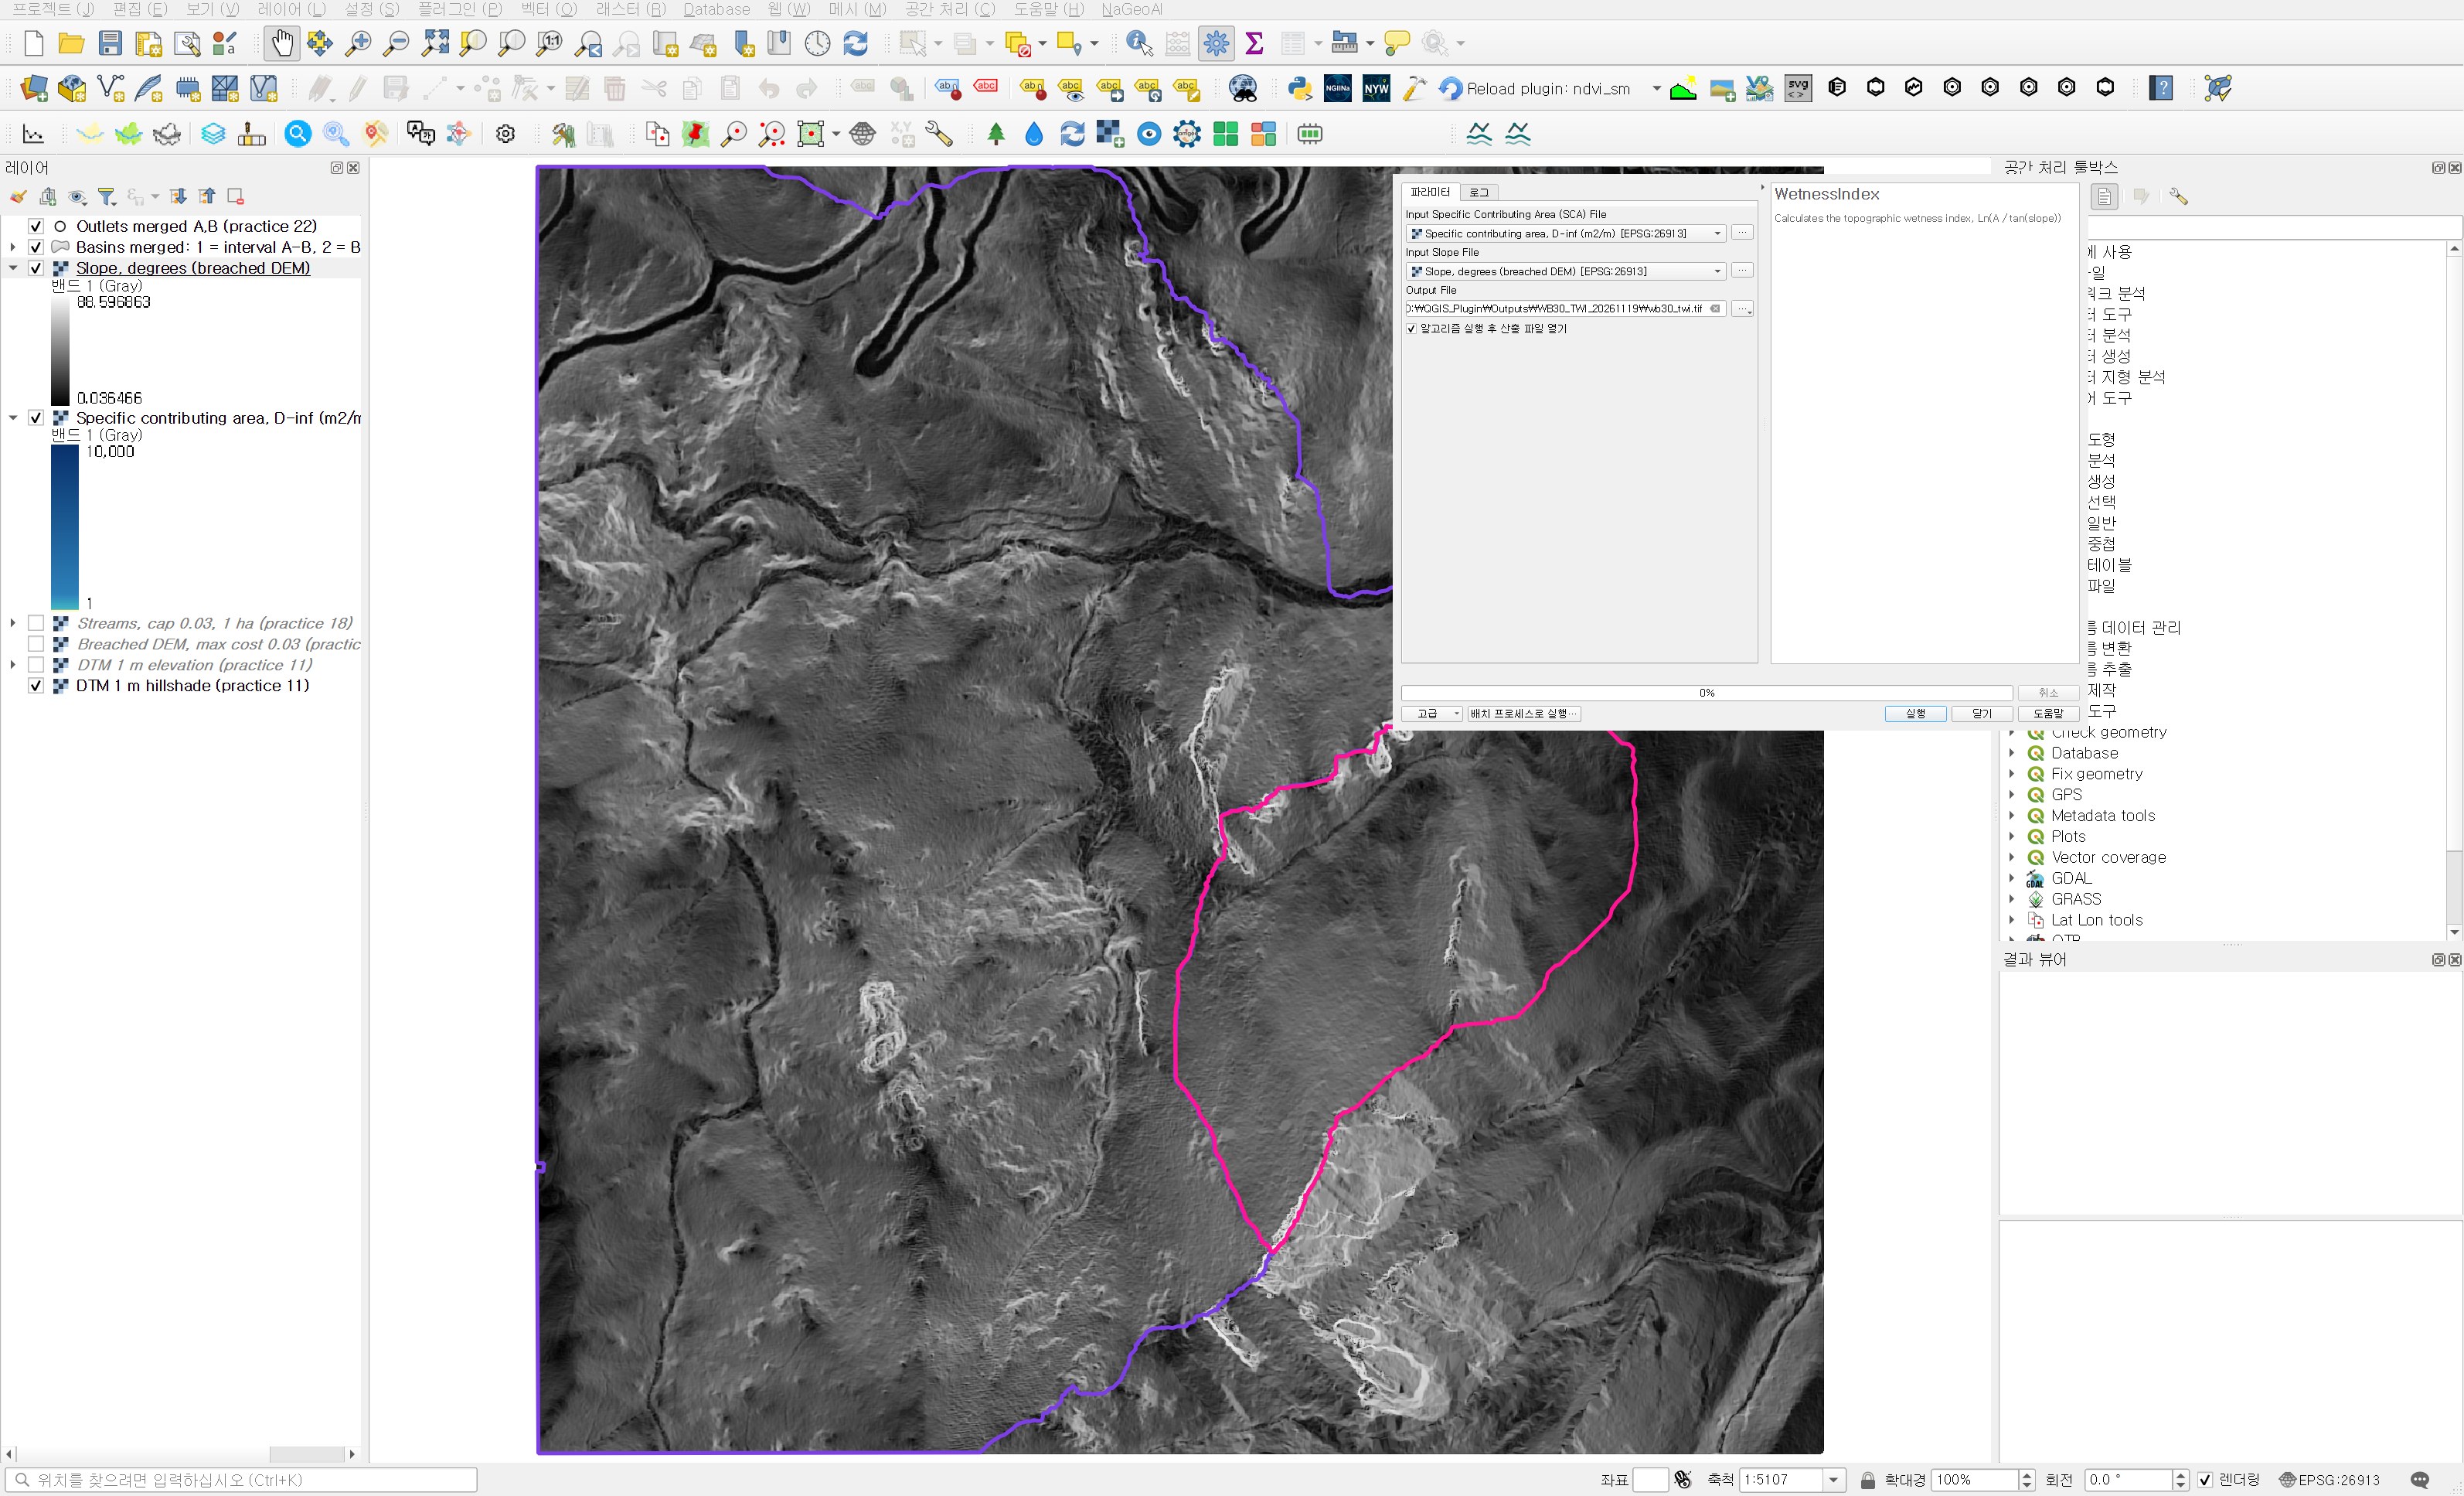
Geomorphometric Analysis → WetnessIndex는 입력란이 둘뿐이다. Input Specific Contributing Area (SCA) File에 1단계 결과, Input Slope File에 2단계 결과를 넣고 출력은 wb30_twi.tif로 했다.

QGIS WetnessIndex 대화상자. Input Specific Contributing Area (SCA) File은 Specific contributing area, D-inf (m2/m), Input Slope File은 Slope, degrees (breached DEM), Output File은 wb30_twi.tif다. 뒤 지도에는 회색조 경사 래스터와 분홍 B 유역 경계가 보인다.
그림 3. WetnessIndex 대화상자. 앞 두 단계 결과를 그대로 넣는다.

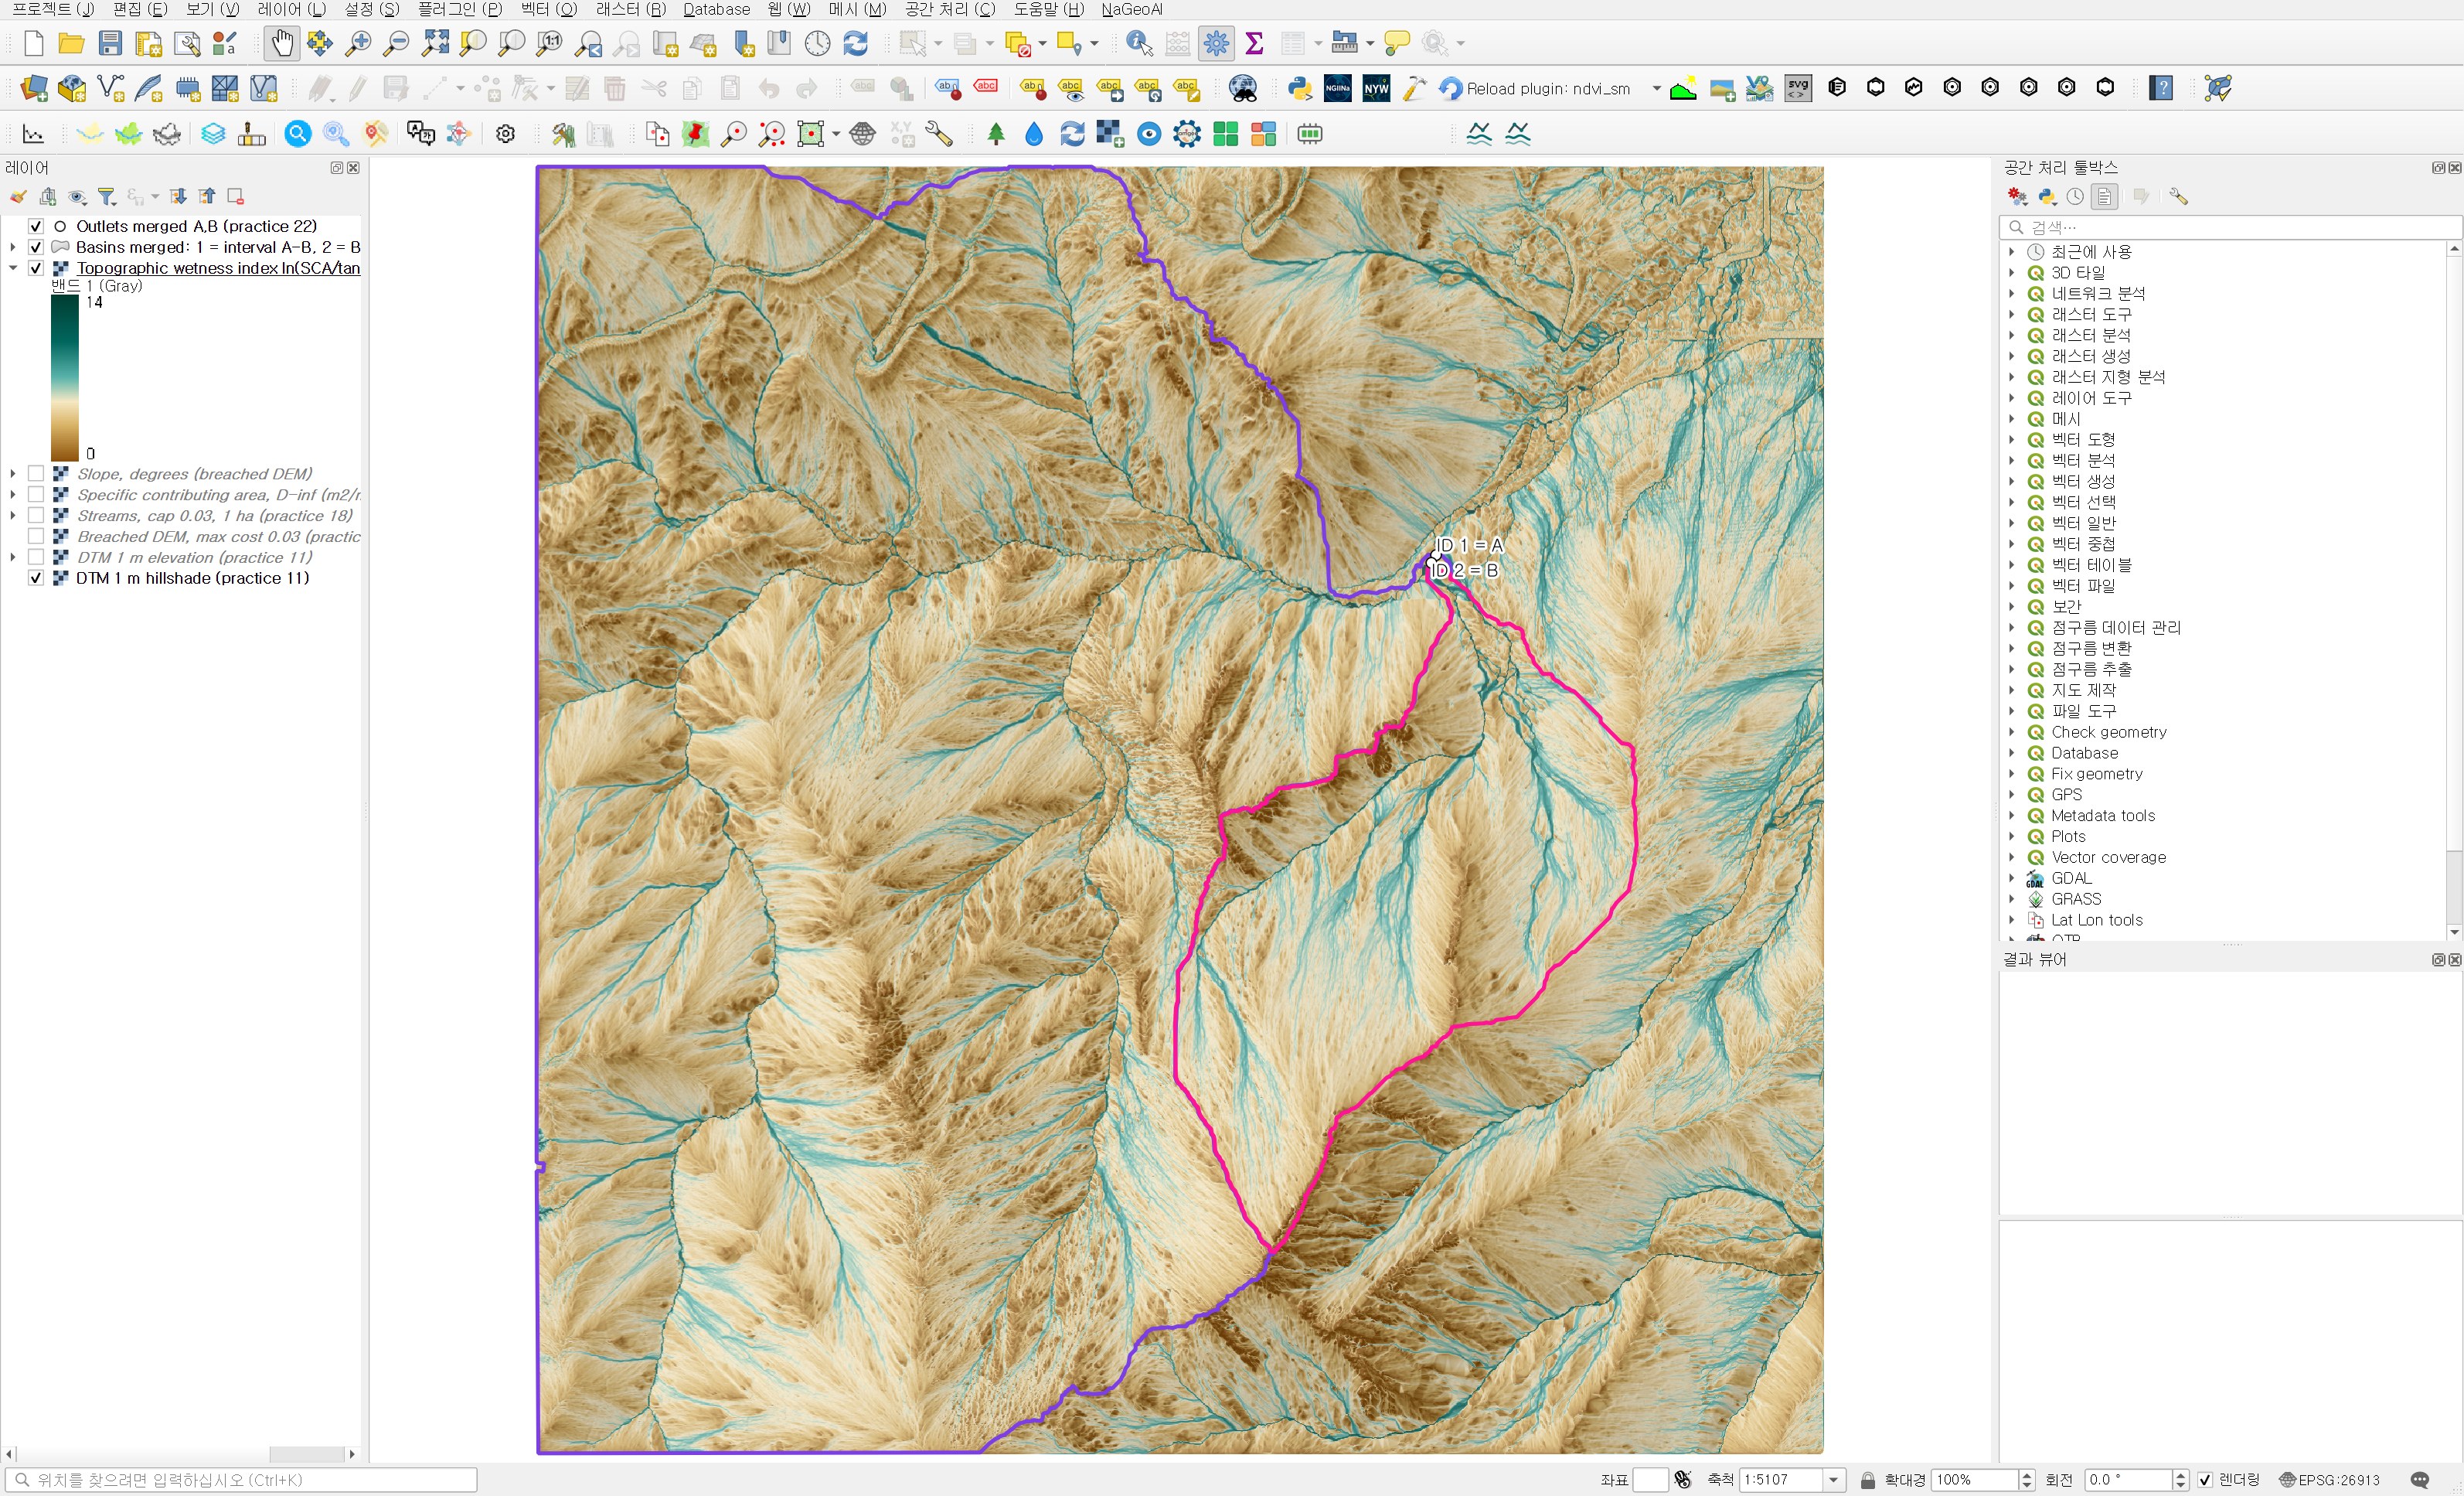
TWI는 −3.61~21.78, 중앙값 3.97이다. 음수는 SCA가 1에 가깝고 경사가 아주 급한 셀에서 나온다. 예를 들어 SCA 1, 경사 88°면 ln(1/tan 88°)이 약 −3.4다. 능선 바로 아래 급사면 셀들로 보인다. 지도는 0(갈색)에서 14(진한 청록)까지 칠했다.

지형습윤지수 지도. 범례는 0 갈색에서 14 진한 청록이다. 능선과 급사면은 갈색과 베이지, 골짜기와 사면의 오목한 줄기는 청록색이다. 보라 선은 중간유역, 분홍 선은 B 유역 경계다. B 유역 안에 청록 줄기가 촘촘하다.
그림 4. 지형습윤지수. 골짜기와 사면의 오목한 줄기가 청록으로 드러난다.

4단계: 유역별 구역통계

공간 처리 툴박스 → 래스터 분석 → 구역통계(Zonal statistics)를 썼다. 27~29편은 구간으로 나눈 래스터라 구역히스토그램이 맞았지만, TWI는 연속값이라 평균·중앙값·표준편차를 바로 뽑는 편이 낫다.

입력란값이유
입력 레이어Basins merged: 1 = interval A-B, 2 = B (practice 26)두 유역이 겹치지 않게 나뉜 폴리곤
래스터 레이어 / 밴드Topographic wetness index / 밴드 1
출력 칼럼 접두어twi_Shapefile 필드 이름 10자 제한 안에 twi_median까지 들어간다.
계산할 통계개수, 평균, 중앙값, 표준편차, 최소, 최대분포 모양을 볼 최소한의 묶음
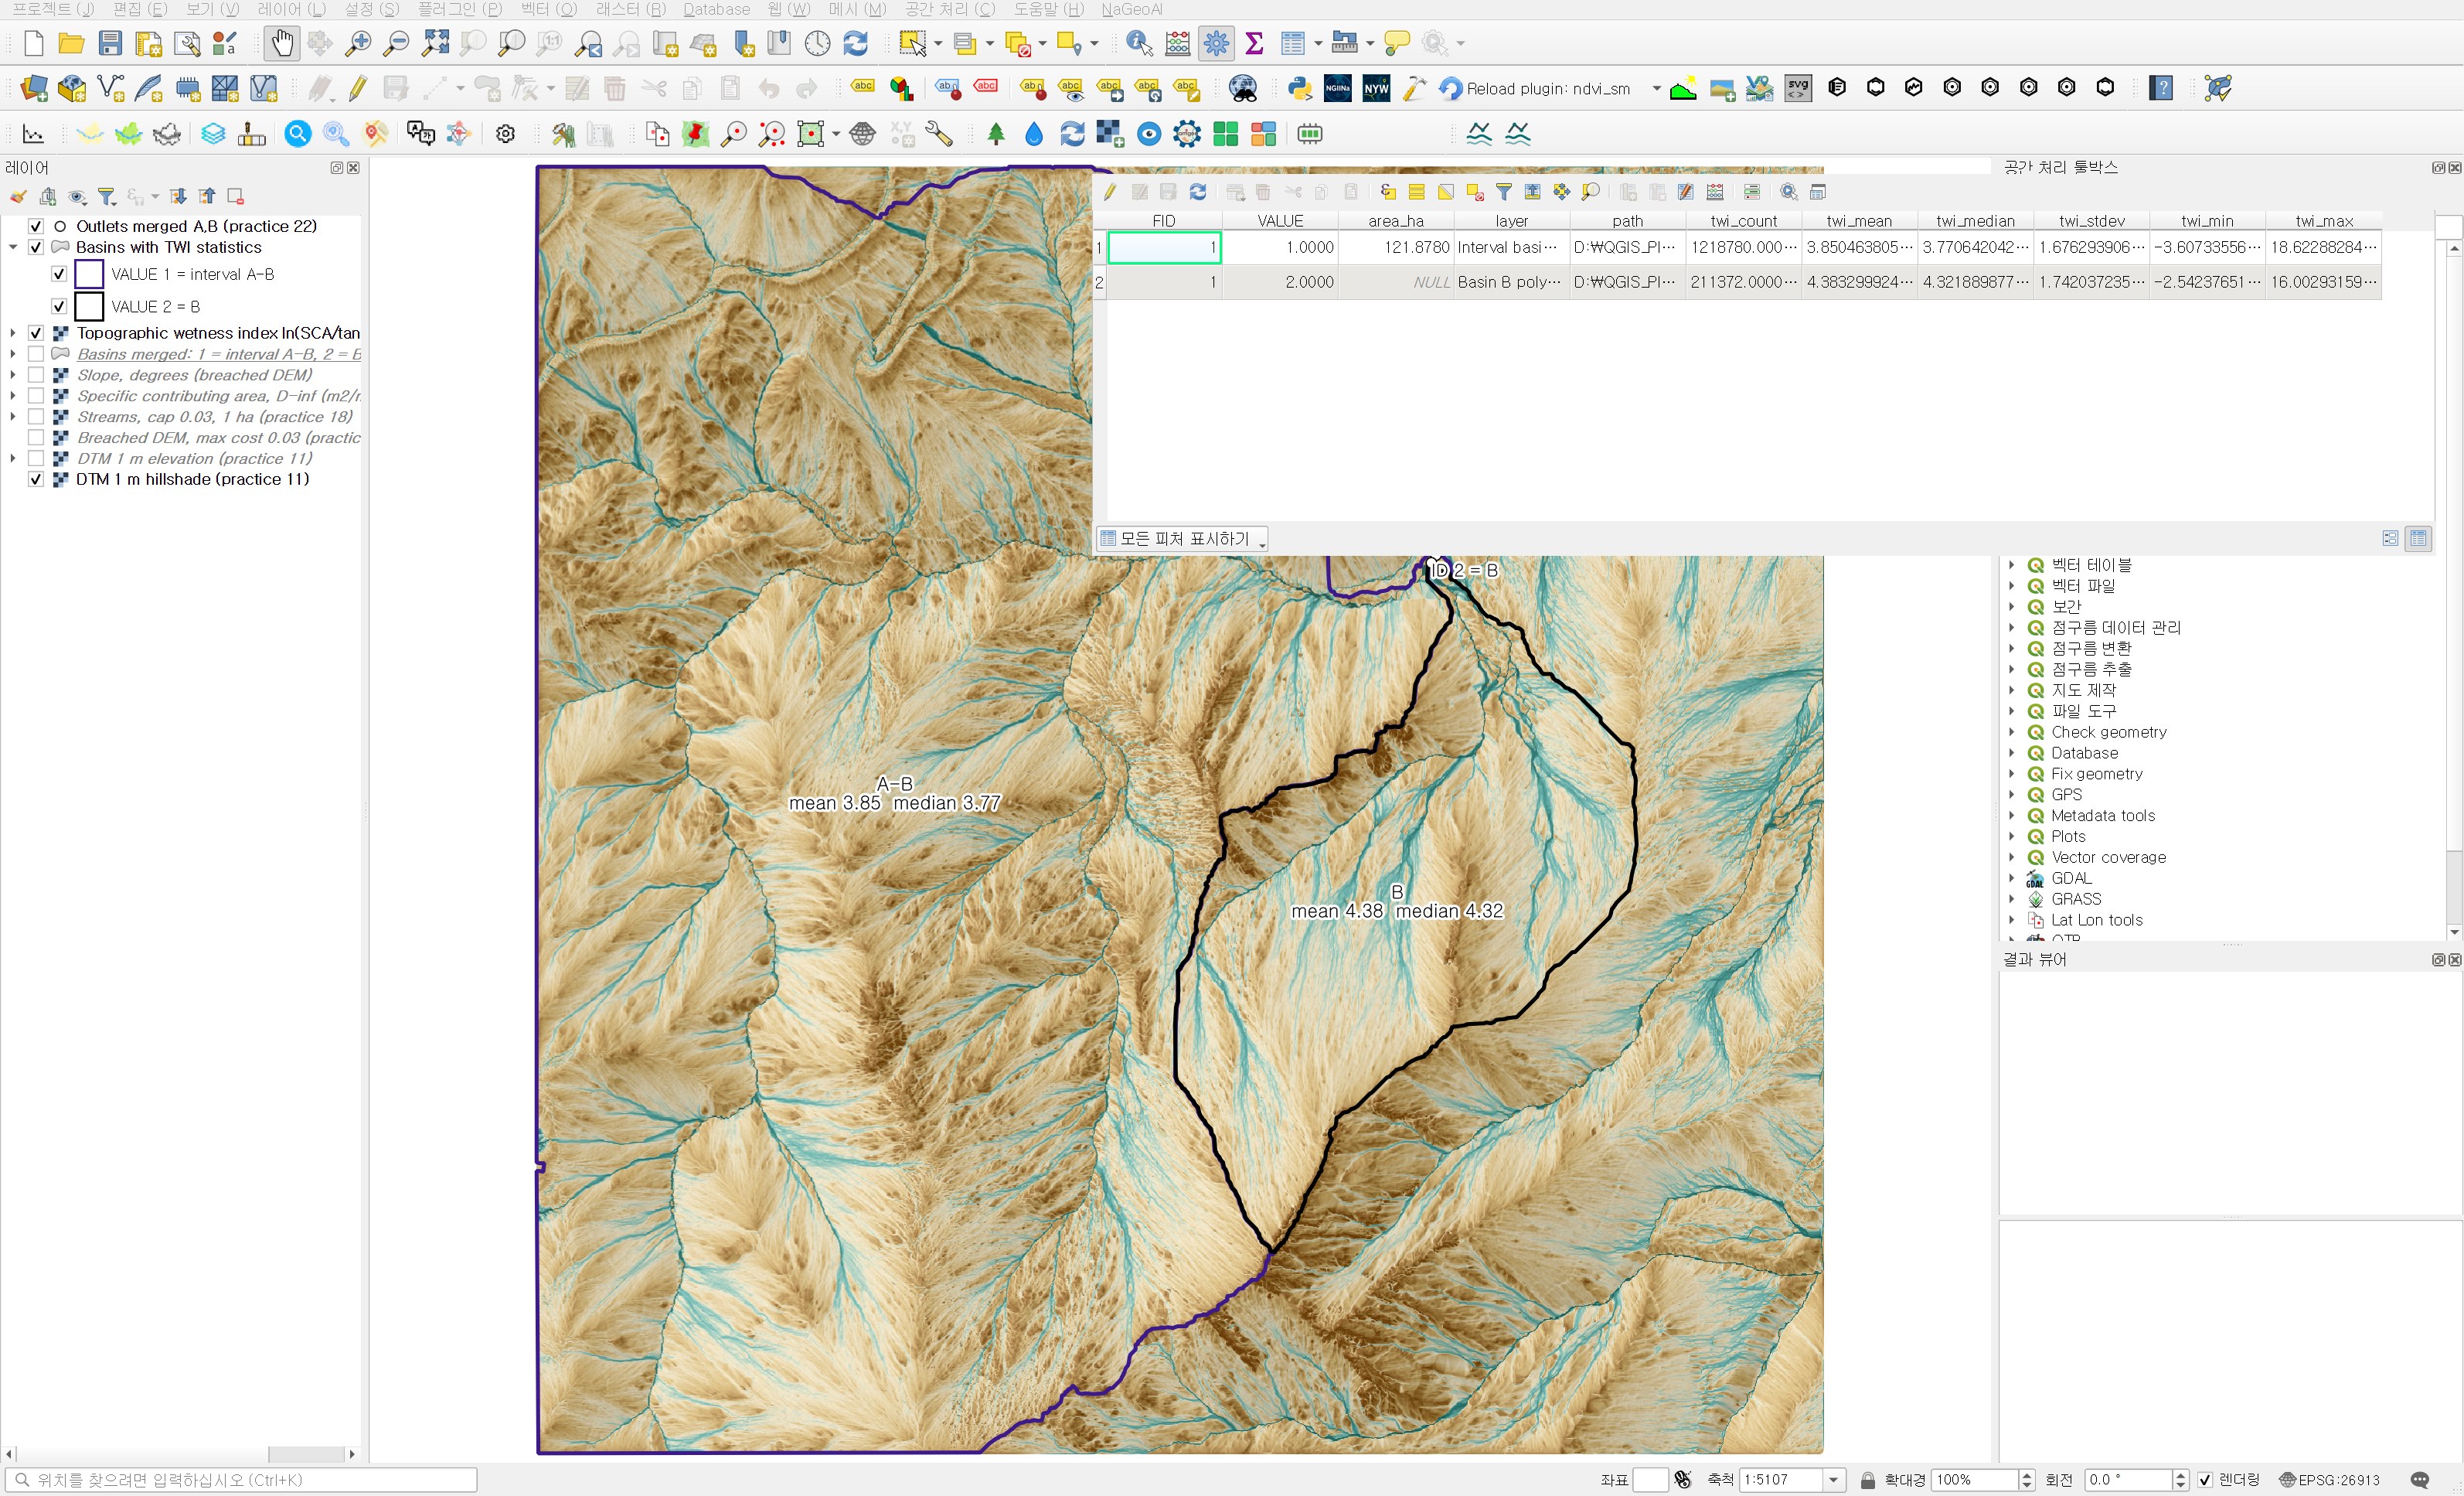
출력wb30_basin_twi_stats.shp
Basins with TWI statistics 속성 표와 지도. VALUE 1 행은 twi_count 1218780, twi_mean 3.850463805, twi_median 3.770642042, twi_stdev 1.676293906, twi_min -3.60733556, twi_max 18.62288284이고 VALUE 2 행은 twi_count 211372, twi_mean 4.383299924, twi_median 4.321889877, twi_stdev 1.742037235, twi_min -2.54237651, twi_max 16.00293159다. 지도에는 A-B mean 3.85 median 3.77, B mean 4.38 median 4.32 라벨이 있다.
그림 5. 구역통계 속성 표와 유역별 평균·중앙값 라벨.
항목중간유역 A−BB 유역
셀 수(= m²)1,218,780211,372
TWI 평균3.854.38
TWI 중앙값3.774.32
표준편차1.681.74
최소 / 최대−3.61 / 18.62−2.54 / 16.00
10~90백분위1.93 ~ 5.692.44 ~ 6.28
TWI 8 이상 면적 비율1.76%2.99%
TWI 2 미만 면적 비율10.86%6.41%

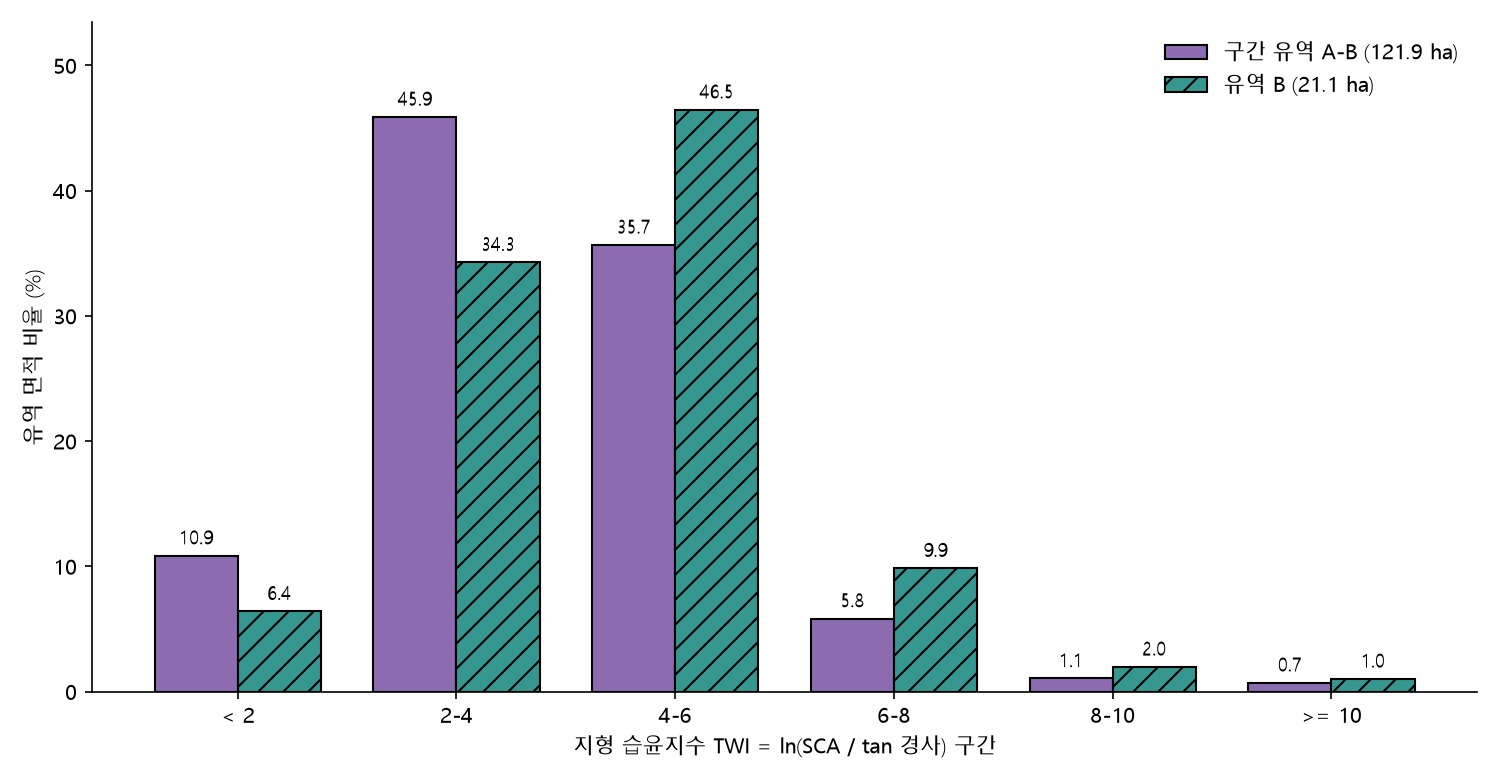
평균·중앙값 모두 B 유역이 0.5 남짓 높다. 분포 전체가 위로 밀려 있어서, 2 미만인 건조한 셀은 B 쪽이 적고 8 이상인 젖은 셀은 B 쪽이 많다. 구간을 2 단위로 나눠 그리면 차이가 더 잘 보인다. 중간유역은 2~4에 46%가 몰려 있고, B 유역은 4~6이 46%로 가장 많다.

TWI 구간별 유역 면적 비율 막대그래프. 가로축은 2 미만, 2-4, 4-6, 6-8, 8-10, 10 이상이다. 보라 막대(중간유역 A-B)는 10.9, 45.9, 35.7, 5.8, 1.1, 0.7%이고 빗금 친 청록 막대(B 유역)는 6.4, 34.3, 46.5, 9.9, 2.0, 1.0%다.
그림 6. TWI 2 단위 구간별 유역 면적 비율(검증 스크립트가 TWI 래스터를 다시 읽어 센 값으로 matplotlib에서 그림).

차이는 어디서 왔나

28편에서 두 유역의 경사 분포가 비슷하다는 걸 이미 봤다. 그렇다면 TWI 차이는 SCA 쪽에서 나왔을 가능성이 크다. TWI는 ln SCA − ln tan β로 쪼갤 수 있어서, 두 항의 유역 평균을 따로 내 봤다.

유역 평균중간유역 A−BB 유역차이(B − A−B)
ln SCA3.2623.762+0.500
−ln tan β0.5890.621+0.032
TWI3.8504.383+0.533
(참고) 경사 평균 / 중앙값30.3° / 30.1°29.5° / 30.7°

0.533 가운데 0.500이 ln SCA에서 왔다. 경사 항은 0.032밖에 안 된다. 같은 경사라도 B 유역 사면은 위에서 받는 면적이 평균적으로 더 크다는 뜻이다. 그림 2에서도 B 유역 안은 파랑 줄기가 촘촘하고, 중간유역은 노랑 바탕(SCA가 작은 셀)이 넓게 보인다. 29편에서 B 유역 사면의 85%가 북쪽 세 방위(북서·북·북동)를 향해 유출구 쪽으로 한데 모였던 것과 같은 그림으로 보인다. 다만 이건 지형 지수만 보고 한 해석이고, 실제 토양 수분 자료로 확인한 것은 아니다.

독립 계산으로 확인

출력 파일을 다시 읽는 별도 스크립트로 세 가지를 대 봤다.

  • Whitebox TWI와 numpy로 다시 계산한 ln(SCA/tan(경사°))는 유효 2,248,166개 셀에서 최대 차이 9.5×10⁻⁷이다. 사실상 같다. 이걸로 Slope 출력이 도 단위로 맞게 들어갔다는 것도 확인됐다.
  • Whitebox 경사를 Horn 3×3 식으로 따로 계산한 경사와 비교하면 차이 평균 0.56°, 중앙값 0.38°, 99백분위 3.04°다. 계산 방식이 Horn 식과 조금 다른 것으로 보이지만 TWI 해석을 바꿀 정도는 아니다.
  • 구역통계의 개수·평균·중앙값·표준편차·최소·최대를 셀 중심 기준으로 래스터화한 유역 마스크로 다시 계산하면 두 유역 모두 차이가 소수점 아래 14자리 수준이다. QGIS 표준편차는 모집단 표준편차와 같았다.

실무에서 챙길 것

  • SCA와 경사는 같은 DEM에서, 그리고 유역 경계를 만든 DEM에서 뽑는다. 보정 전 DTM을 쓰면 함몰지에서 흐름이 끊겨 SCA가 작게 나온다.
  • DInf Flow Accumulation의 Log-transform은 끈다. WetnessIndex 안에서 ln을 하므로 미리 로그를 씌우면 값이 엉뚱해진다. Output Type이 Specific Contributing Area인지도 꼭 본다.
  • 경사 0인 셀이 있으면 TWI가 무한대나 NoData가 된다. 실행 전에 경사 최솟값을 확인하고, 평탄지가 많은 자료라면 함몰지 보정의 평탄지 처리 옵션부터 점검한다.
  • TWI 절댓값은 DEM 공간해상도와 흐름 알고리즘에 크게 좌우된다. 1 m D-무한대 값과 30 m D8 값을 같은 기준으로 비교하면 안 된다. 다른 지역과 비교하려면 같은 공간해상도, 같은 도구로 다시 만든다.
  • TWI는 지형만 본 상대 지수다. 토양, 투수성, 강우를 반영하지 않으므로 "젖을 가능성이 큰 곳"을 고르는 데 쓰고, 실제 습윤 판단은 현장 자료나 토양도와 같이 본다.

다음 회차

이번에 만든 SCA와 경사를 그대로 쓰면 하천강도지수(Stream Power Index, SPI = SCA × tan β)도 바로 나온다. TWI가 물이 고이는 쪽을 본다면 SPI는 흐르는 물이 깎아 내는 힘 쪽을 본다. 다음 회차에서는 Whitebox StreamPowerIndex로 두 유역의 침식 잠재력을 같은 방식으로 비교해 보려고 한다.

작업 메모

이번 회차는 QGIS 시작 스크립트로 같은 대화상자에 값을 넣어 실행했고, 화면은 그때 캡처한 것이다. 원본 프로젝트는 그대로 두고 복사본(QGIS_Play_NaGeoAI_20261119_30_twi.qgz)에서 작업했다. 자료 출처는 USGS 3DEP(The National Map) 타일 13SDE474426이고, 원본 DTM은 재배포하지 않는다. 그림 6, 구간 비율, 백분위, ln SCA·ln tan β 분해, 유출구 셀 SCA와 독립 계산은 출력 파일을 다시 읽는 별도 스크립트로 만든 것이다. QGIS 3.44.15, WhiteboxTools v2.2.0(wbt_for_qgis 플러그인). SHA-256 앞 12자리:

  • 입력 보정 DEM 8e2a7592007c
  • 입력 병합 폴리곤 .shp / .dbf 235891ed214a / 67d3965a6d72
  • 비집수면적 371c0096063a
  • 경사 0971ac9f4ce6
  • 지형습윤지수 4138c6cf7b15
  • 구역통계 .shp / .dbf 235891ed214a / 43372958afcc

2026-11-18

Whitebox 실제 QGIS 실습 29 — 두 유역의 사면 방향을 8방위로 비교: Z 변환 계수 1.0이 향을 180° 뒤집었다

27편과 28편에서 두 유역의 표고와 경사를 같은 방식(구간 재분류 + 구역히스토그램)으로 비교했다. 이번에는 경사향(aspect)이다. 경사향은 사면이 내려가는 쪽을 북쪽에서 시계 방향으로 잰 각도다. 0°(360°)가 북향, 90°가 동향, 180°가 남향이다. 일사량, 눈 녹는 시기, 식생과 토양 수분이 모두 경사향을 따라 달라지기 때문에 유역 단위로 "어느 쪽을 바라보는 사면이 많은가"를 먼저 보는 경우가 많다.

순서는 앞 두 편과 같다. Whitebox Aspect로 향 래스터를 만들고, 테이블로 재분류(Reclassify by table)로 8방위 코드를 붙인 뒤, 구역히스토그램(Zonal histogram)으로 유역별 셀 수를 센다. 그런데 첫 실행에서 결과가 통째로 180° 뒤집혀 나왔다. 이번 글은 그 이야기가 절반이다.

자료

28편 입력을 새 폴더로 복사해 썼다. 복사본 DTM 해시는 원본과 같다.

입력원래 출처내용
wb29_input_dtm1m.tif11편 DTMUSGS 3DEP 타일 13SDE474426, NAD83 UTM 13N EPSG:26913, 1500×1500 셀, 1 m, NoData 1,834개 셀
wb29_input_basins_merged.shp26편 병합 폴리곤VALUE 1 = 중간유역(A−B) 1,218,780 m², VALUE 2 = B 유역 211,372 m²

첫 실행: Z 변환 계수 1.0을 넣었더니

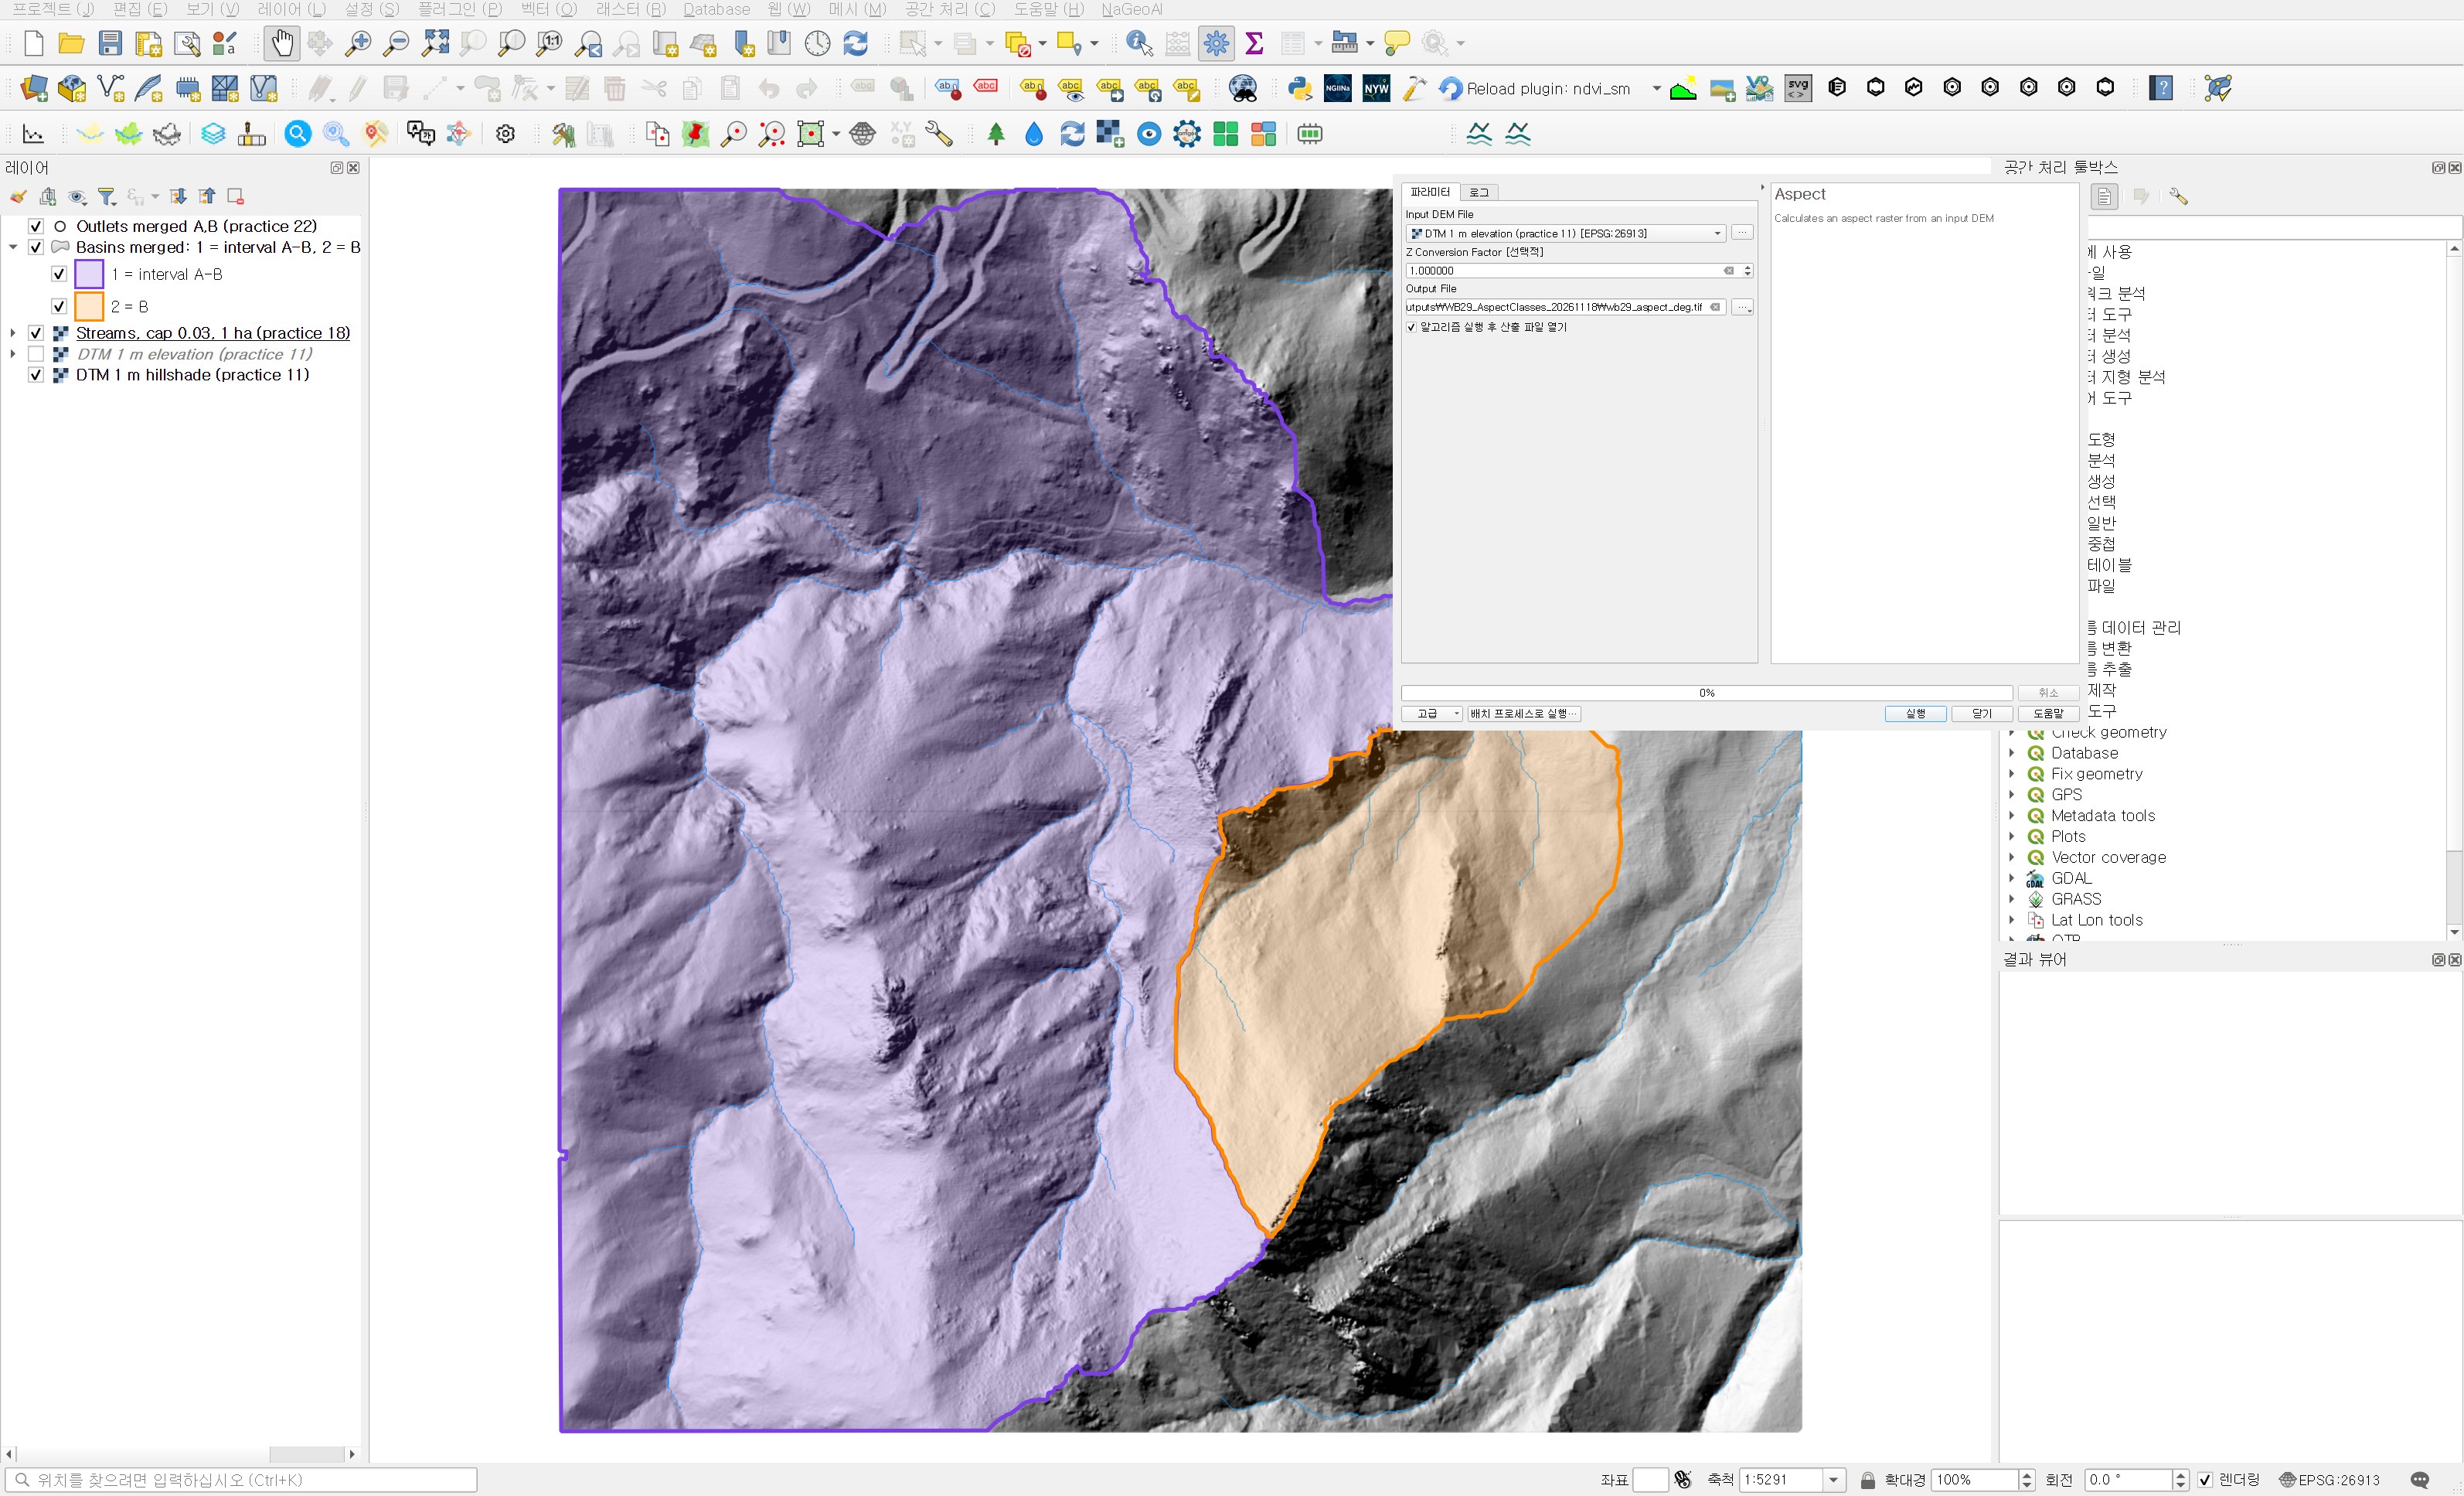
공간 처리 툴박스 → WhiteboxTools → Geomorphometric Analysis → Aspect를 열면 입력란은 셋뿐이다. 28편 Slope 때처럼 Z Conversion Factor에 1.0을 넣었다. 수평과 표고가 모두 미터인 투영 DTM이니 1.0이 맞는 값이라고 생각했다.

QGIS Whitebox Aspect 대화상자. Input DEM File은 DTM 1 m elevation (practice 11), Z Conversion Factor는 1.000000, Output File은 wb29_aspect_deg.tif다. 뒤 지도에는 음영기복도 위에 보라색 중간유역과 주황색 B 유역이 칠해져 있다.
그림 1. 첫 실행의 Aspect 대화상자. Z Conversion Factor에 1.0을 넣었다.

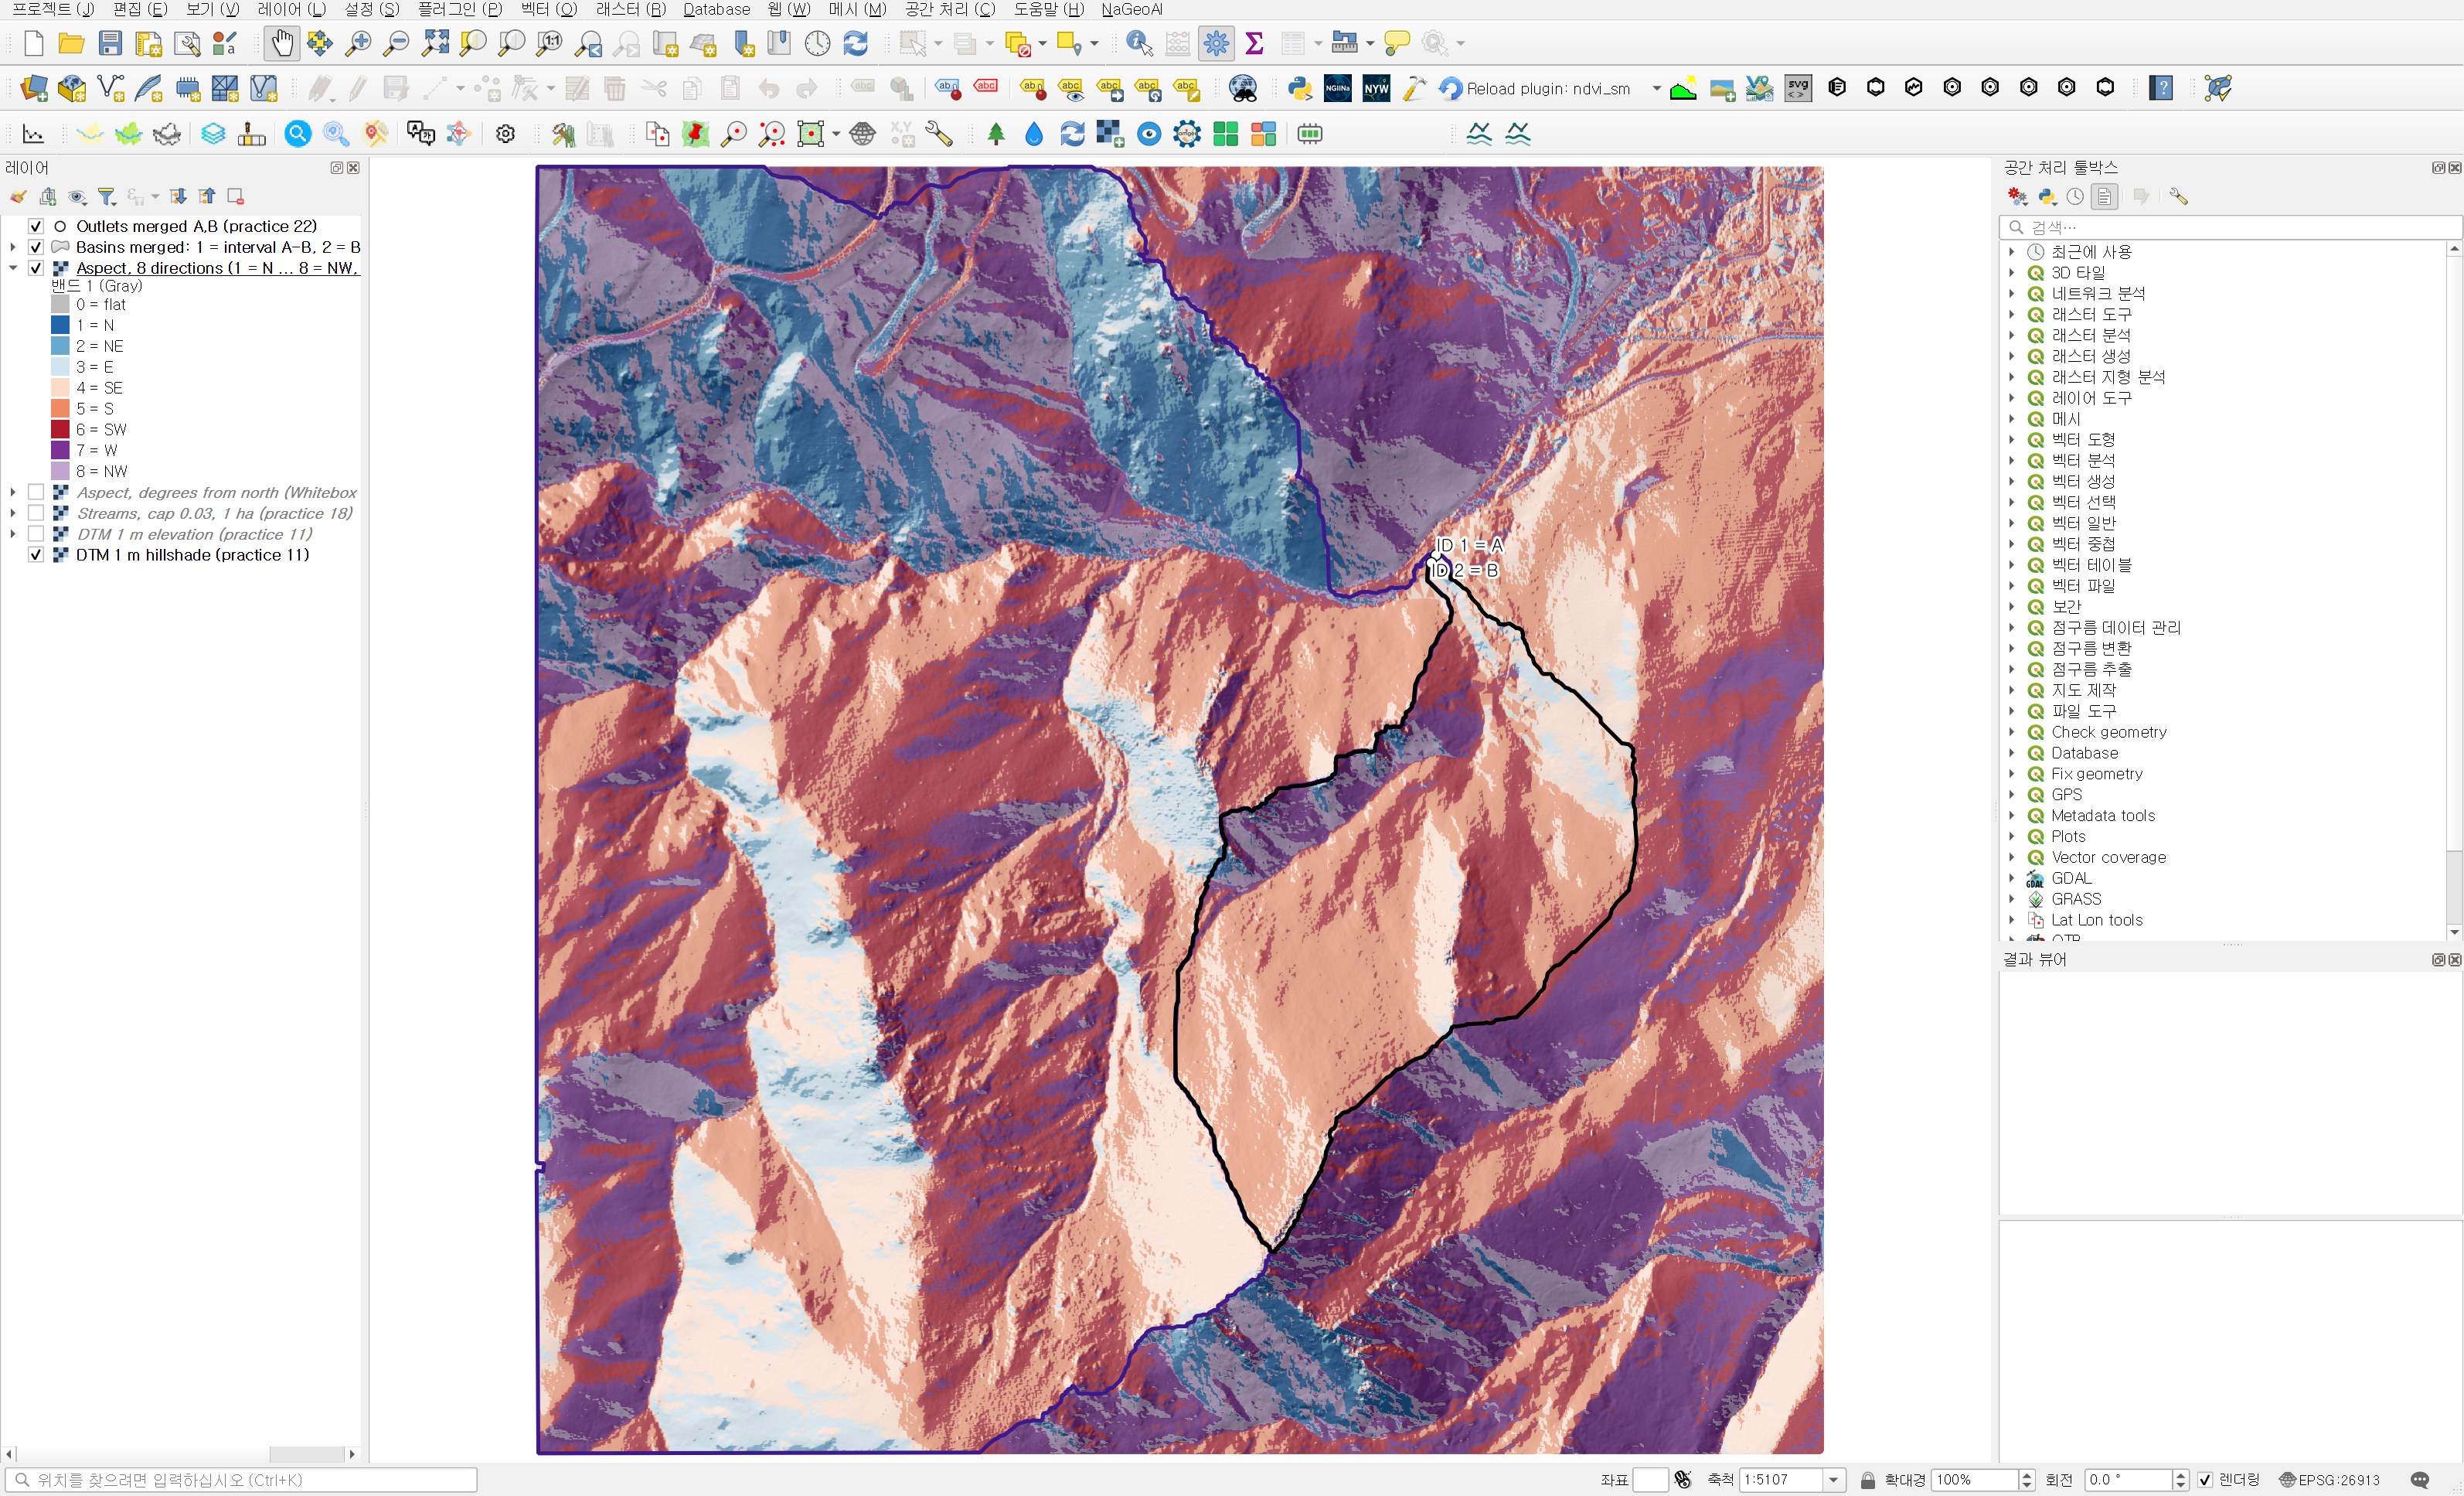
실행은 몇 초 만에 끝났고 오류도 없었다. 8방위로 재분류해 지도에 올렸더니 B 유역 안이 거의 다 남향 계열(주황·빨강)이었다. 구역히스토그램으로 세어 보니 B 유역의 남동·남·남서 비율이 85.18%였다.

첫 실행 결과의 8방위 향 지도. 범례는 0 = flat 회색, 1 = N 진한 파랑부터 8 = NW 연보라까지다. 검은 선으로 둘러싼 B 유역 안은 대부분 연주황과 빨강(남동, 남, 남서)이고, 북쪽 골짜기 너머 사면은 파랑 계열이다.
그림 2. Z 변환 계수 1.0으로 만든 경사향을 8방위로 나눈 지도. B 유역이 남향으로 나왔지만 실제 지형과 반대다.

여기서 이상하다고 봤다. B 유역 유출구(그림의 ID 2 = B)는 유역 북쪽 끝에 있다. 물이 북쪽 유출구로 모인다면 지면은 대체로 북쪽으로 낮아져야 하고, 그러면 북향 사면이 많아야 한다. DTM에서 직접 확인하니 B 유역 안에서 표고와 행 번호(남쪽으로 갈수록 커짐)의 상관계수가 0.966이었다. 남쪽이 높고 북쪽이 낮다. 남향 85%는 지형과 맞지 않는다.

원인 좁히기

세 가지를 따로 확인했다.

  • 최급 하강 방향과 대조. DTM에서 임의로 3,000개 셀을 뽑아 이웃 8개 셀 중 가장 가파르게 내려가는 쪽을 구했다. Whitebox 경사향이 그 방향과 45° 안으로 맞은 셀은 2개, 135° 이상 어긋난 셀은 2,945개였다.
  • numpy Horn 3×3 경사향과 대조. 독립 계산한 경사향과 비교하니 차이의 중앙값이 179.0°였다. 방향 하나가 아니라 전체가 정반대였다.
  • Whitebox를 직접 실행. QGIS 밖에서 같은 whitebox_tools.exe(v2.2.0)로 같은 DTM에 Aspect를 돌렸다. Z 변환 계수를 빼면 표본 셀의 경사향이 91.36°, --zfactor=1.0을 붙이면 271.36°였다. 압축 옵션이나 처리 스레드 수는 결과를 바꾸지 않았다. 북동쪽이 높고 남서쪽을 바라보는 가상의 평면(정답 225°)으로 해 봐도 계수를 빼면 225°, 1.0을 넣으면 45°가 나왔다.

그러니 이 버전에서는 Aspect에 Z 변환 계수를 값으로 넘기면 경사향이 180° 돌아간다고 봐야 한다. 첫 실행 결과와 아래 최종 결과를 셀마다 비교하면 유효한 2,248,165개 셀 모두 정확히 180°(오차 0.01° 안) 차이였다. 도구 내부에서 왜 그렇게 되는지는 확인하지 못했다. 28편 Slope에도 1.0을 넣었지만 경사는 방향이 없는 크기 값이라 영향이 없고, 그때 Horn 3×3과 비교한 평균 차이도 0.56°였다.

다시 실행: Z 변환 계수는 비워 둔다

입력란값이유
Input DEM FileDTM 1 m elevation (practice 11)지면점 DTM. DSM이면 건물 벽과 수관 가장자리가 경사향을 어지럽힌다
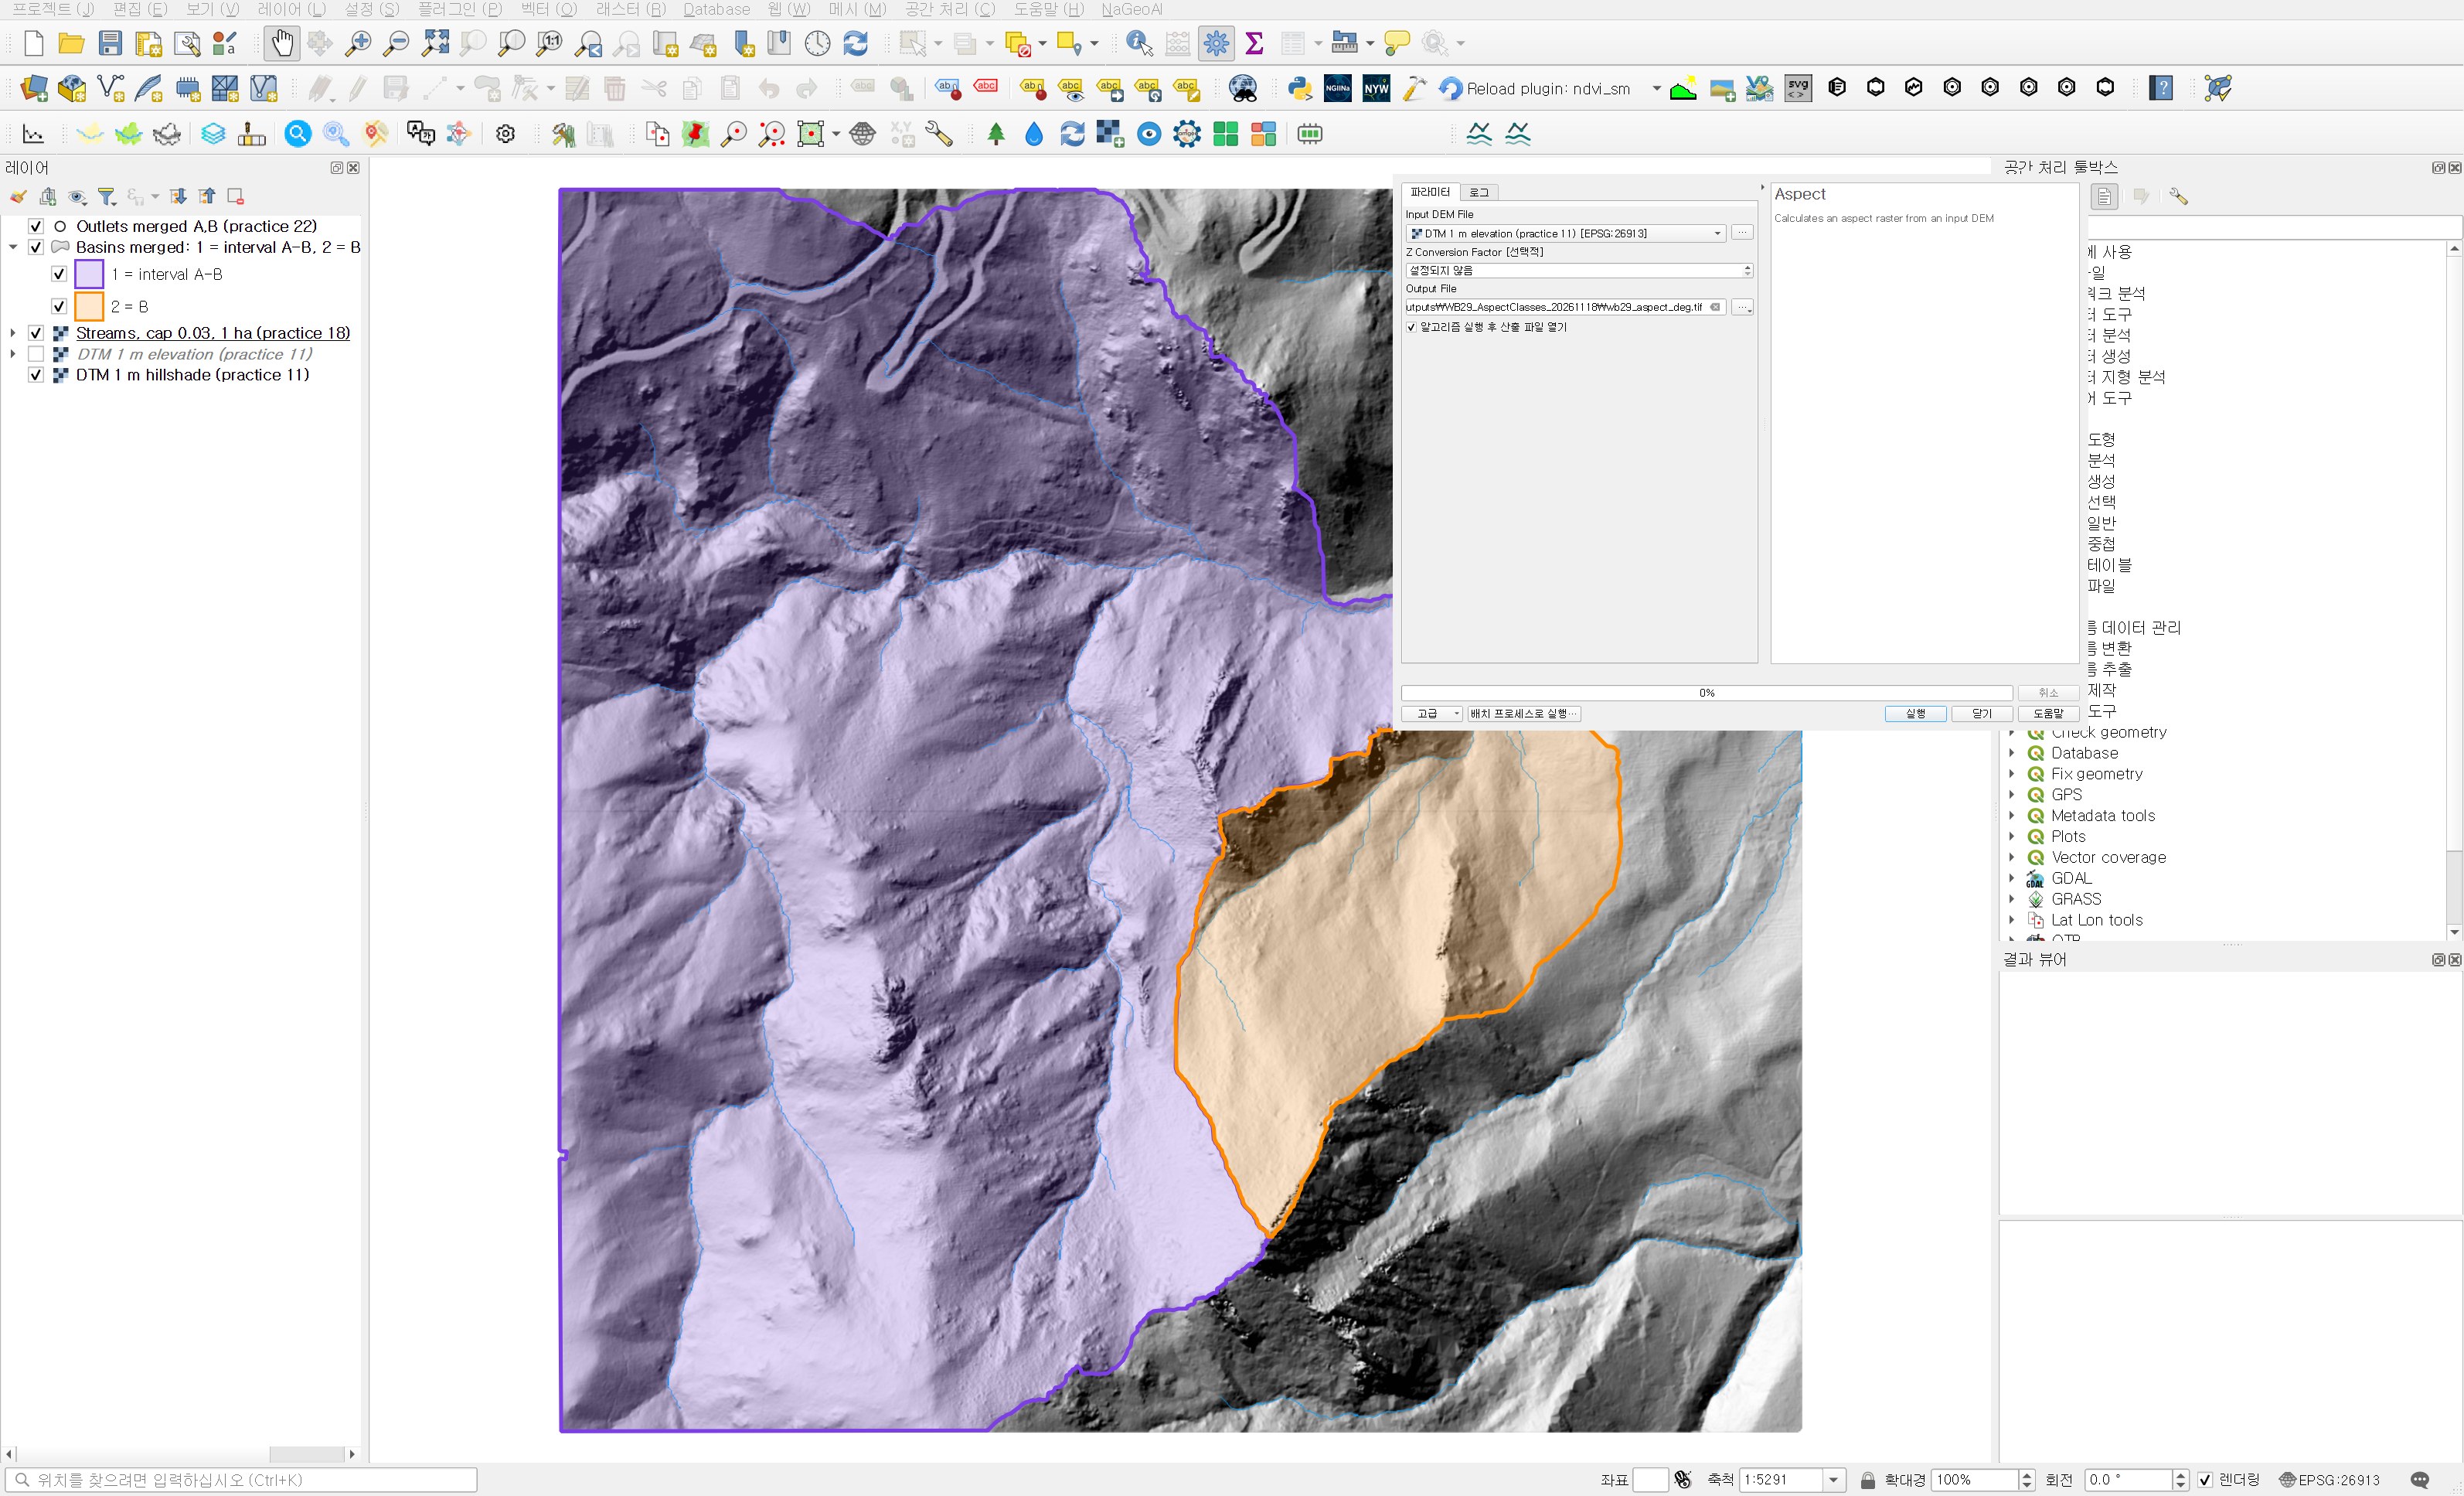
Z Conversion Factor비워 둠(설정되지 않음)선택 항목이다. 값을 넣으면 위처럼 경사향이 뒤집혔다
Output Filewb29_aspect_deg.tif첫 실행 출력은 다른 폴더로 옮겨 보관했다
다시 연 Whitebox Aspect 대화상자. Z Conversion Factor [선택적] 셀이 설정되지 않음으로 비어 있고, Input DEM File은 DTM 1 m elevation (practice 11), Output File은 wb29_aspect_deg.tif다.
그림 3. 두 번째 실행. Z Conversion Factor 셀을 비워 두었다.

이렇게 실행하면 플러그인이 만드는 명령줄에서 --zfactor가 빠진다. 결과는 float32, NoData 1,834개 셀(DTM과 같음), 값 범위 0.0002°~359.9999°다. 값이 −1인 셀이 딱 1개 있다. Whitebox가 방향을 정하지 못한 셀에 쓰는 값으로 보인다. 가상 평면 시험에서는 정확히 남북으로만 기운 면(동서 기울기 0)도 −1이 나왔다. 실제 지형에서는 그런 셀이 드물지만, 계단식 인공 지형이 많은 자료라면 −1 셀 수를 한 번 세어 볼 만하다.

8방위로 재분류

45°씩 8방위로 나누되, 북쪽은 0°를 사이에 두고 337.5~360°와 0~22.5°로 갈라져 있어 두 행에 같은 코드 1을 줬다. 음수(−1)는 평탄지 코드 0으로 따로 뺐다. 코드는 1 = N부터 시계 방향으로 8 = NW까지라 히스토그램 필드 h_1~h_8이 방위 순서가 된다.

입력란값이유
래스터 레이어Aspect, degrees from north (Whitebox Aspect)방금 만든 향
밴드 번호밴드 1
재분류 테이블10행: −1000~0 → 0, 0~22.5 → 1, 22.5~67.5 → 2, 67.5~112.5 → 3, 112.5~157.5 → 4, 157.5~202.5 → 5, 202.5~247.5 → 6, 247.5~292.5 → 7, 292.5~337.5 → 8, 337.5~361 → 1북쪽이 0°를 넘나드는 것을 두 행으로 처리. 마지막 최대값을 361로 둬 360°에 아주 가까운 셀이 빠지지 않게 했다
NODATA 값 산출−9999
범위 경계최소 <= 값 < 최대22.5°처럼 경계에 걸린 셀을 시계 방향 다음 방위로 넣는다
Use NoData when no range matches value체크
산출 데이터 유형Int16
재분류된 래스터wb29_aspect_8dir.tif
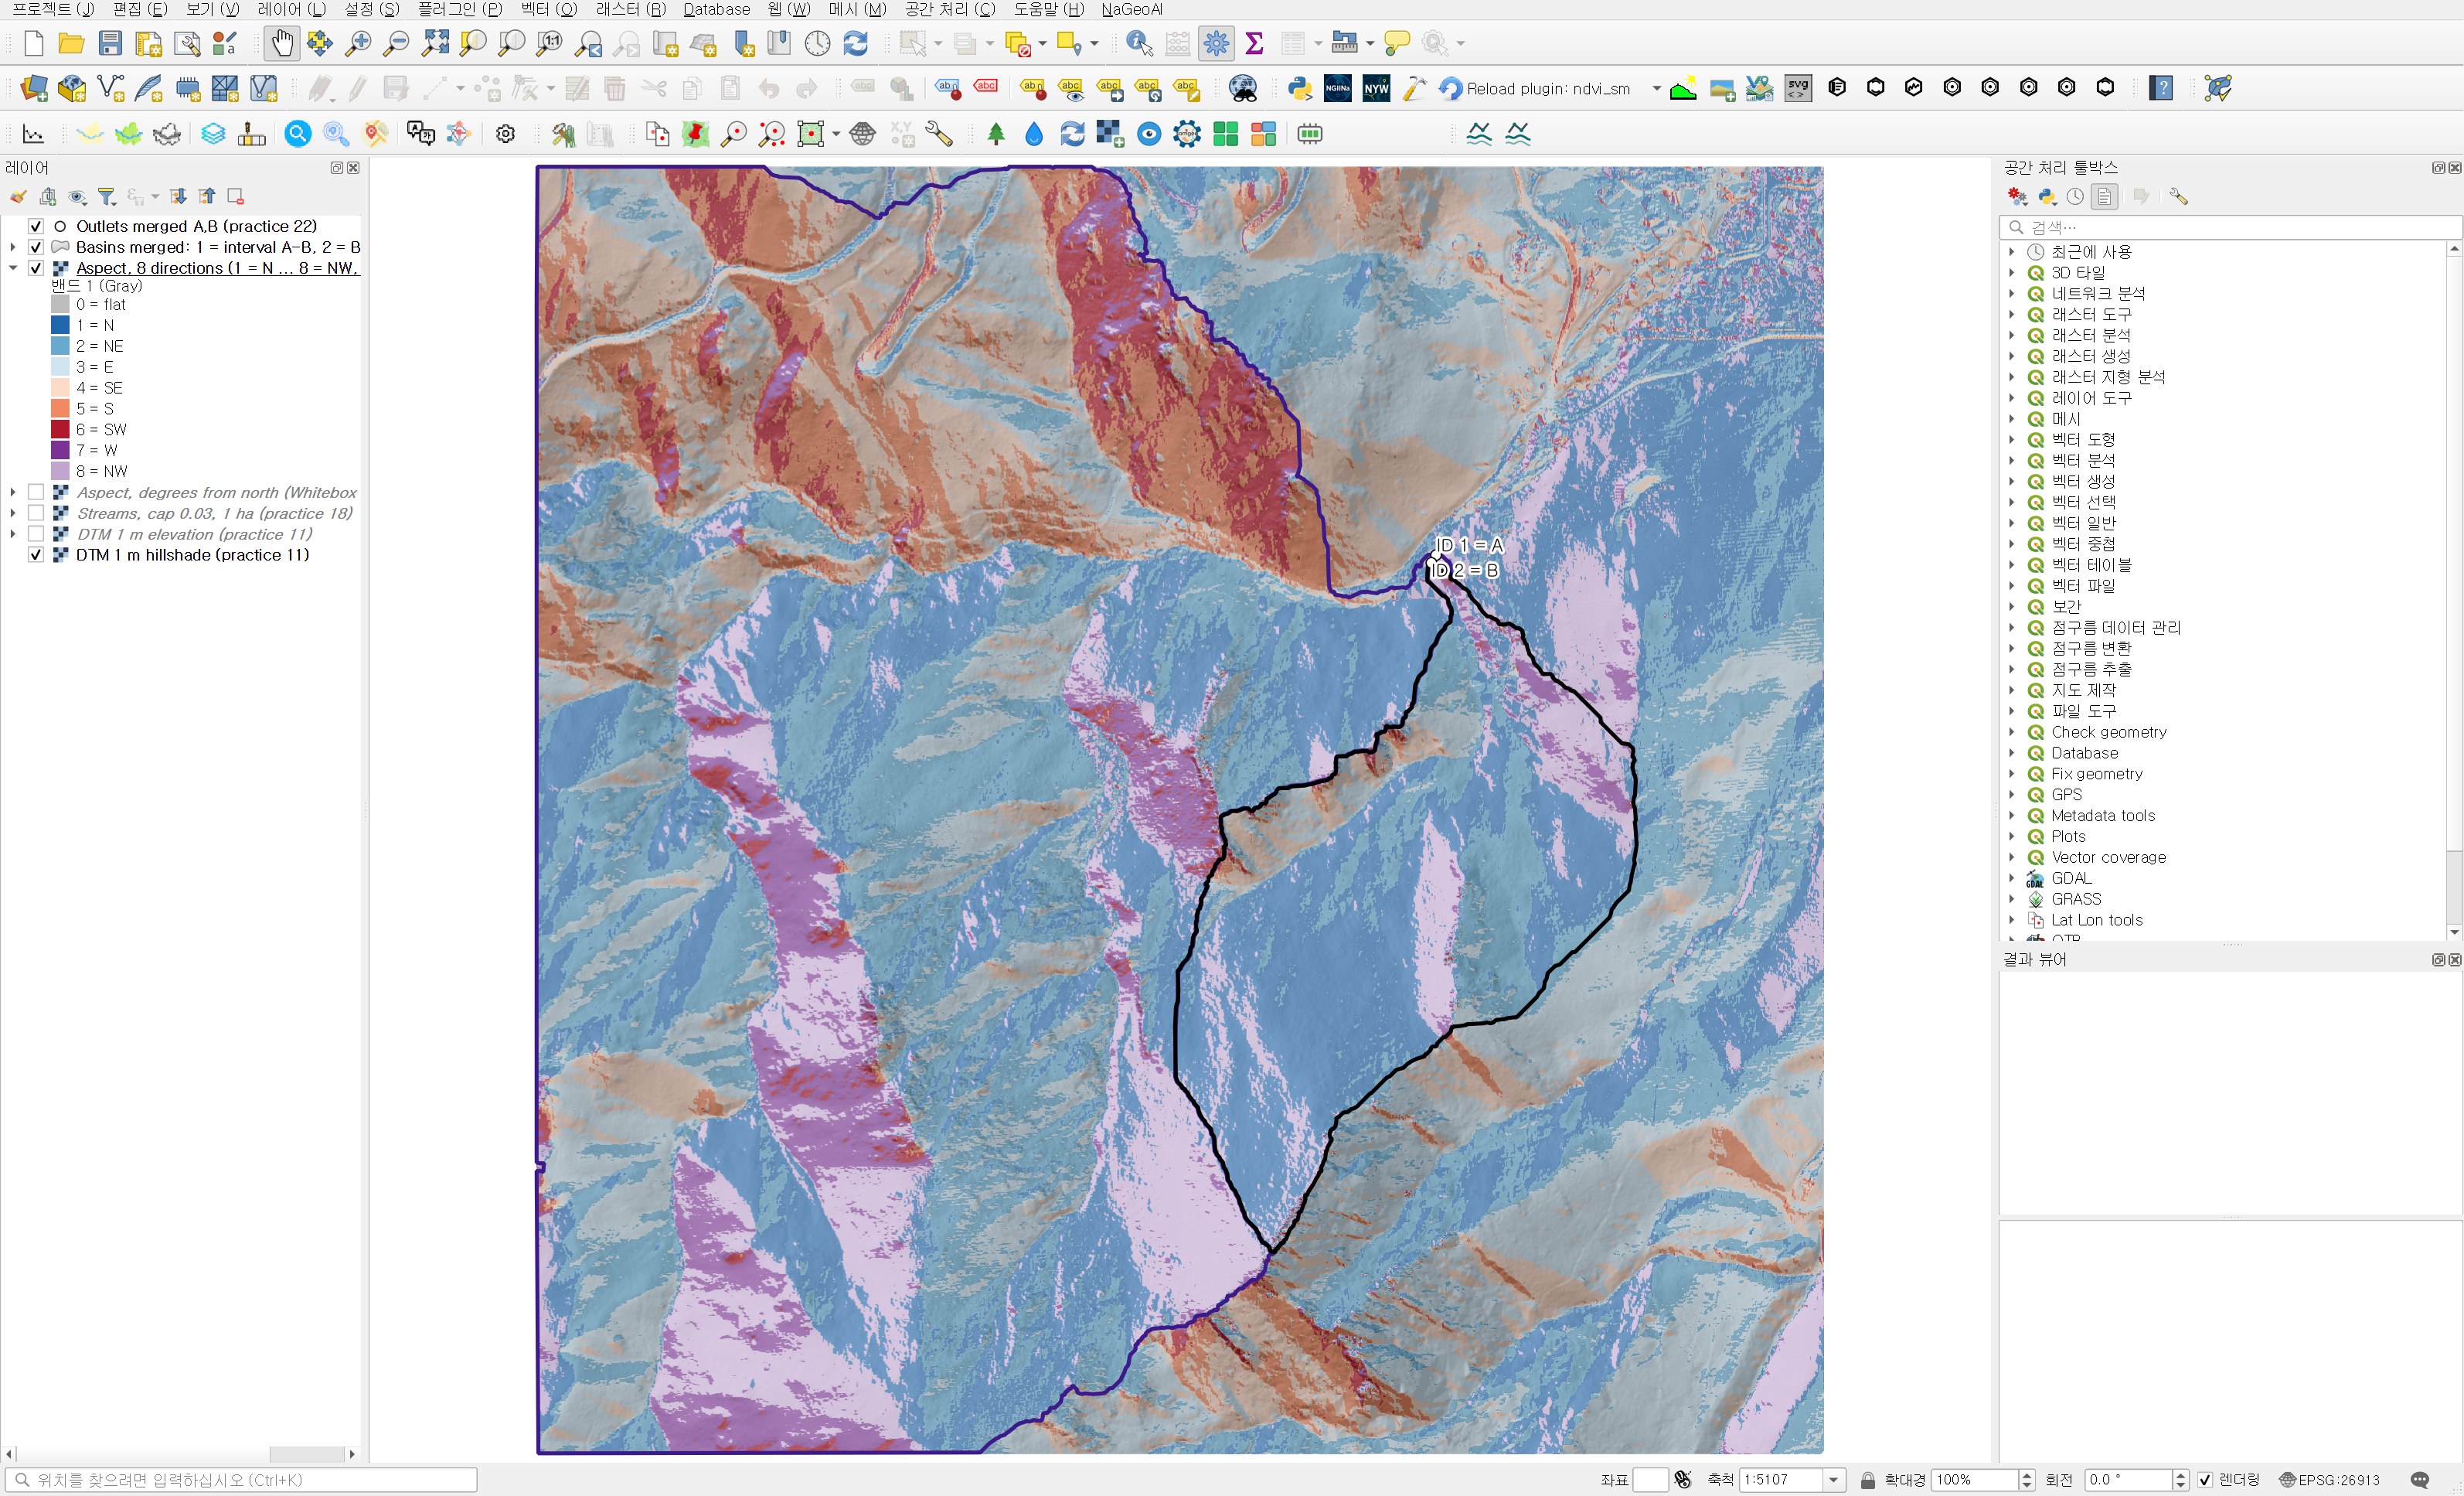
Z 변환 계수를 비우고 만든 8방위 향 지도. 검은 선의 B 유역 안은 대부분 파랑 계열(북, 북동)이고 가장자리에 연보라(북서)가 섞여 있다. 왼쪽 큰 중간유역은 파랑과 연파랑이 많고 가운데 골짜기를 따라 분홍과 보라(서, 북서) 띠가 있으며, 북쪽 골짜기 너머 사면은 주황과 빨강이다.
그림 4. 최종 8방위 향 지도. 이제 B 유역이 북쪽 유출구를 향한 북·북동 사면으로 나온다.

그림 2와 나란히 놓으면 색이 정확히 맞바뀌어 있다. 파랑이던 곳은 주황·빨강으로, 주황이던 곳은 파랑으로 바뀌었다.

유역별 방위 면적

입력란값이유
래스터 레이어Aspect, 8 directions (1 = N … 8 = NW, 0 = flat)
밴드 번호밴드 1
구역을 담고 있는 벡터 레이어Basins merged: 1 = interval A-B, 2 = B (practice 26)
산출 열 접두어h_h_0(평탄지)~h_8(NW)
산출 구역wb29_basin_aspect_histogram.shp
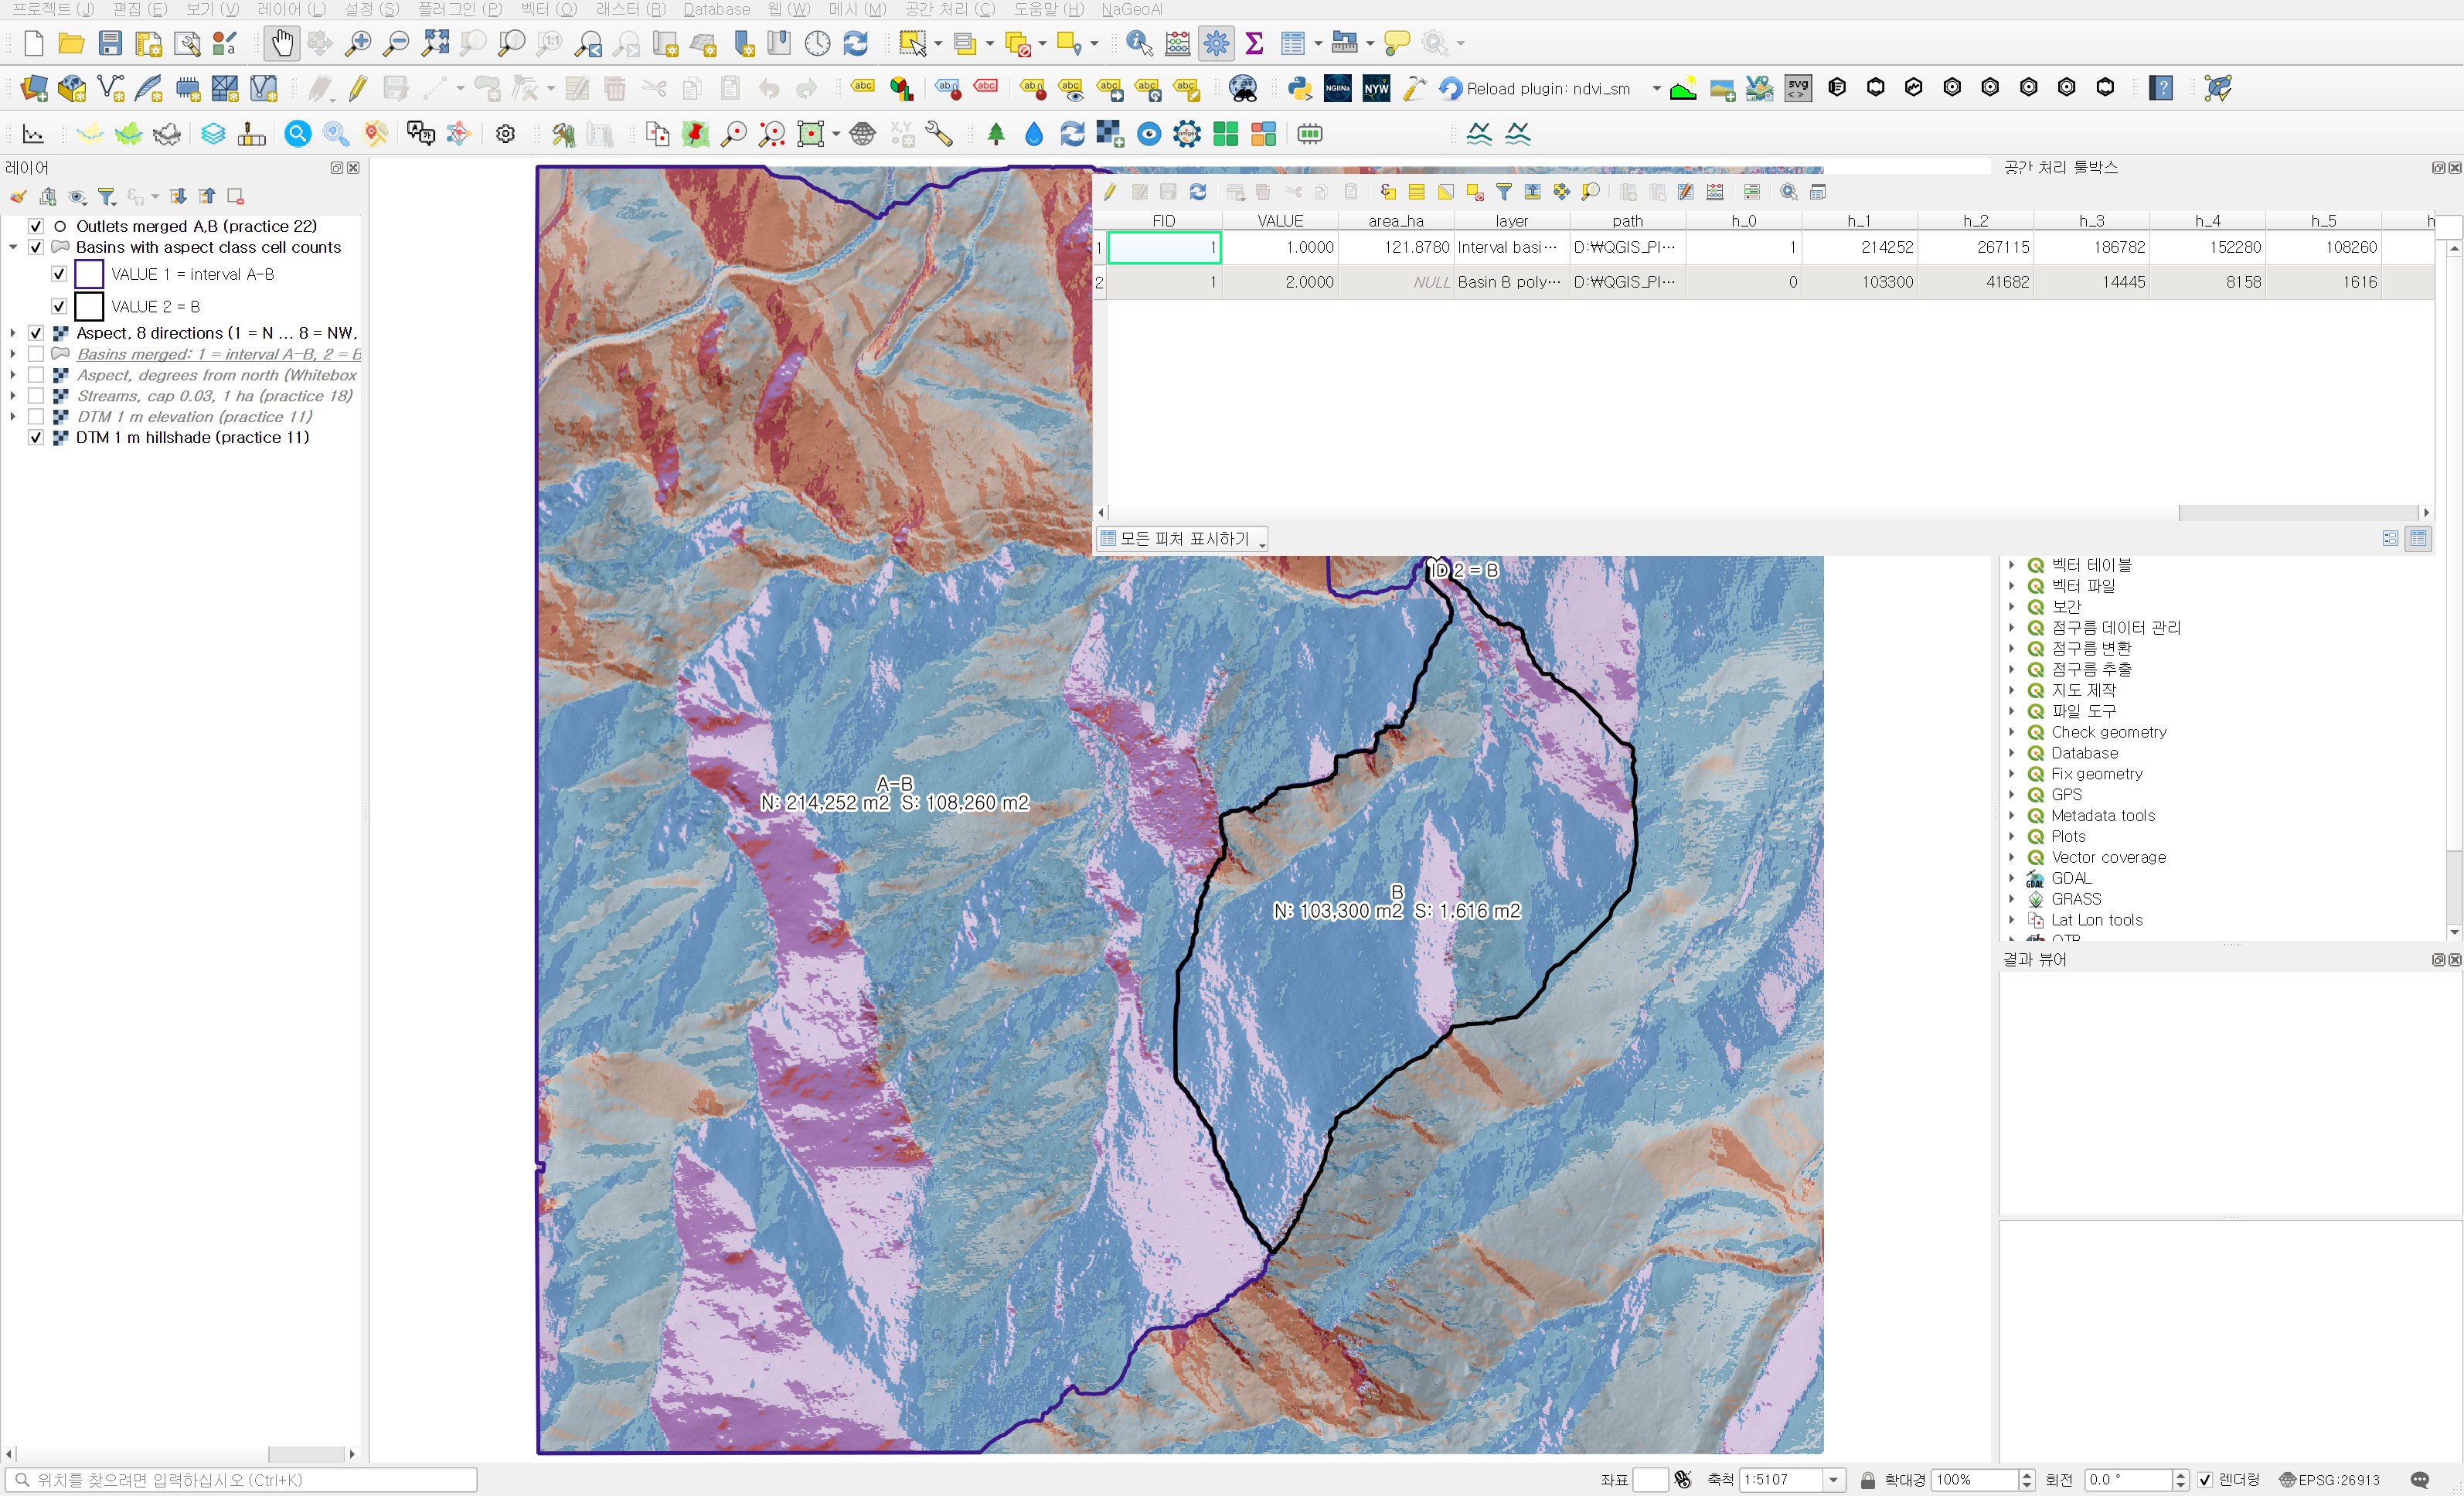
Basins with aspect class cell counts 속성 표와 지도. VALUE 1 행은 h_0 1, h_1 214252, h_2 267115, h_3 186782, h_4 152280, h_5 108260이고 VALUE 2 행은 h_0 0, h_1 103300, h_2 41682, h_3 14445, h_4 8158, h_5 1616이다. 지도에는 중간유역 안에 A-B N: 214,252 m2 S: 108,260 m2, B 유역 안에 B N: 103,300 m2 S: 1,616 m2 라벨이 있다.
그림 5. 구역히스토그램 속성 표(h_5까지 보임)와 북향·남향 면적 라벨. 나머지 필드는 아래 표에 옮겼다.
방위중간유역 A−B 면적(m²)비율B 유역 면적(m²)비율
N214,25217.58%103,30048.87%
NE267,11521.92%41,68219.72%
E186,78215.33%14,4456.83%
SE152,28012.49%8,1583.86%
S108,2608.88%1,6160.76%
SW59,6774.90%8700.41%
W89,6817.36%6,2462.96%
NW140,73211.55%35,05516.59%
평탄지(코드 0)10.00%00%
합계1,218,780100%211,372100%
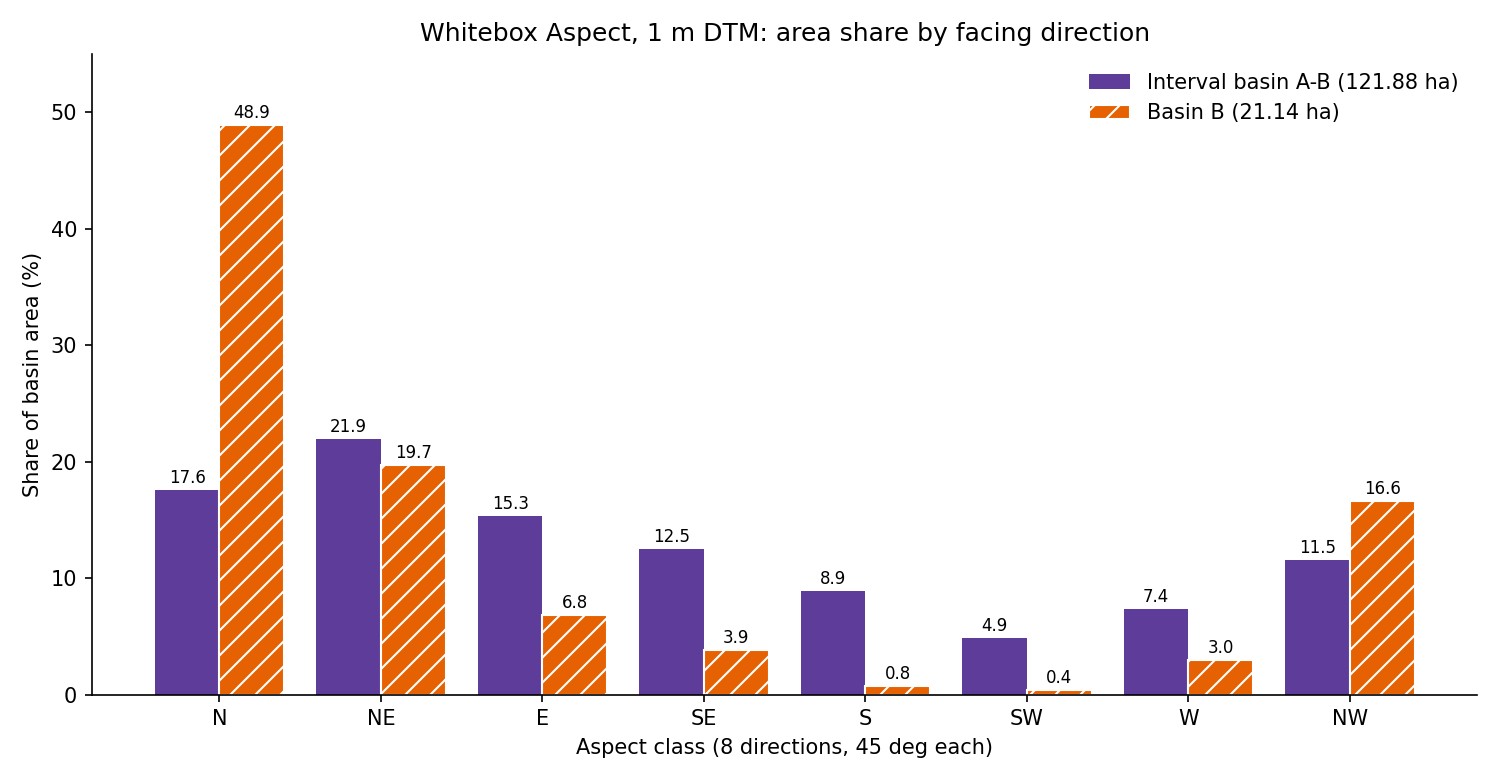
8방위별 유역 면적 비율 막대그래프. 가로축은 N, NE, E, SE, S, SW, W, NW, 세로축은 유역 면적 비율(%)이다. 빗금 친 주황 막대(B 유역)는 N에서 48.9%로 가장 높고 NE 19.7%, NW 16.6%이며 S와 SW는 1% 미만이다. 보라 막대(중간유역 A-B)는 NE 21.9%, N 17.6%, E 15.3%, SE 12.5%, NW 11.5%로 고르게 퍼져 있고 SW가 4.9%로 가장 낮다.
그림 6. 구역히스토그램 셀 수를 유역 면적 비율로 바꾼 막대그래프(QGIS 출력 표로 matplotlib에서 그림).

B 유역은 한쪽으로 쏠려 있다. 북·북동·북서 세 방위가 85.18%이고 남동·남·남서는 5.04%뿐이다. 남쪽이 높고 북쪽 유출구로 내려오는 좁은 골짜기라 대부분의 사면이 북쪽을 본다. 경사향을 단위 벡터로 평균 내면 8.2°(거의 정북)이고, 벡터 평균 길이(0이면 사방으로 고르게, 1이면 한 방향)는 0.726이다.

중간유역은 훨씬 고르다. 가장 많은 방위가 북동(21.92%)이지만 동·남동·북서도 각각 11~15%대다. 북쪽 세 방위가 51.04%, 남쪽 세 방위가 26.27%로 북향이 더 많기는 해도, 벡터 평균 길이는 0.294로 B의 절반이 안 된다. 평균 방향은 46.1°(북동)다. 큰 유역 안에 여러 갈래 골짜기가 있어 양쪽 사면이 서로 상쇄되기 때문으로 보인다.

28편에서 두 유역의 경사 중앙값은 30° 안팎으로 거의 같았다. 향까지 보면 두 유역은 성격이 꽤 다르다. B는 거의 북향 일색이라 같은 표고라도 그늘진 사면 비중이 높고, 중간유역은 여러 방향 사면이 섞여 있다. 일사, 적설, 식생 같은 주제로 유역을 비교할 때는 경사보다 이 차이가 더 크게 작용할 수 있다. 다만 여기서는 분포만 확인했고 일사량을 계산하지는 않았다.

독립 계산으로 확인

최종 결과를 별도 스크립트로 다시 계산했다. Whitebox 향값을 numpy로 같은 8방위 규칙에 넣으면 QGIS 재분류 결과와 다른 셀이 0개였다. 유역 폴리곤을 셀 중심 기준으로 래스터화해 센 방위별 셀 수도 두 유역 모든 방위에서 속성 표와 같았고, 합계는 26편 면적과 일치했다.

numpy Horn 3×3으로 따로 계산한 경사향과 비교하면 가장자리를 뺀 2,242,171개 셀에서 차이의 중앙값이 1.00°, 평균 1.80°, 99%가 13.65° 안이었다. 같은 8방위에 들어간 셀은 96.13%다. 차이가 큰 셀은 거의 평평해 방향이 불안정한 곳으로 보인다. 첫 실행에서 이 비교의 중앙값이 179.0°였으니, 이 대조 하나만 있어도 뒤집힌 결과는 바로 걸러진다.

실무에서 챙길 것

  • WhiteboxTools v2.2.0 Aspect에서는 Z Conversion Factor를 비워 둔다. 1.0을 넣으면 오류 없이 경사향이 180° 뒤집힌 래스터가 나온다. 다른 버전이나 1.0이 아닌 값은 이번에 확인하지 않았다.
  • 향 결과는 유출구 위치나 하천 방향처럼 이미 아는 지형과 한 번 대 본다. 골짜기 유출구 쪽으로 사면이 내려가는지만 봐도 뒤집힘은 알아챈다.
  • 북쪽은 0°/360°를 넘나든다. 재분류 표에서 두 행으로 나누지 않으면 북향이 반쪽만 잡힌다. 평균을 낼 때도 산술평균이 아니라 벡터 평균을 써야 한다(350°와 10°의 산술평균은 180°다).
  • 평탄지는 −1 같은 별도 값으로 나온다. 재분류 표에 음수 구간을 넣지 않으면 NoData로 사라지거나 북향에 섞일 수 있다.
  • Whitebox 경사향은 내려가는 방향 기준이다. 다른 도구와 섞어 쓸 때는 기준(북쪽 0°, 시계 방향)과 평탄지 표기를 먼저 맞춘다.

다음 회차

표고, 경사, 경사향을 봤으니 다음은 물이 모이는 정도다. Whitebox 지형습윤지수(Wetness Index, TWI)를 만들어 두 유역의 습윤 분포를 같은 방식으로 비교해 보려고 한다. 비집수면적(specific contributing area)과 경사를 어떤 도구로 만드느냐에 따라 값이 크게 달라지는 지수라, 입력 준비부터 차례로 보겠다.

작업 메모

이번 회차는 QGIS 시작 스크립트로 같은 대화상자에 값을 넣어 실행했고, 화면은 그때 캡처한 것이다. 원본 프로젝트는 그대로 두고 복사본(QGIS_Play_NaGeoAI_20261118_29_aspect8dir.qgz)에서 작업했다. Z 변환 계수 1.0으로 실행한 첫 결과는 이름에 try1_zfactor1을 붙여 따로 보관했고 그림 1, 2가 그때 화면이다. 원인 확인용 Whitebox 직접 실행과 가상 평면 시험은 QGIS 밖에서 별도로 했다. 자료 출처는 USGS 3DEP(The National Map) 타일 13SDE474426이고, 원본 DTM은 재배포하지 않는다. 그림 6과 비율, 벡터 평균, 독립 계산은 출력 파일을 다시 읽는 별도 스크립트로 만든 것이다. QGIS 3.44.15, WhiteboxTools v2.2.0(wbt_for_qgis 플러그인). SHA-256 앞 12자리:

  • 입력 DTM 069a9c249240
  • 입력 병합 폴리곤 .shp / .dbf 235891ed214a / 67d3965a6d72
  • 경사향 래스터 90bbd5f3c503
  • 8방위 래스터 5bd9eb5e5aad
  • 구역히스토그램 .shp / .dbf 235891ed214a / 9173dd77e473

2026-11-17

Whitebox 실제 QGIS 실습 28 — 두 유역의 경사 분포를 5° 구간으로 비교

27편에서 두 유역의 표고-면적 분포를 50 m 구간으로 나눠 봤다. 중간유역(A−B)은 1,850 m부터 2,150 m까지 면적이 고르게 깔려 있었고, B 유역은 1,850~2,000 m에 몸통이 몰려 있었다. 표고 분포가 이만큼 다르면 경사도 다를 거라고 짐작하기 쉽다. 그런데 표고 폭이 넓다고 비탈이 급한 건 아니다. 넓고 완만한 사면이 길게 이어져도 표고 폭은 커진다. 그래서 이번에는 DTM에서 경사 래스터를 만들고, 27편과 같은 방식(구간 재분류 + 구역히스토그램)으로 두 유역의 경사 분포를 비교했다.

경사 계산은 Whitebox Slope, 나머지는 QGIS 기본 알고리즘인 테이블로 재분류(Reclassify by table)와 구역히스토그램(Zonal histogram)이다. 1 m DTM이라 셀 하나가 1 m²이니 셀 수가 곧 면적이다.

자료

27편과 같은 입력을 새 폴더로 복사해 썼다. 복사본 해시는 원본과 같다.

입력원래 출처내용
wb28_input_dtm1m.tif11편 DTMUSGS 3DEP 타일 13SDE474426, NAD83 UTM 13N EPSG:26913, 1500×1500 셀, 1 m, NoData 1,834개 셀
wb28_input_basins_merged.shp26편 병합 폴리곤VALUE 1 = 중간유역 1,218,780 m², VALUE 2 = B 유역 211,372 m²

Whitebox Slope로 경사 래스터 만들기

공간 처리 툴박스 → WhiteboxTools → Geomorphometric Analysis → Slope를 열었다. 입력은 네 셀뿐이다.

입력란값이유
Input DEM FileDTM 1 m elevation (practice 11)지면점으로 만든 DTM. 건물·수목 높이가 섞인 DSM이면 경사가 엉뚱하게 커진다
Z Conversion Factor1.0수평(UTM, m)과 표고(m) 단위가 같다
Unitsdegrees5° 구간으로 나눌 거라 도 단위가 읽기 쉽다
Output Filewb28_slope_deg.tif
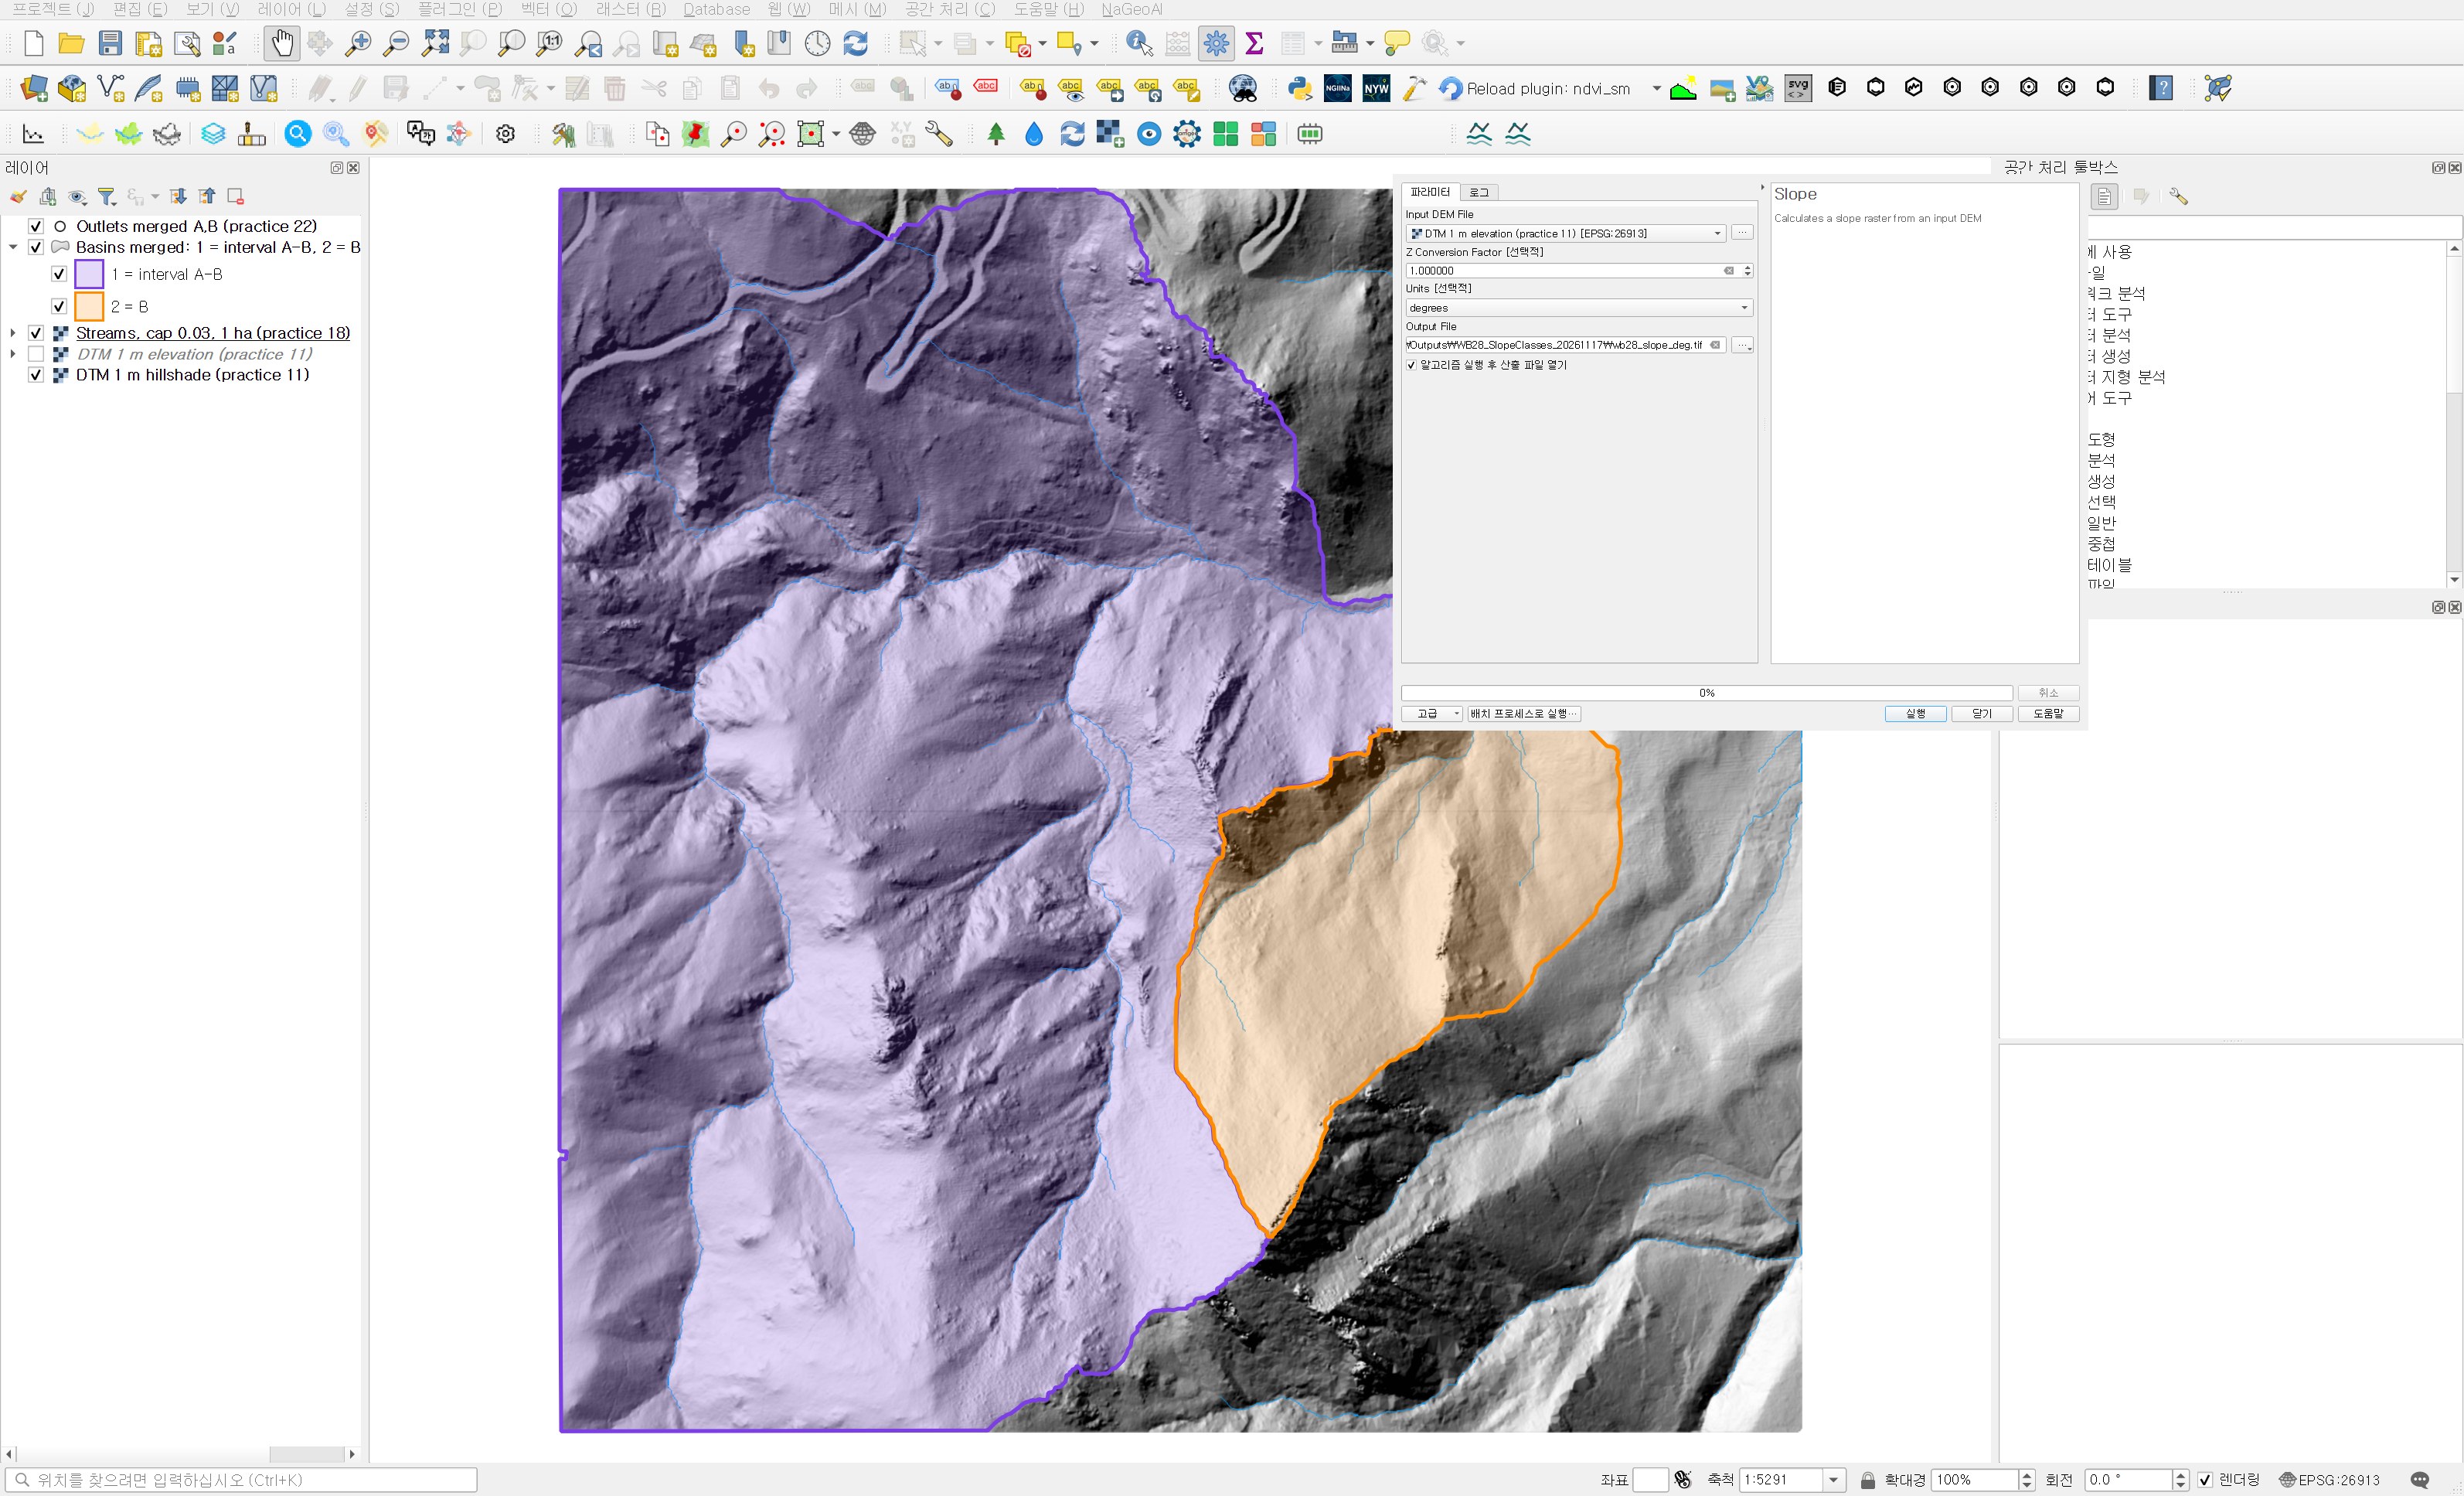
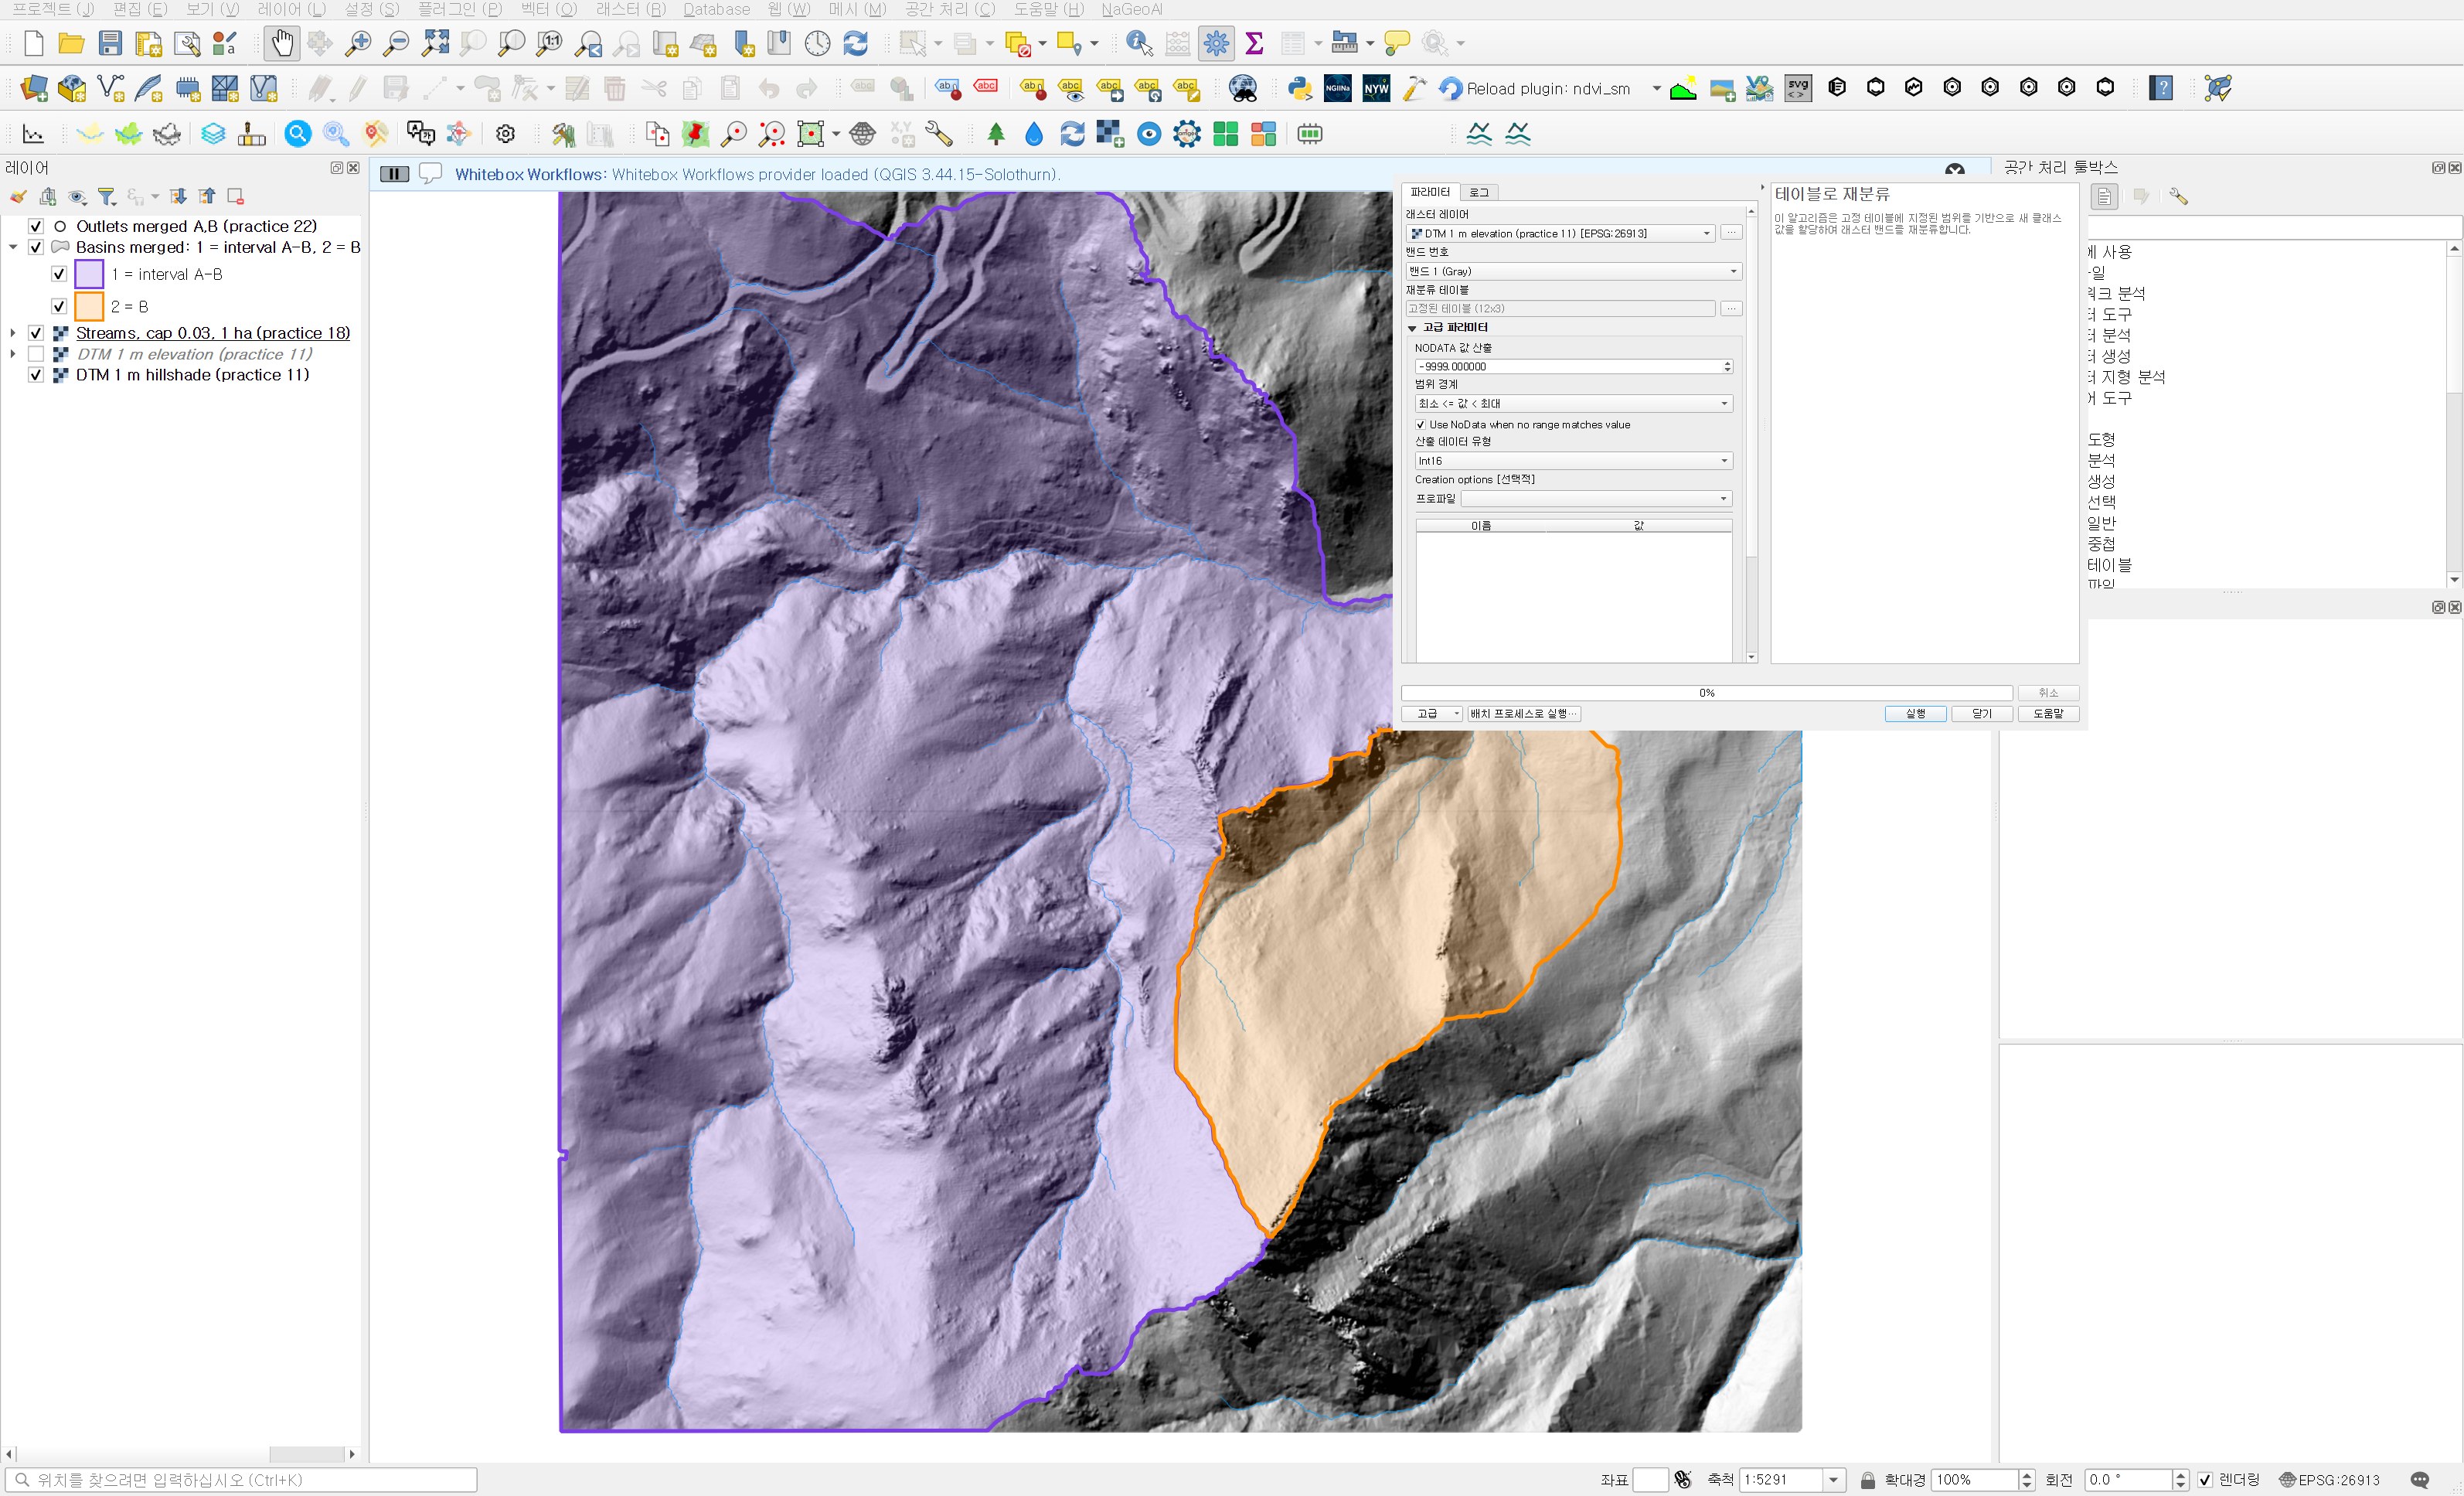
QGIS Whitebox Slope 대화상자. Input DEM File DTM 1 m elevation (practice 11), Z Conversion Factor 1.000000, Units degrees, Output File wb28_slope_deg.tif가 입력되어 있다. 뒤 지도에는 음영기복도 위에 보라색 중간유역과 주황색 B 유역이 반투명하게 칠해져 있다.
그림 1. Whitebox Slope 대화상자. DTM을 넣고 단위를 도(degrees)로 골랐다.

Z 변환 계수는 지리좌표계(위경도) DEM을 그대로 넣을 때 문제가 된다. 수평 단위가 도인데 표고는 미터라 경사가 거의 0으로 나온다. 이번 DTM은 투영좌표계라 1.0이면 된다. 실행은 1초 안에 끝났다. 출력은 float32, NoData 셀 1,834개로 DTM의 NoData 셀 수와 같다. 경사 범위는 0.02°~88.65°, 전체 중앙값은 28.31°, 99% 분위는 60.90°다.

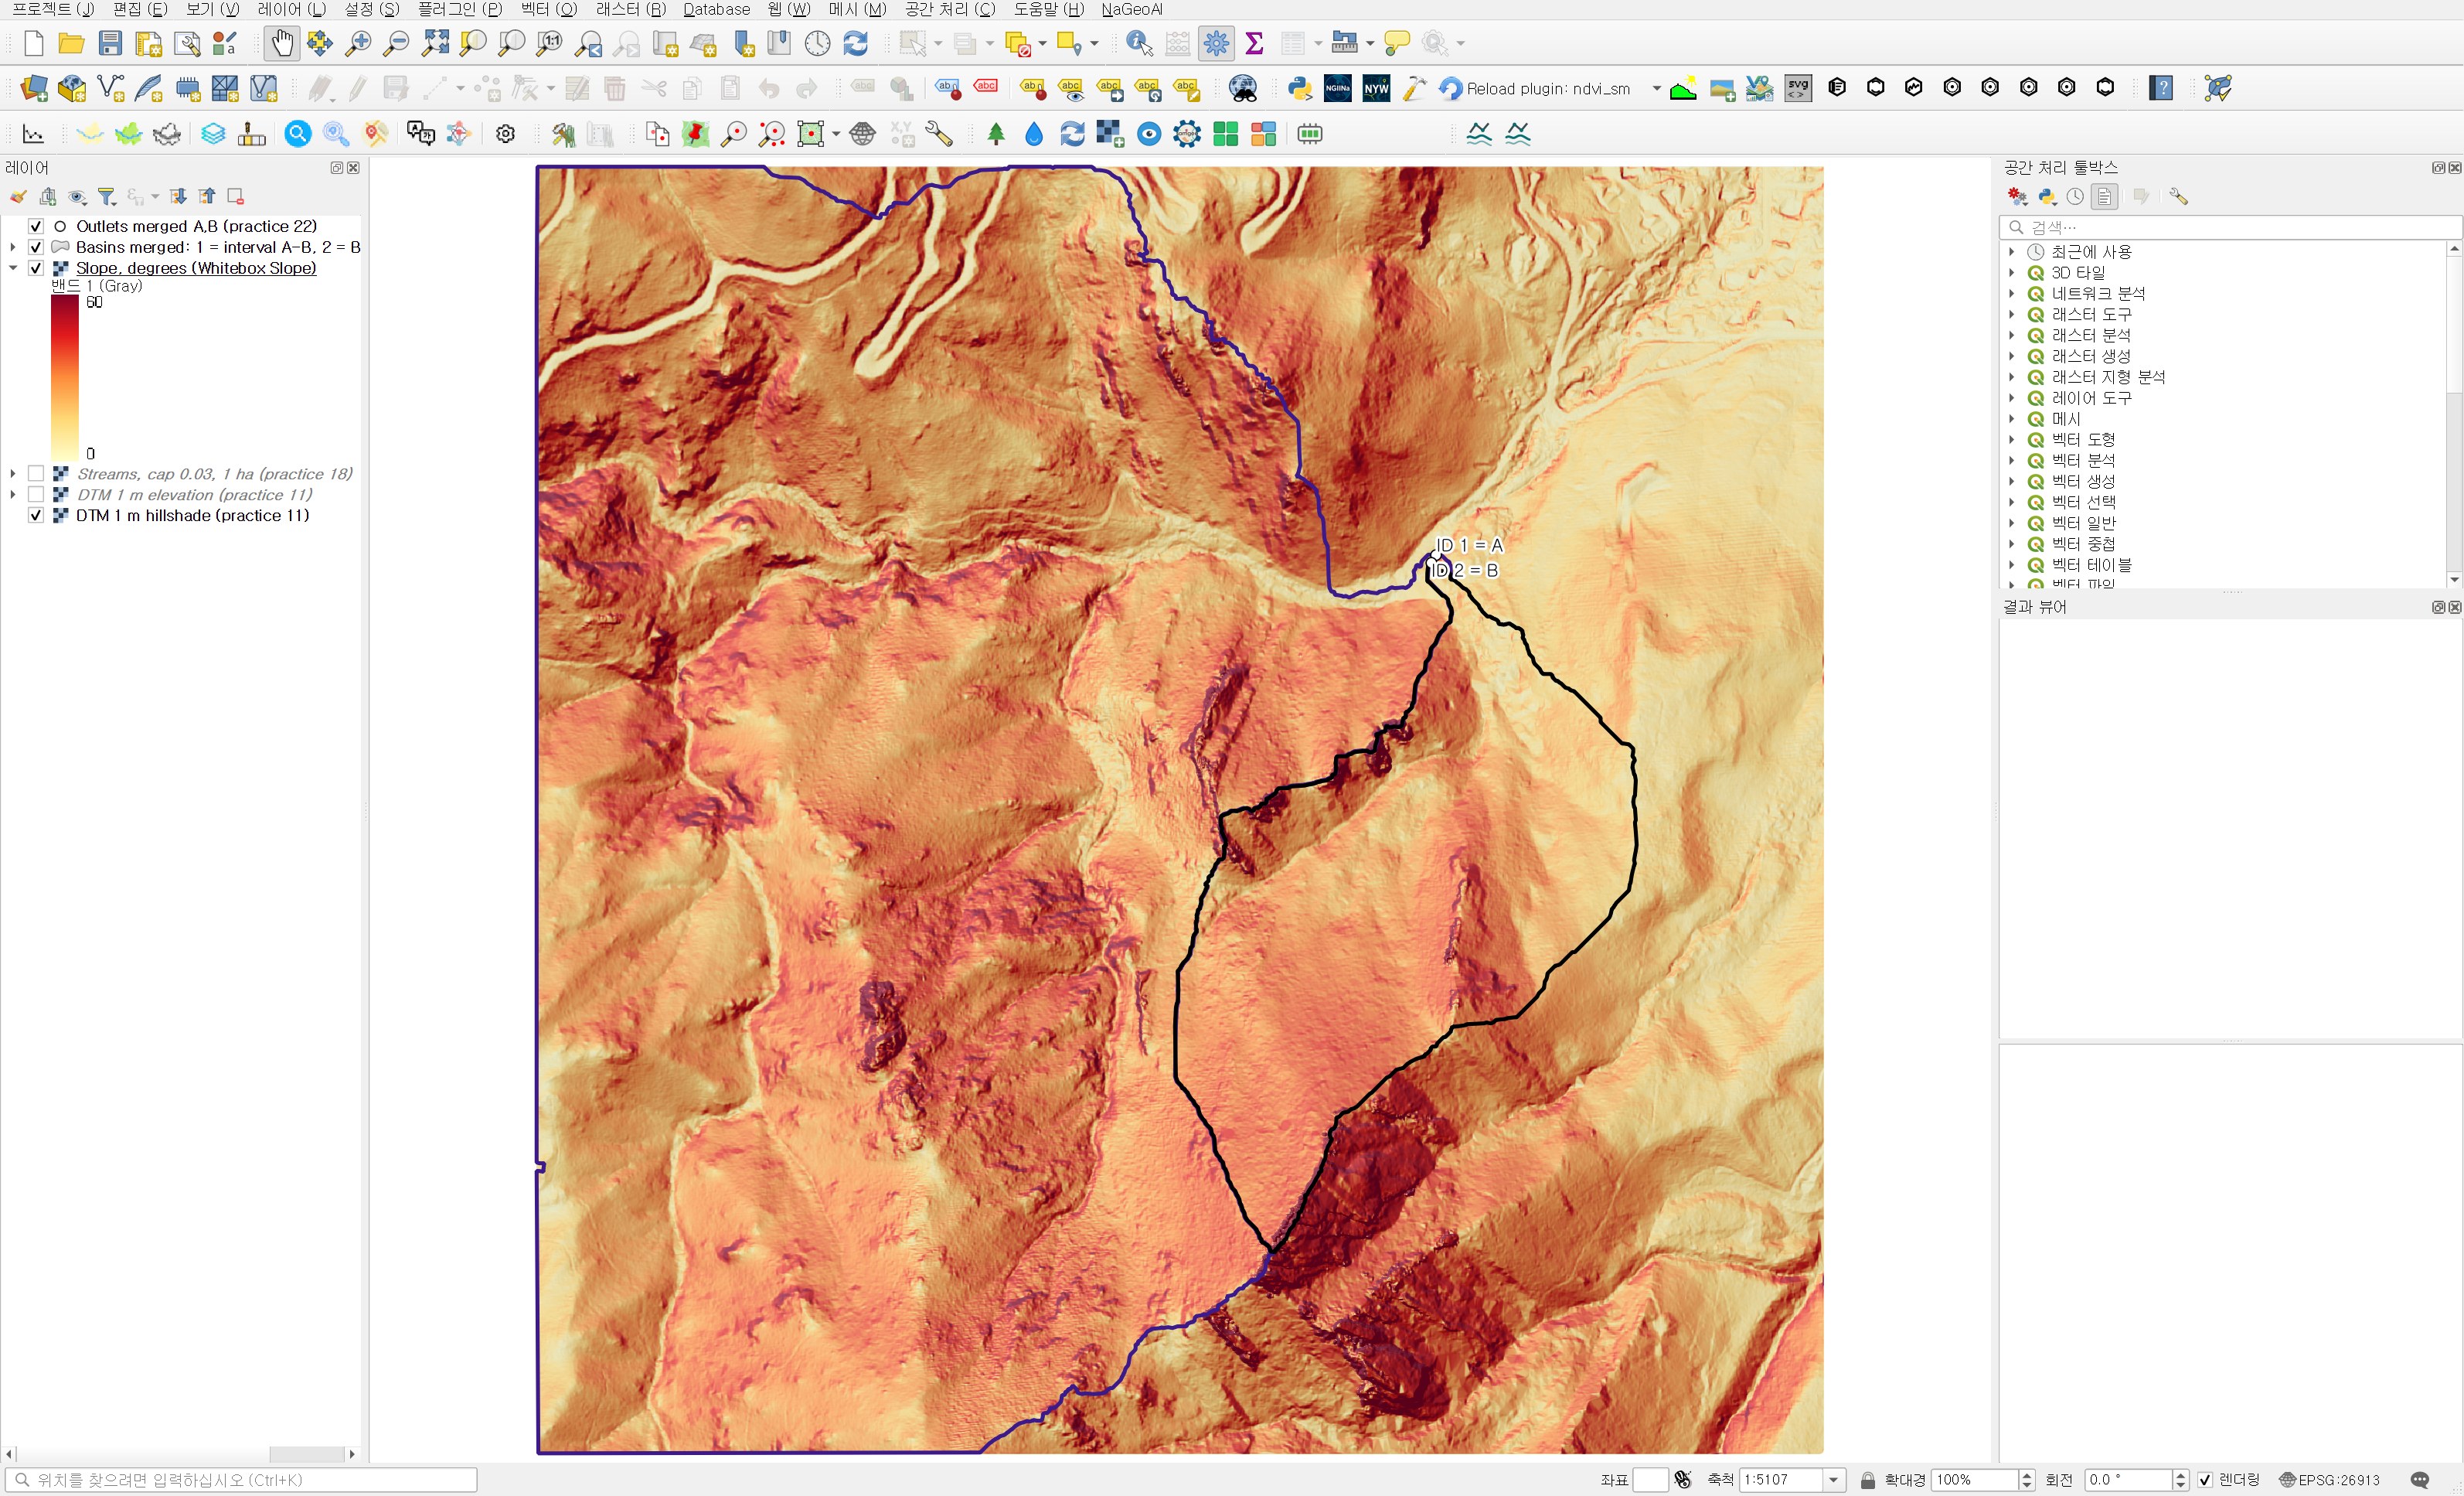
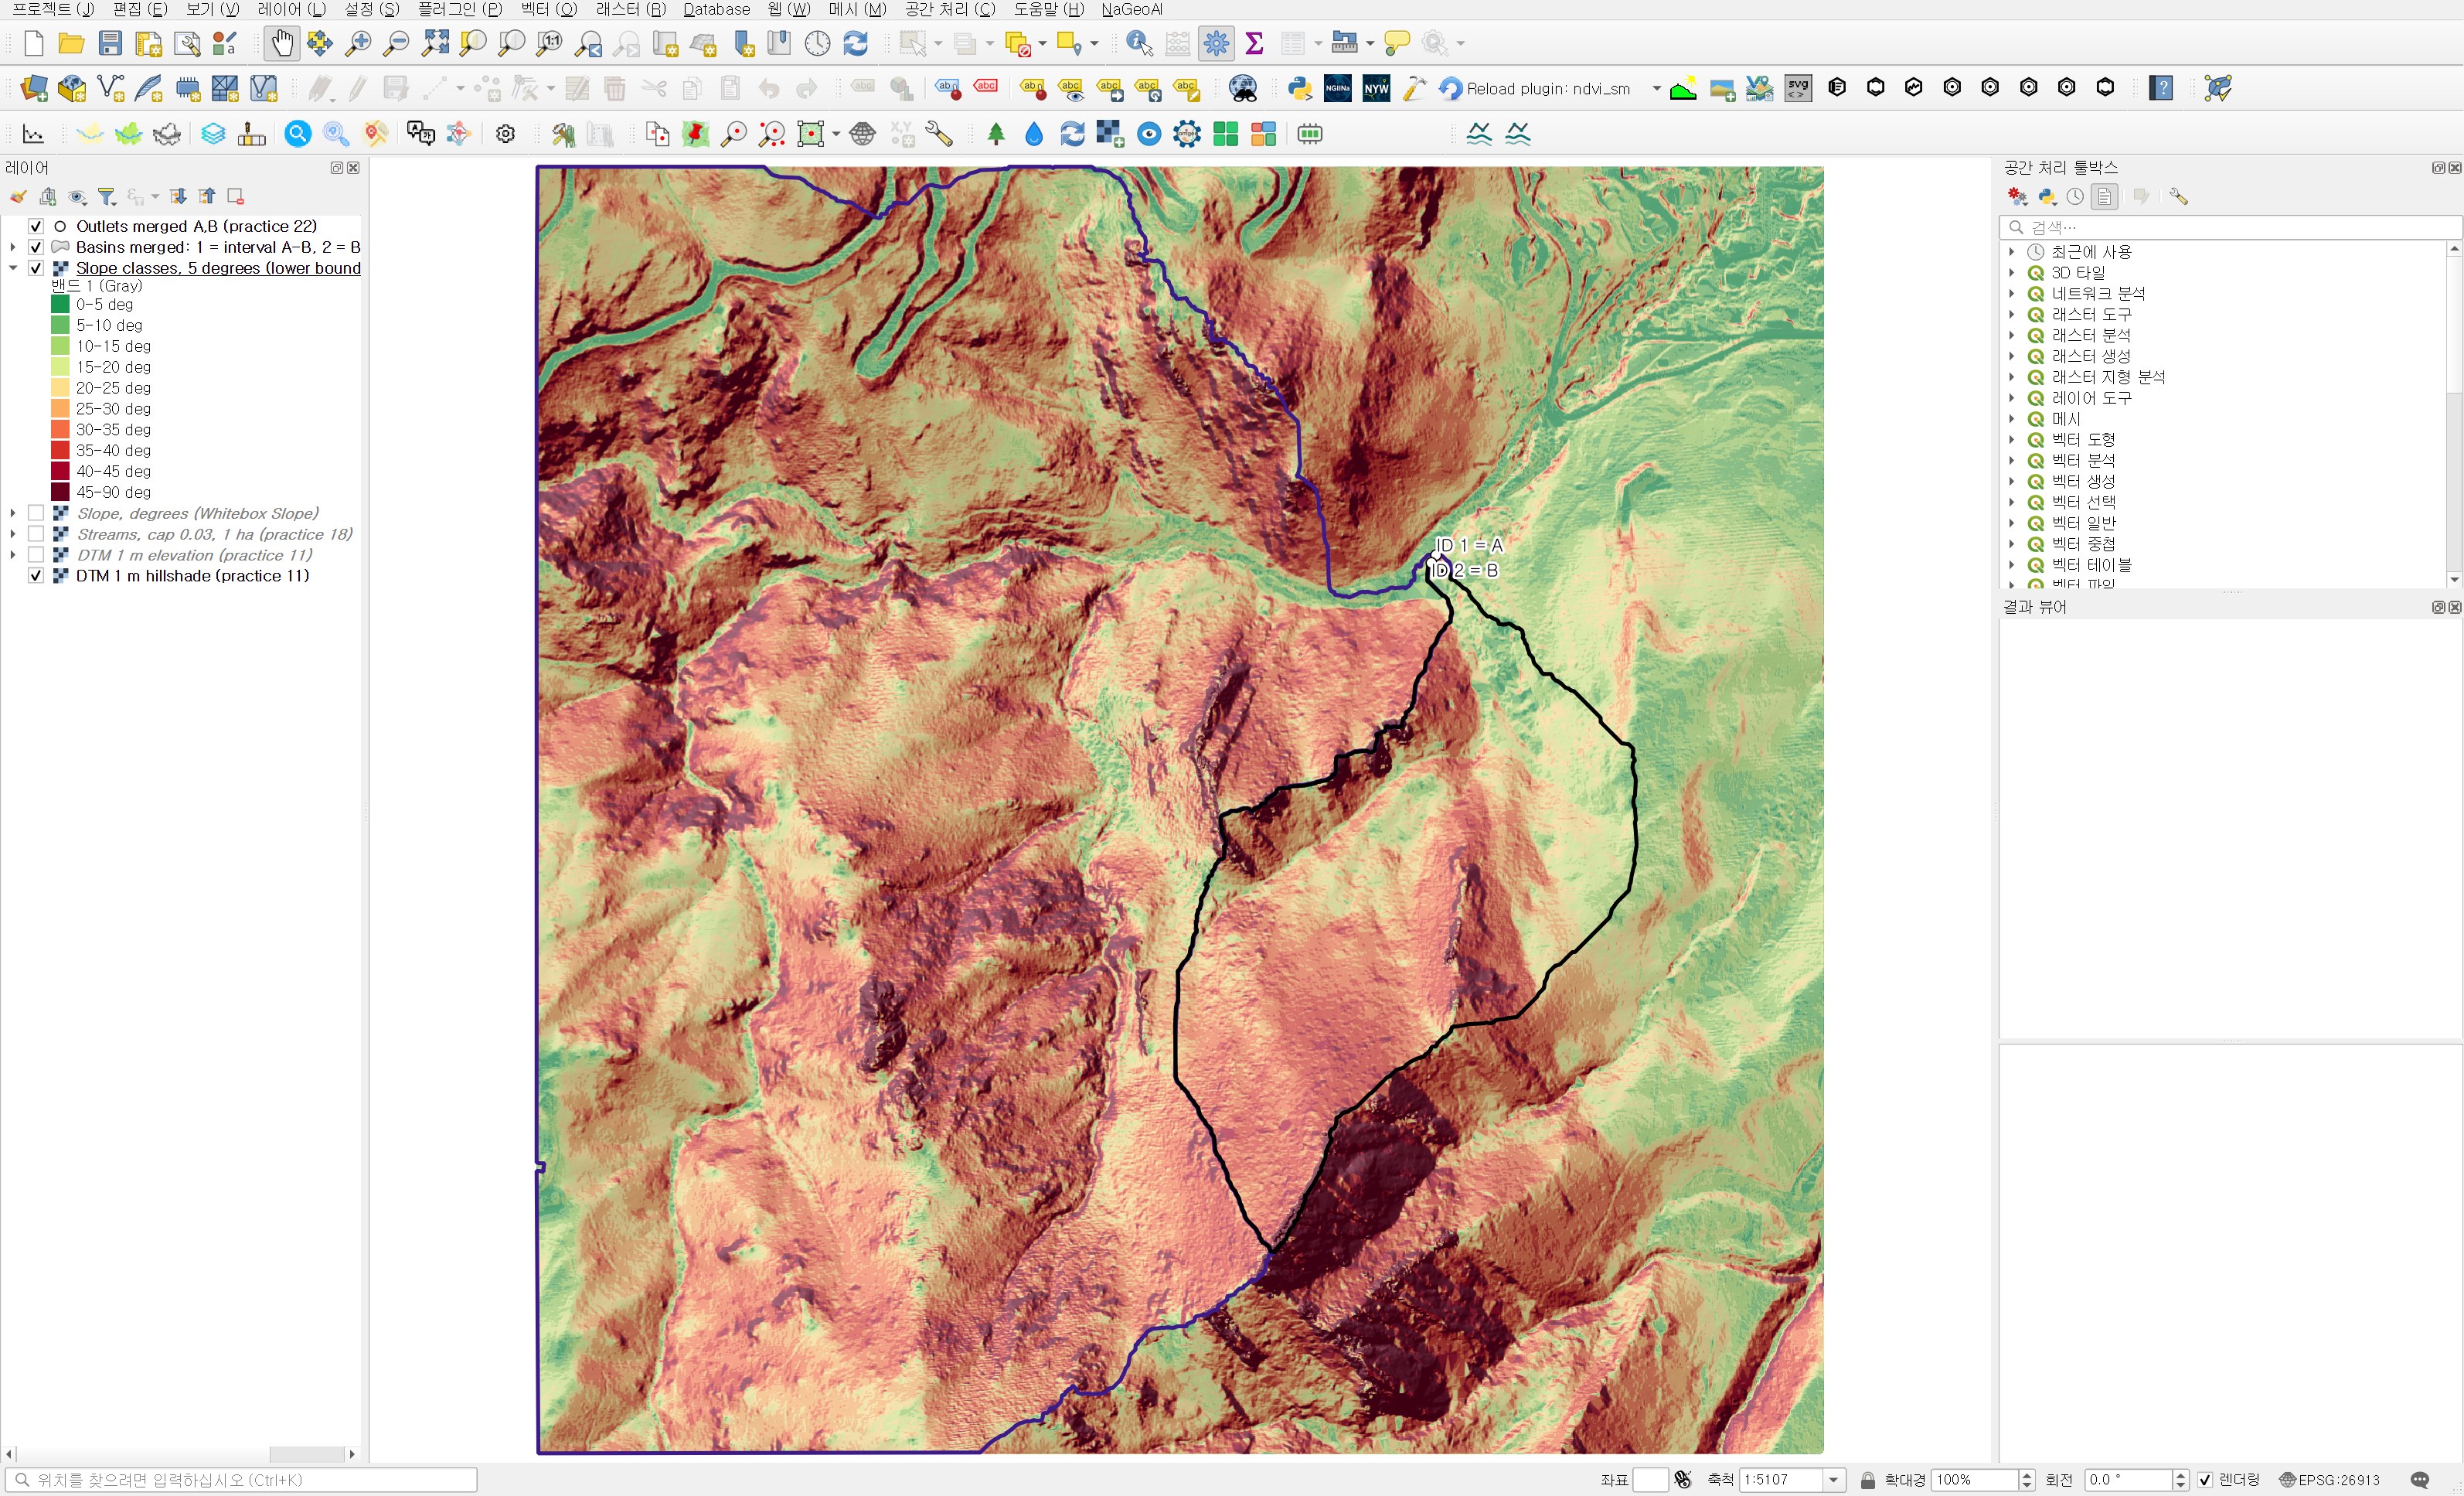
음영기복도 위에 경사 래스터를 노랑에서 진한 빨강으로 칠한 지도. 북동쪽 골짜기 바닥과 오른쪽 사면은 밝은 노랑, 남쪽과 가운데 능선 사면은 진한 빨강이다. 검은 선이 B 유역 경계, 보라색 선이 하천이고 오른쪽 위 유출구 근처에 ID 1 = A, ID 2 = B 라벨이 있다.
그림 2. Whitebox Slope 경사 래스터(도). 밝을수록 완만하고 진할수록 급하다.

지도로 보면 골짜기 바닥과 오른쪽 넓은 사면이 밝고, B 유역 남쪽 끝 능선 사면이 가장 진하다. 진한 띠가 군데군데 끊겨 보이는 곳은 암벽이나 계단 모양 지형으로 보인다. 연속 색으로는 "어디가 급한지"는 보여도 "얼마나 되는지"는 읽히지 않는다. 그래서 구간으로 나눈다.

경사를 5° 구간 코드로 재분류

0°부터 45°까지 5°씩 9구간, 45° 이상은 한 구간으로 묶어 모두 10구간을 만들었다. 45° 이상은 전체의 6%대라 5°씩 쪼개면 막대가 너무 낮아 비교가 안 된다. 구간 코드는 27편처럼 아래 경곗값(0, 5, …, 45)을 그대로 넣었다. 히스토그램 필드 이름이 h_30처럼 각도가 되어 표를 바로 읽을 수 있다.

입력란값이유
래스터 레이어Slope, degrees (Whitebox Slope)방금 만든 경사
밴드 번호밴드 1
재분류 테이블10행 × 3열: 최소 0 / 최대 5 / 값 0, … , 최소 40 / 최대 45 / 값 40, 최소 45 / 최대 90 / 값 455° 간격, 마지막만 45~90°
NODATA 값 산출−9999정수형 출력에 맞춘 NoData
범위 경계최소 <= 값 < 최대정확히 30.0°인 셀을 30~35° 구간에 넣기 위해
Use NoData when no range matches value체크표 밖의 값이 원래 값으로 남지 않도록
산출 데이터 유형Int16
재분류된 래스터wb28_slope_classes5deg.tif
음영기복도 위에 5도 경사 구간 래스터를 반투명하게 얹은 지도. 왼쪽 범례는 0-5 deg 진한 초록부터 45-90 deg 진한 적갈색까지 10단계다. 골짜기 바닥과 오른쪽 사면은 초록과 연두, 능선 사면은 주황과 적갈색이다. 검은 선이 B 유역 경계다.
그림 3. 5° 경사 구간 래스터. 0~5°(초록)부터 45~90°(적갈색)까지 10단계다.

전체 DTM에서 가장 넓은 구간은 30~35°(443,952개 셀), 그다음이 25~30°(416,238개 셀)다. 이 지역은 원래 30° 안팎 사면이 주를 이루는 산지다.

구역히스토그램으로 유역별 셀 수 세기

입력란값이유
래스터 레이어Slope classes, 5 degrees (lower bound)구간 코드
밴드 번호밴드 1
구역을 담고 있는 벡터 레이어Basins merged: 1 = interval A-B, 2 = B (practice 26)두 유역이 한 표로 나온다
산출 열 접두어h_h_0부터 h_45까지 shp 10자 제한 안에 든다
산출 구역wb28_basin_slope_histogram.shp
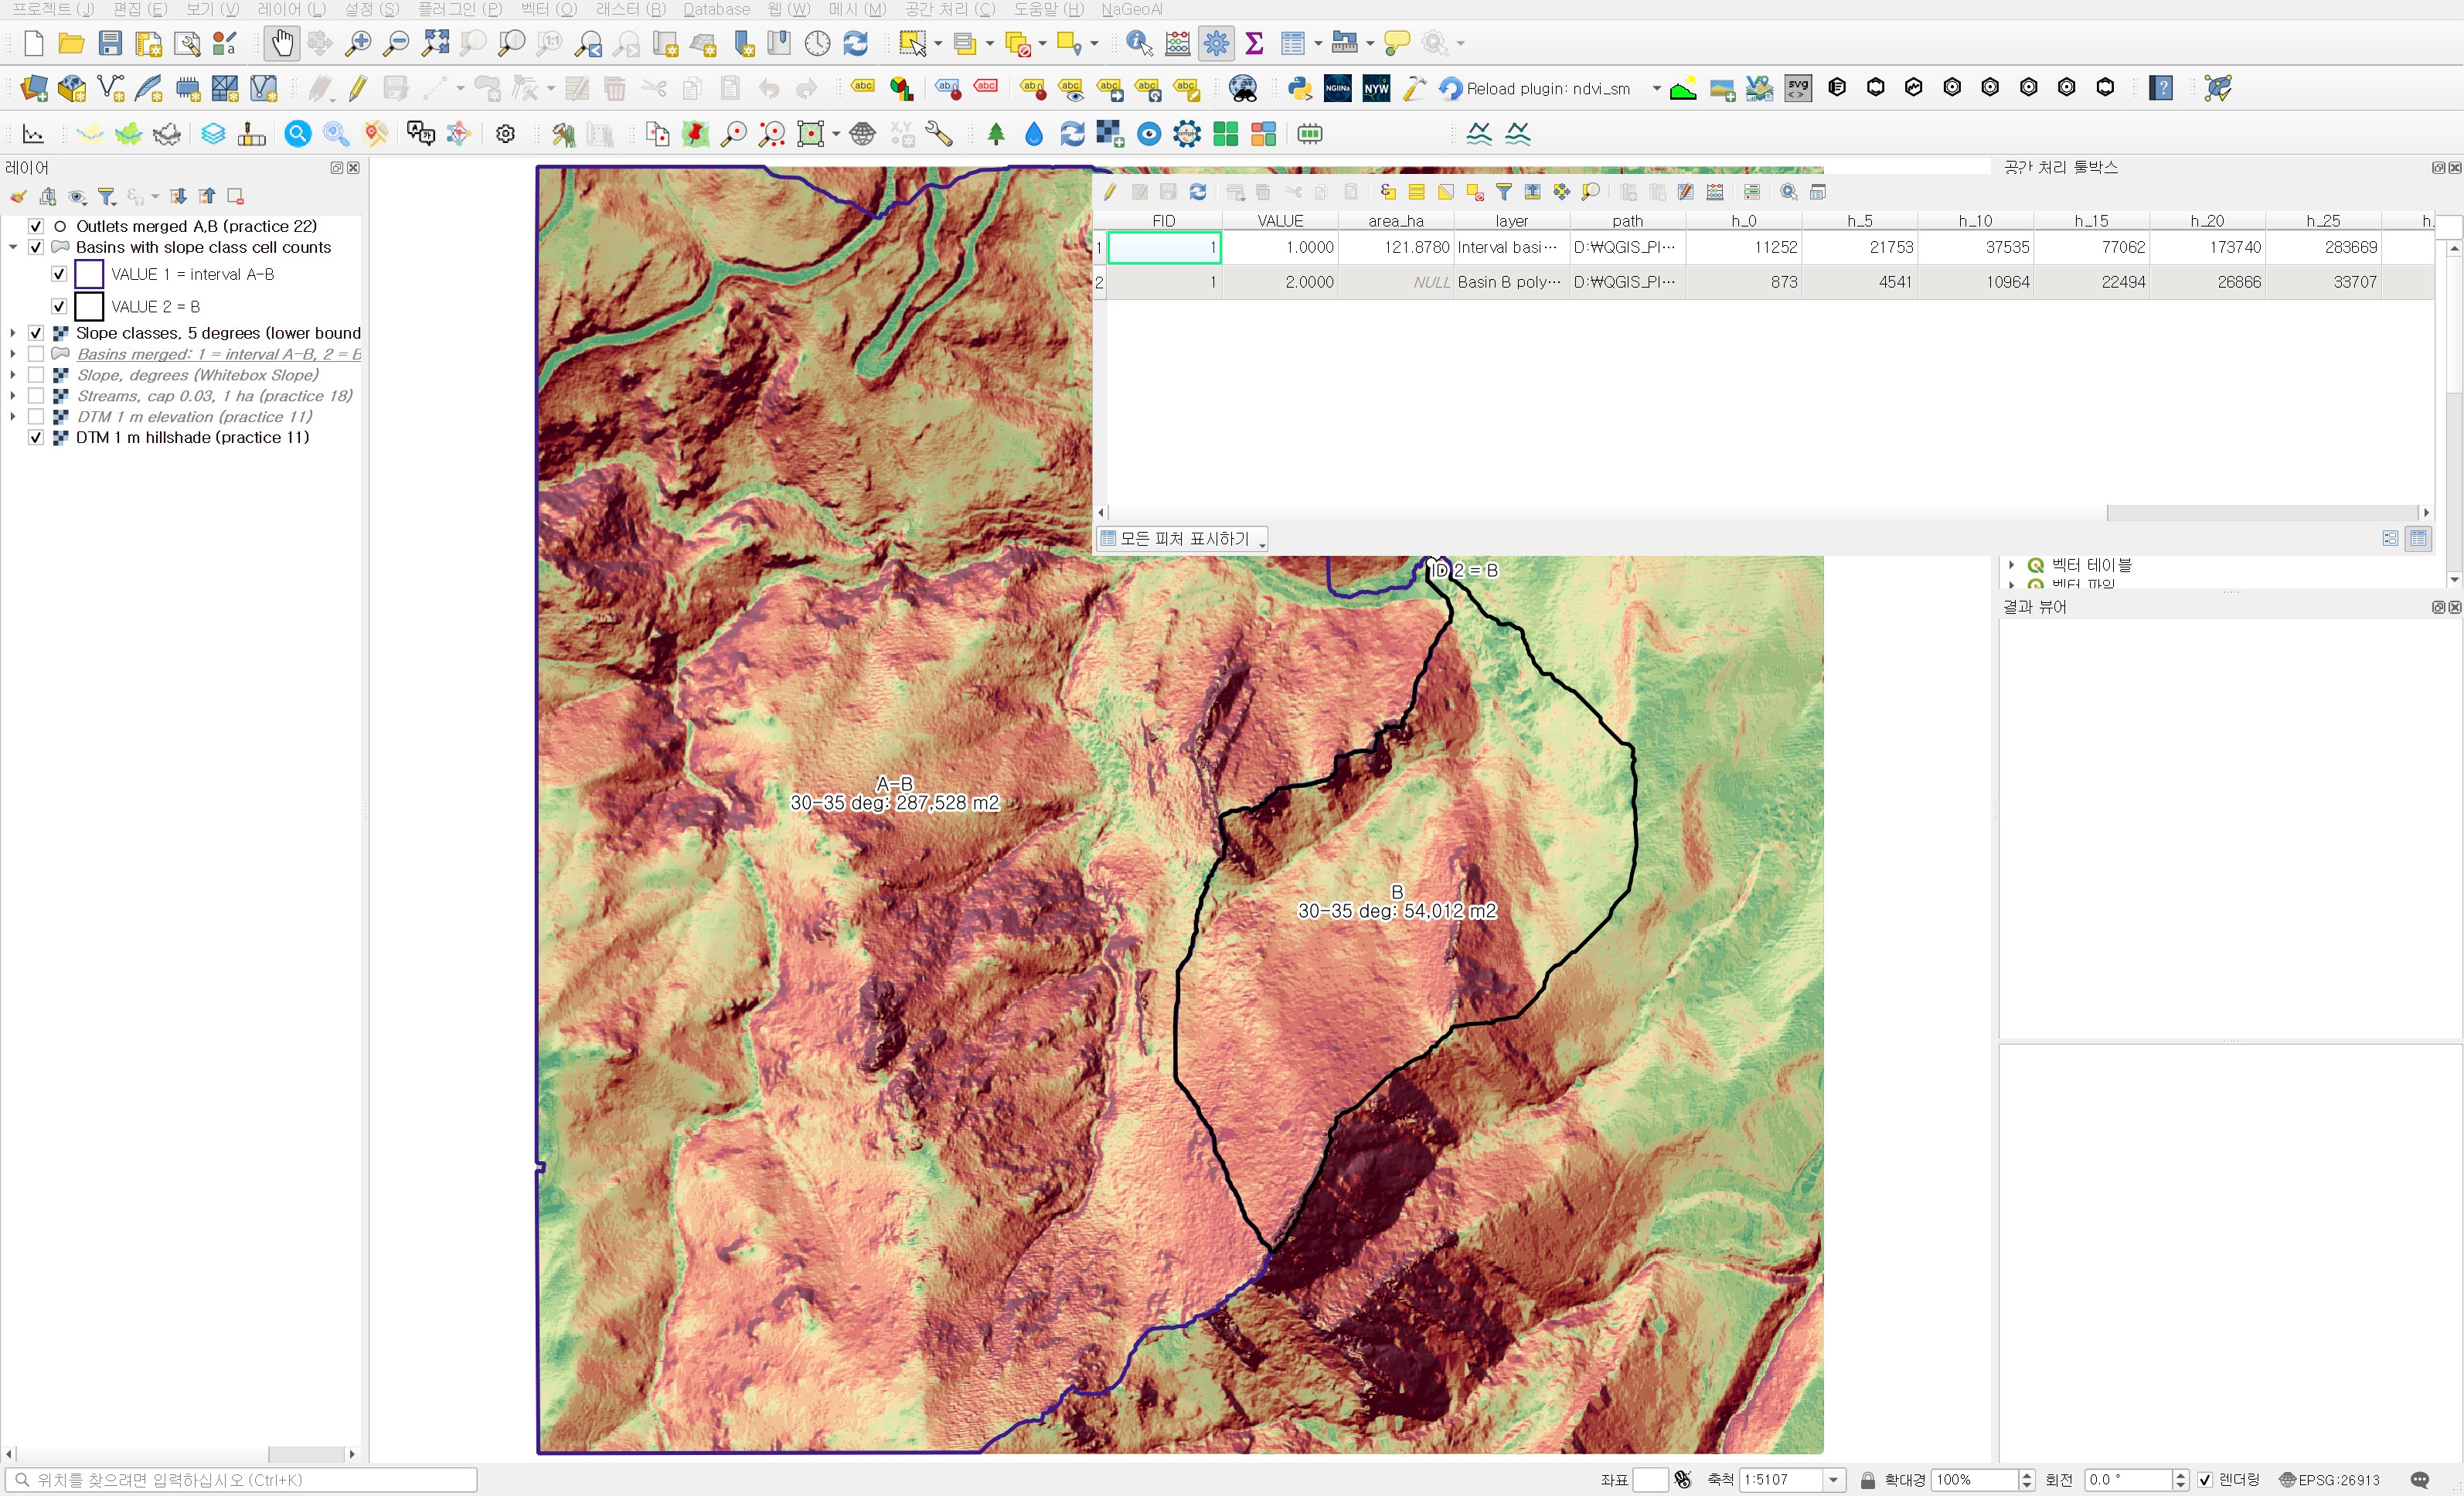
Basins with slope class cell counts 속성 표와 지도. VALUE 1 행은 h_0 11252, h_5 21753, h_10 37535, h_15 77062, h_20 173740, h_25 283669이고 VALUE 2 행은 873, 4541, 10964, 22494, 26866, 33707이다. 오른쪽 필드는 표 폭 밖에 있다. 지도에는 중간유역 안에 A-B 30-35 deg: 287,528 m2, B 유역 안에 B 30-35 deg: 54,012 m2 라벨이 있다.
그림 4. 구역히스토그램 속성 표(h_25까지 보임)와 30~35° 구간 면적 라벨. 나머지 필드는 아래 표에 옮겼다.

실행은 1초가 걸리지 않았다. 두 유역 모두 10개 구간이 다 나왔다. 0~5° 같은 평탄지 구간도 골짜기 바닥에 조금씩 있다.

구간별 면적과 비율

경사 구간중간유역 A−B 면적(m²)비율B 유역 면적(m²)비율
0~5°11,2520.92%8730.41%
5~10°21,7531.78%4,5412.15%
10~15°37,5353.08%10,9645.19%
15~20°77,0626.32%22,49410.64%
20~25°173,74014.26%26,86612.71%
25~30°283,66923.28%33,70715.95%
30~35°287,52823.59%54,01225.55%
35~40°171,73114.09%40,17619.01%
40~45°73,6496.04%8,8294.18%
45~90°80,8616.63%8,9104.22%
합계1,218,780100%211,372100%
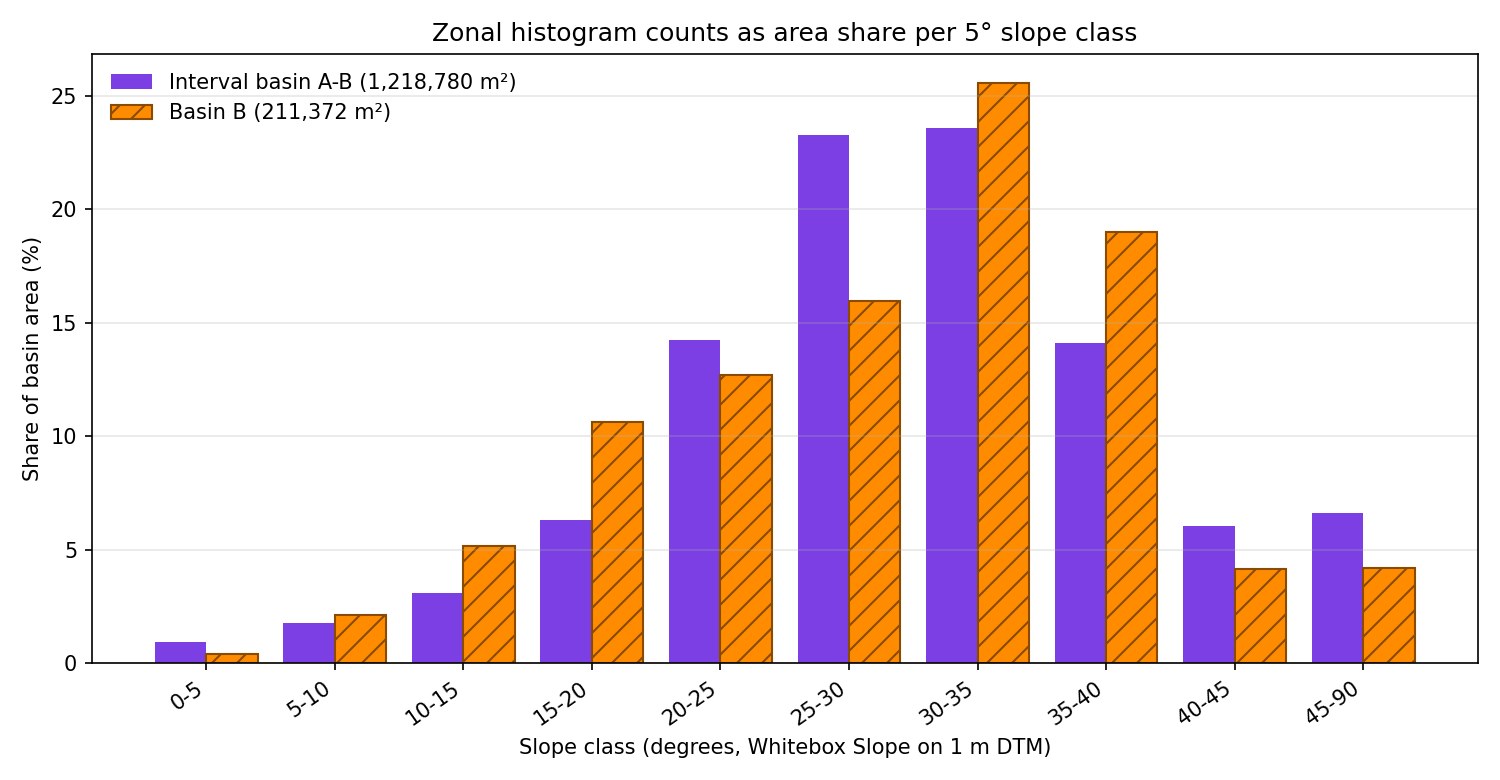
5도 경사 구간별 유역 면적 비율 막대그래프. 가로축은 0-5부터 45-90까지 10개 구간, 세로축은 유역 면적 비율(%)이다. 보라색 막대(중간유역 A-B)는 25-30과 30-35에서 각각 약 23%로 높고 양쪽으로 줄어든다. 빗금 친 주황색 막대(B 유역)는 30-35에서 25.6%로 가장 높고 35-40에서 19.0%, 25-30에서 15.9%이며, 15-20에서 10.6%로 보라색보다 높다. 40-45와 45-90에서는 보라색이 더 높다.
그림 5. 구역히스토그램 셀 수를 유역 면적 비율로 바꾼 막대그래프(QGIS 출력 표로 matplotlib에서 그림). 45~90° 막대는 폭이 45°인 구간이다.

먼저 대푯값은 거의 같다. 경사 중앙값이 중간유역 30.07°, B 30.71°이고, 가장 넓은 구간도 둘 다 30~35°다. 30° 이상 면적 비율도 50.36% 대 52.95%로 큰 차이가 없다. 27편에서 표고 분포가 그렇게 달랐던 걸 생각하면 오히려 놀라운 결과다. 표고 폭이 넓은 중간유역이 더 급할 거라는 짐작은 틀렸다.

차이는 분포의 모양에 있다. 중간유역은 20~35° 세 구간에 61.12%가 모여 있어 가운데가 두툼하다. 대신 40° 이상 꼬리가 12.68%로 B(8.39%)보다 길다. B는 반대로 양쪽이 넓다. 20° 미만 완만한 땅이 18.39%(중간유역 12.11%)이고, 30~40° 급사면도 44.56%(중간유역 37.68%)다. 완만한 골짜기 바닥과 30°대 사면이 섞이고, 그 사이 20°대가 비교적 적다. 평균 29.56°가 중앙값보다 낮은 것도 완만한 쪽 비중 때문이다.

실무에서는 이 차이를 구간을 어떻게 끊느냐에 따라 다르게 읽게 된다. 30°를 기준으로 "급경사 비율"을 내면 두 유역이 거의 같다. 40°로 올리면 중간유역이 1.5배쯤 많다. 산사태나 낙석 검토에서 어떤 경사 기준을 쓰느냐에 따라 순위가 바뀔 수 있다는 얘기다. 기준값은 자료가 아니라 검토 목적(지침, 지반 조건)에서 정해야 하고, 여기서는 분포만 확인했다.

독립 계산으로 확인

별도 스크립트로 두 가지를 다시 계산했다. 첫째, Whitebox 경사값을 numpy로 같은 표(아래 경계 포함)에 넣어 구간 코드를 만들었더니 QGIS 재분류 결과와 225만 셀 전체에서 다른 셀이 0개였다. 폴리곤을 셀 중심 기준으로 래스터화해 센 구간별 셀 수도 두 유역 모든 구간에서 속성 표와 같았고, 합계는 26편 면적과 일치했다.

둘째, 경사값 자체도 numpy Horn 3×3 방식으로 따로 계산해 비교했다. 가장자리를 뺀 2,242,172개 셀에서 차이의 평균은 0.56°, 99%가 3.05° 안이었다. 같은 5° 구간에 들어간 셀은 89.93%였다. 대부분 비슷하지만 1 m 격자의 급한 지형에서는 셀별로 몇 도씩 갈리는 곳이 있다. Whitebox Slope의 계산 방식이 Horn 3×3과 완전히 같지는 않은 것으로 보인다. 그러니 여러 회차나 여러 지역을 비교할 거라면 경사 도구를 하나로 정해 두는 편이 안전하다.

실무에서 챙길 것

  • 경사는 DTM으로 계산한다. DSM에서는 건물 벽과 수관 가장자리가 지형과 상관없는 급경사로 잡힌다.
  • 지리좌표계 DEM이면 투영한 뒤 계산하거나 Z 변환 계수를 맞춘다. 그대로 두면 경사가 0° 근처로 눌린다.
  • 마지막 구간을 넓게 묶었다면(45~90°) 그래프에서 막대 높이를 다른 구간과 같은 눈으로 읽지 않도록 캡션에 적어 둔다.
  • 도구마다 경사 계산 방식이 조금씩 달라 같은 DTM에서도 구간 경계 근처 셀이 다른 구간으로 갈 수 있다. 비교 작업에서는 도구와 버전을 고정한다.
  • Whitebox 도구가 툴박스에서 사라지고 "이전에 QGIS를 충돌시켜 플러그인을 비활성화했다"는 노란 막대가 보이면, QGIS가 시작할 때 wbt_for_qgis를 꺼 둔 것이다. 이번 실행에서도 이 막대가 떠서 해당 세션에서만 플러그인을 불러 썼다. 플러그인 관리자에서 다시 켜기 전에 충돌 원인부터 확인하는 게 순서다.

다음 회차

표고와 경사를 봤으니 다음은 경사향(향)이다. Whitebox Aspect로 향 래스터를 만들고 8방위 구간으로 재분류해 두 유역이 어느 쪽을 바라보는 사면이 많은지 같은 방식으로 비교해 보려고 한다.

작업 메모

이번 회차는 QGIS 시작 스크립트로 같은 대화상자에 값을 넣어 실행했고, 화면은 그때 캡처한 것이다. 원본 프로젝트는 그대로 두고 복사본(QGIS_Play_NaGeoAI_20261117_28_slopebands.qgz)에서 작업했다. 자료 출처는 USGS 3DEP(The National Map) 타일 13SDE474426이고, 원본 DTM은 재배포하지 않는다. 그림 5와 비율, 독립 계산은 출력 파일을 다시 읽는 별도 스크립트로 만든 것이다. QGIS 3.44.15, WhiteboxTools는 wbt_for_qgis 플러그인으로 실행했다. SHA-256 앞 12자리:

  • 입력 DTM 069a9c249240
  • 입력 병합 폴리곤 .shp / .dbf 235891ed214a / 67d3965a6d72
  • 경사 래스터 bdbbacc35eb1
  • 5° 구간 래스터 a01083bef248
  • 구역히스토그램 .shp / .dbf 235891ed214a / 0880d61e7416

2026-11-16

Whitebox 실제 QGIS 실습 27 — DTM 50 m 고도 구간으로 본 두 유역의 고도-면적 분포

26편에서 중간유역(A−B)과 B 유역의 표고 통계를 뽑았더니 평균은 중간유역이 약 76 m 높았고, B는 중앙값이 평균보다 14 m가량 낮았다. 평균 두 개만으로는 "어느 표고에 땅이 얼마나 있는가"를 말할 수 없다. 홍수 도달 시간이나 적설, 식생대를 따질 때 필요한 건 그 분포다. 그래서 이번에는 DTM을 50 m 간격 표고 구간으로 나누고, 유역마다 구간별 셀 수를 세어 표고-면적 분포를 나란히 놓아 봤다.

도구는 QGIS 기본 처리 알고리즘 두 개로 끝난다. 테이블로 재분류(Reclassify by table)로 표고를 구간 코드로 바꾸고, 구역히스토그램(Zonal histogram)으로 폴리곤 안의 코드별 셀 수를 센다. 1 m DTM이라 셀 하나가 1 m²이니 셀 수가 곧 면적이다.

자료

11편 1 m DTM(USGS 3DEP 타일 13SDE474426, NAD83 UTM 13N EPSG:26913, 지면점으로 만든 DTM)과 26편에서 만든 병합 폴리곤을 새 입력 폴더로 복사해 썼다. 복사본 해시는 원본과 같다.

입력원래 출처내용
wb27_input_dtm1m.tif11편 DTM1500×1500 셀, 1 m, float32, NoData −32768(1,834개 셀), 표고 1,712.96~2,284.53 m
wb27_input_basins_merged.shp26편 wb26_basins_mergedVALUE 1 = 중간유역 1,218,780 m², VALUE 2 = B 유역 211,372 m²

표고를 50 m 구간 코드로 재분류

DTM의 최저·최고가 1,712.96 m와 2,284.53 m라서 1,700 m부터 2,300 m까지 50 m씩 12개 구간을 잡았다. 구간 코드는 1, 2, 3 같은 일련번호 대신 구간의 아래 경곗값(1700, 1750, …, 2250)으로 넣었다. 그러면 나중에 히스토그램 필드 이름이 h_1900처럼 표고 자체가 되어 표를 읽을 때 번호표를 따로 볼 필요가 없다.

공간 처리 툴박스 → 래스터 분석 → 테이블로 재분류(Reclassify by table)를 열고 아래처럼 넣었다.

입력란값이유
래스터 레이어DTM 1 m elevation (practice 11)표고 원값
밴드 번호밴드 1
재분류 테이블12행 × 3열: 최소 1700 / 최대 1750 / 값 1700, … , 최소 2250 / 최대 2300 / 값 225050 m 간격, 값은 아래 경곗값
NODATA 값 산출−9999정수형 출력에 맞춘 NoData
범위 경계최소 <= 값 < 최대정확히 2,000 m인 셀을 2000~2050 구간에 넣기 위해
Use NoData when no range matches value체크표 밖의 값이 원래 값 그대로 남지 않도록
산출 데이터 유형Int16코드가 2250까지라 Int16으로 충분하고 파일이 작다
재분류된 래스터wb27_dtm_bands50m.tif
QGIS 테이블로 재분류 대화상자. 래스터 레이어 DTM 1 m elevation (practice 11), 밴드 1 (Gray), 재분류 테이블 고정된 테이블 (12x3), NODATA 값 산출 -9999, 범위 경계 최소 <= 값 < 최대, Use NoData when no range matches value 체크, 산출 데이터 유형 Int16이 보인다. 뒤 지도에는 음영기복도 위에 보라색 중간유역과 주황색 B 유역이 반투명하게 칠해져 있다.
그림 1. 테이블로 재분류 대화상자. 12개 구간 표와 범위 경계, Int16 출력을 지정했다.

범위 경계는 기본값이 "최소 < 값 <= 최대"다. 기본값으로 두면 정확히 2,000.0 m인 셀이 1950~2000 구간에 들어간다. 연속 실수 표고에서 정확히 경곗값인 셀은 드물지만, 구간 이름을 "2000~2050 m"라고 부를 거라면 아래 경계를 포함하는 쪽이 이름과 맞는다. 결과는 0.13초 만에 나왔다.

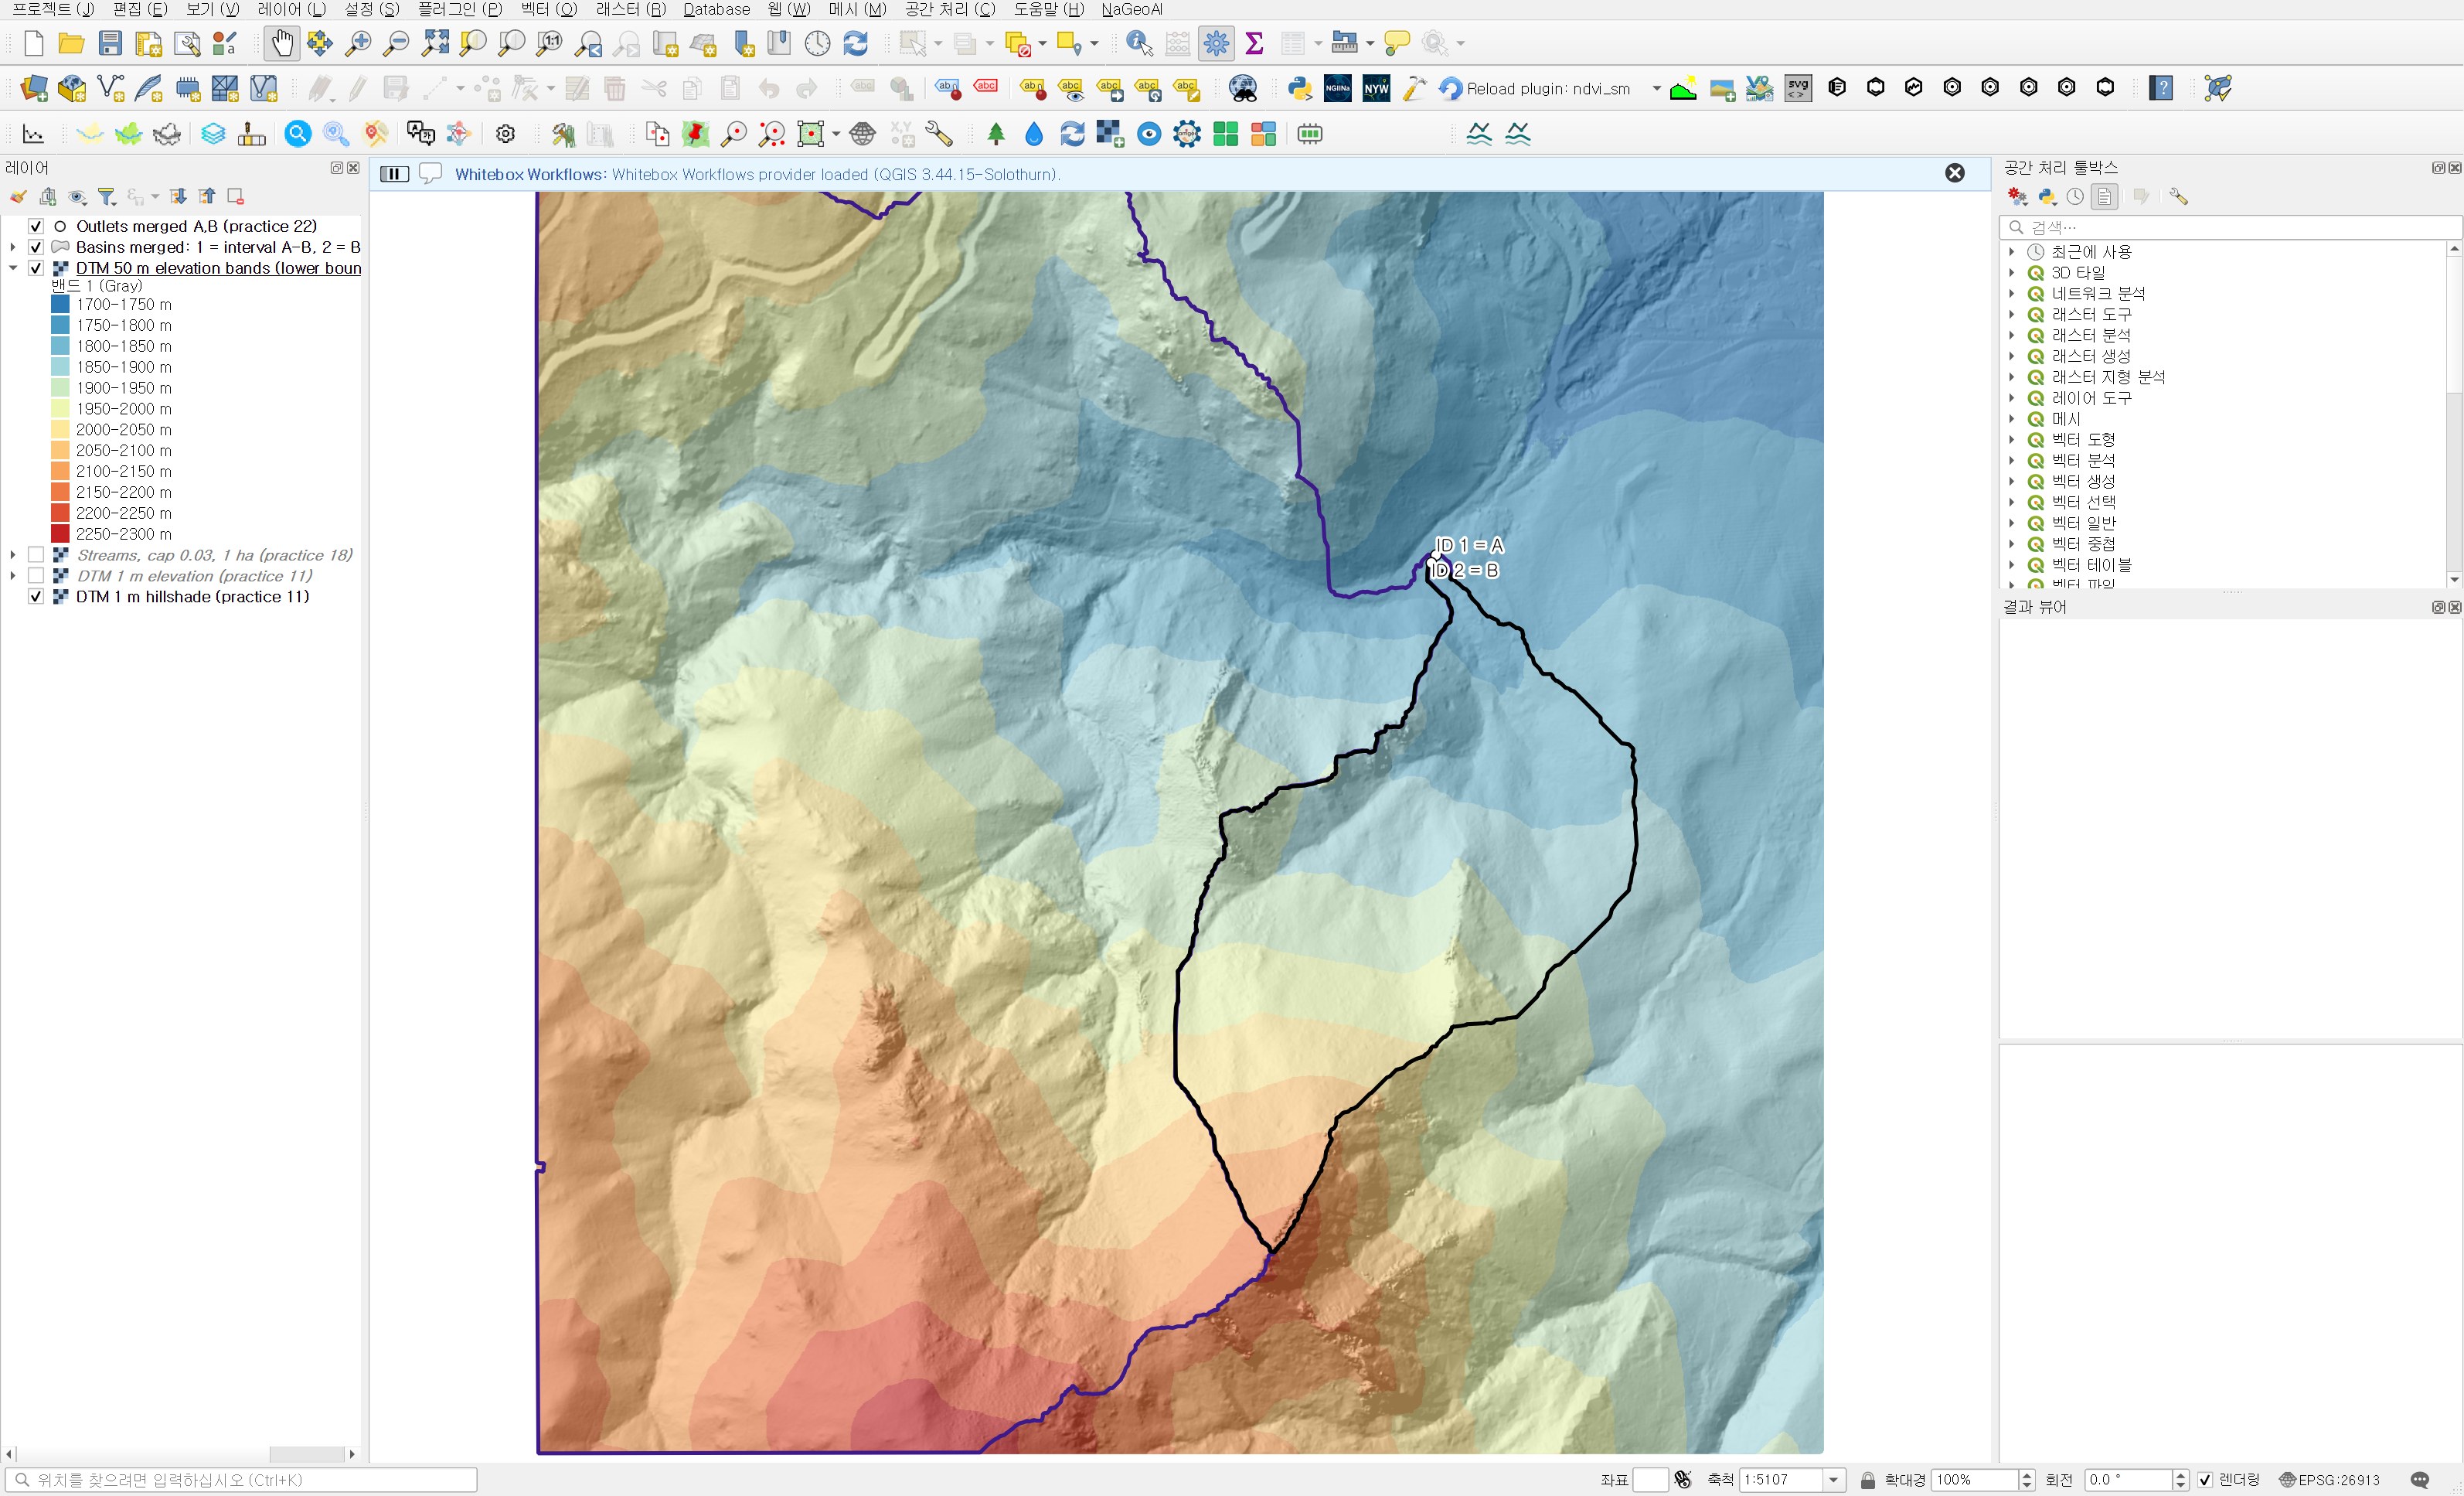
음영기복도 위에 50 m 표고 구간 래스터를 반투명하게 얹은 지도. 범례는 1700-1750 m 파란색부터 2250-2300 m 빨간색까지 12단계다. 북동쪽 골짜기가 파란색, 남서쪽 능선이 주황과 빨간색이다. 보라색 선이 중간유역 경계, 검은 선이 B 유역 경계이고 오른쪽 위 유출구 근처에 ID 1 = A, ID 2 = B 라벨이 있다.
그림 2. 50 m 표고 구간 래스터. 보라색 선은 중간유역, 검은 선은 B 유역 경계다.

지도로 보면 B 유역은 대부분 파란색과 연두색 구간에 걸쳐 있고 남쪽 끝만 주황색에 닿는다. 중간유역은 유출구 근처 파란색에서 남서쪽 빨간색 능선까지 색이 거의 다 들어 있다. 숫자로 확인할 차례다.

구역히스토그램으로 유역별 셀 수 세기

공간 처리 툴박스 → 래스터 분석 → 구역히스토그램(Zonal histogram)은 폴리곤마다 래스터의 고유값별 셀 수를 필드로 붙여 준다. 26편의 구역통계가 평균·최대 같은 요약값을 준다면, 이 도구는 값별 개수 표를 준다. 범주형 래스터(토지피복, 이번처럼 구간 코드)에 맞는 도구다.

입력란값이유
래스터 레이어DTM 50 m elevation bands (lower bound)방금 만든 구간 코드
밴드 번호밴드 1
구역을 담고 있는 벡터 레이어Basins merged: 1 = interval A-B, 2 = B (practice 26)두 유역이 한 레이어에 있어 결과도 한 표로 나온다
산출 열 접두어h_shp 필드명 10자 제한 안에 h_2250까지 들어간다
산출 구역wb27_basin_band_histogram.shp
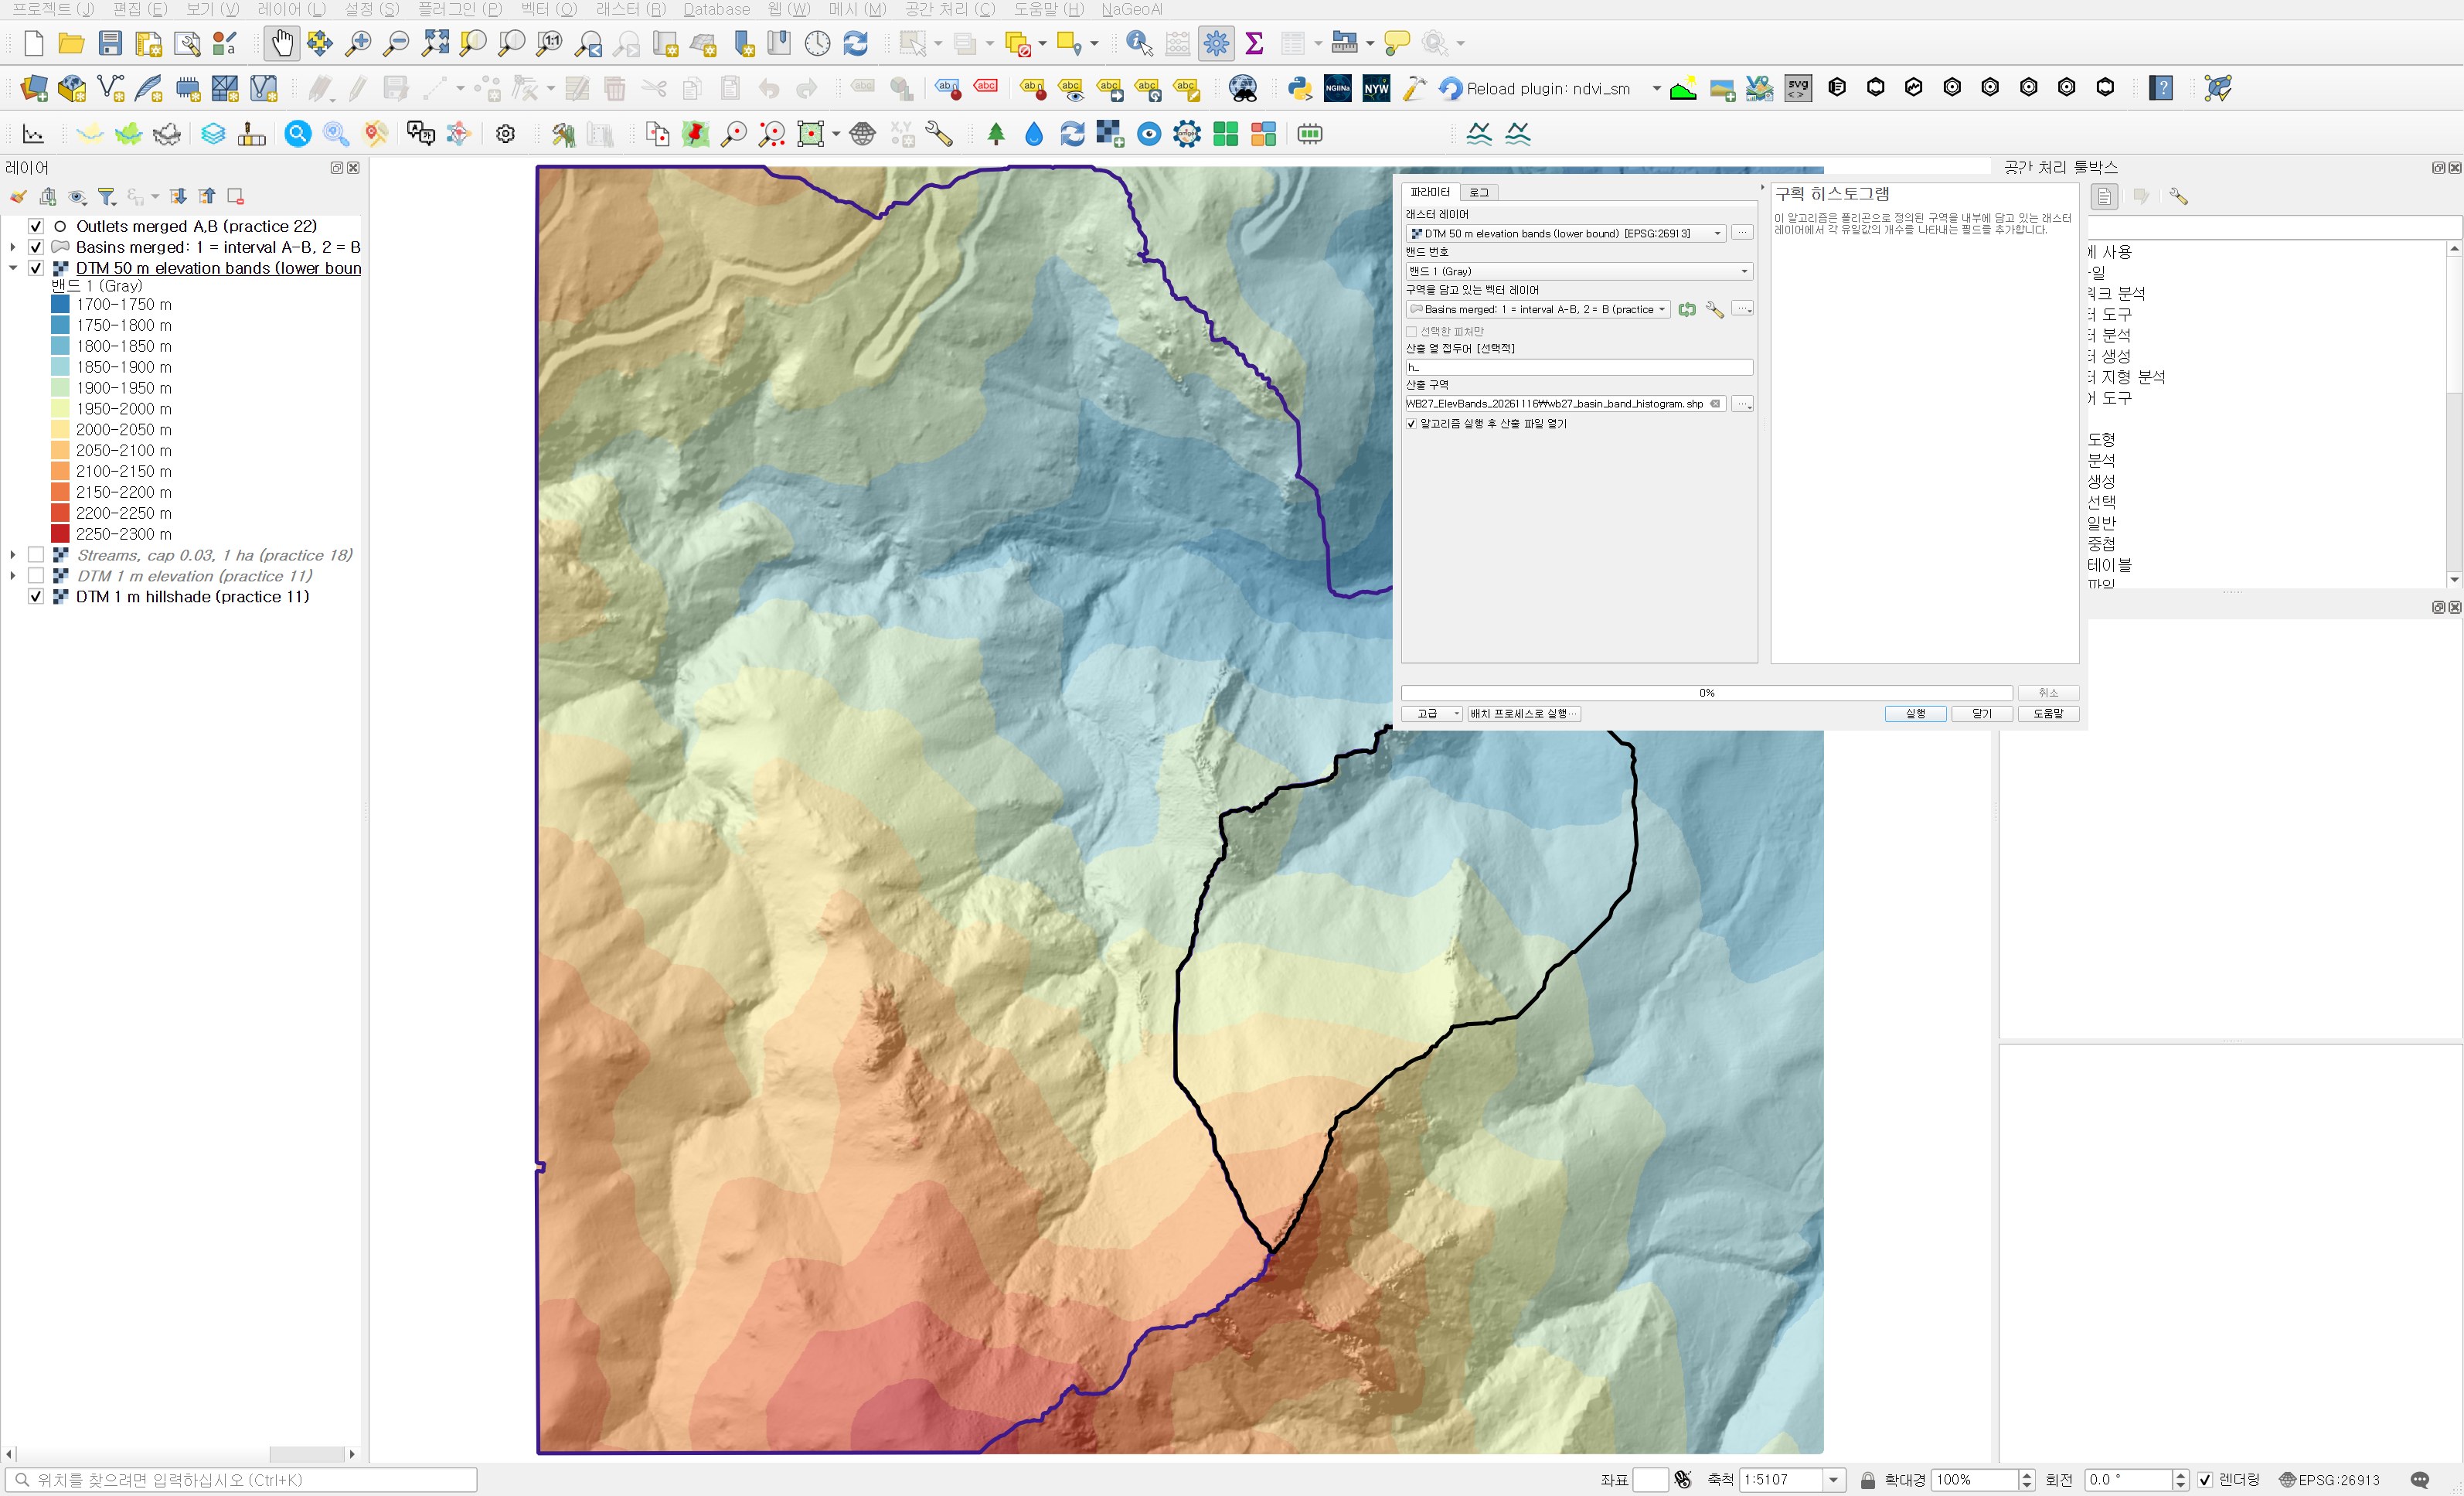
QGIS 구역히스토그램 대화상자. 래스터 레이어 DTM 50 m elevation bands (lower bound), 밴드 1 (Gray), 구역을 담고 있는 벡터 레이어 Basins merged: 1 = interval A-B, 2 = B, 산출 열 접두어 h_, 산출 구역 wb27_basin_band_histogram.shp가 입력되어 있다. 왼쪽 레이어 패널에 1700-1750 m부터 2250-2300 m까지 12개 구간 범례가 펼쳐져 있다.
그림 3. 구역히스토그램 대화상자. 구간 래스터와 병합 폴리곤을 넣었다.

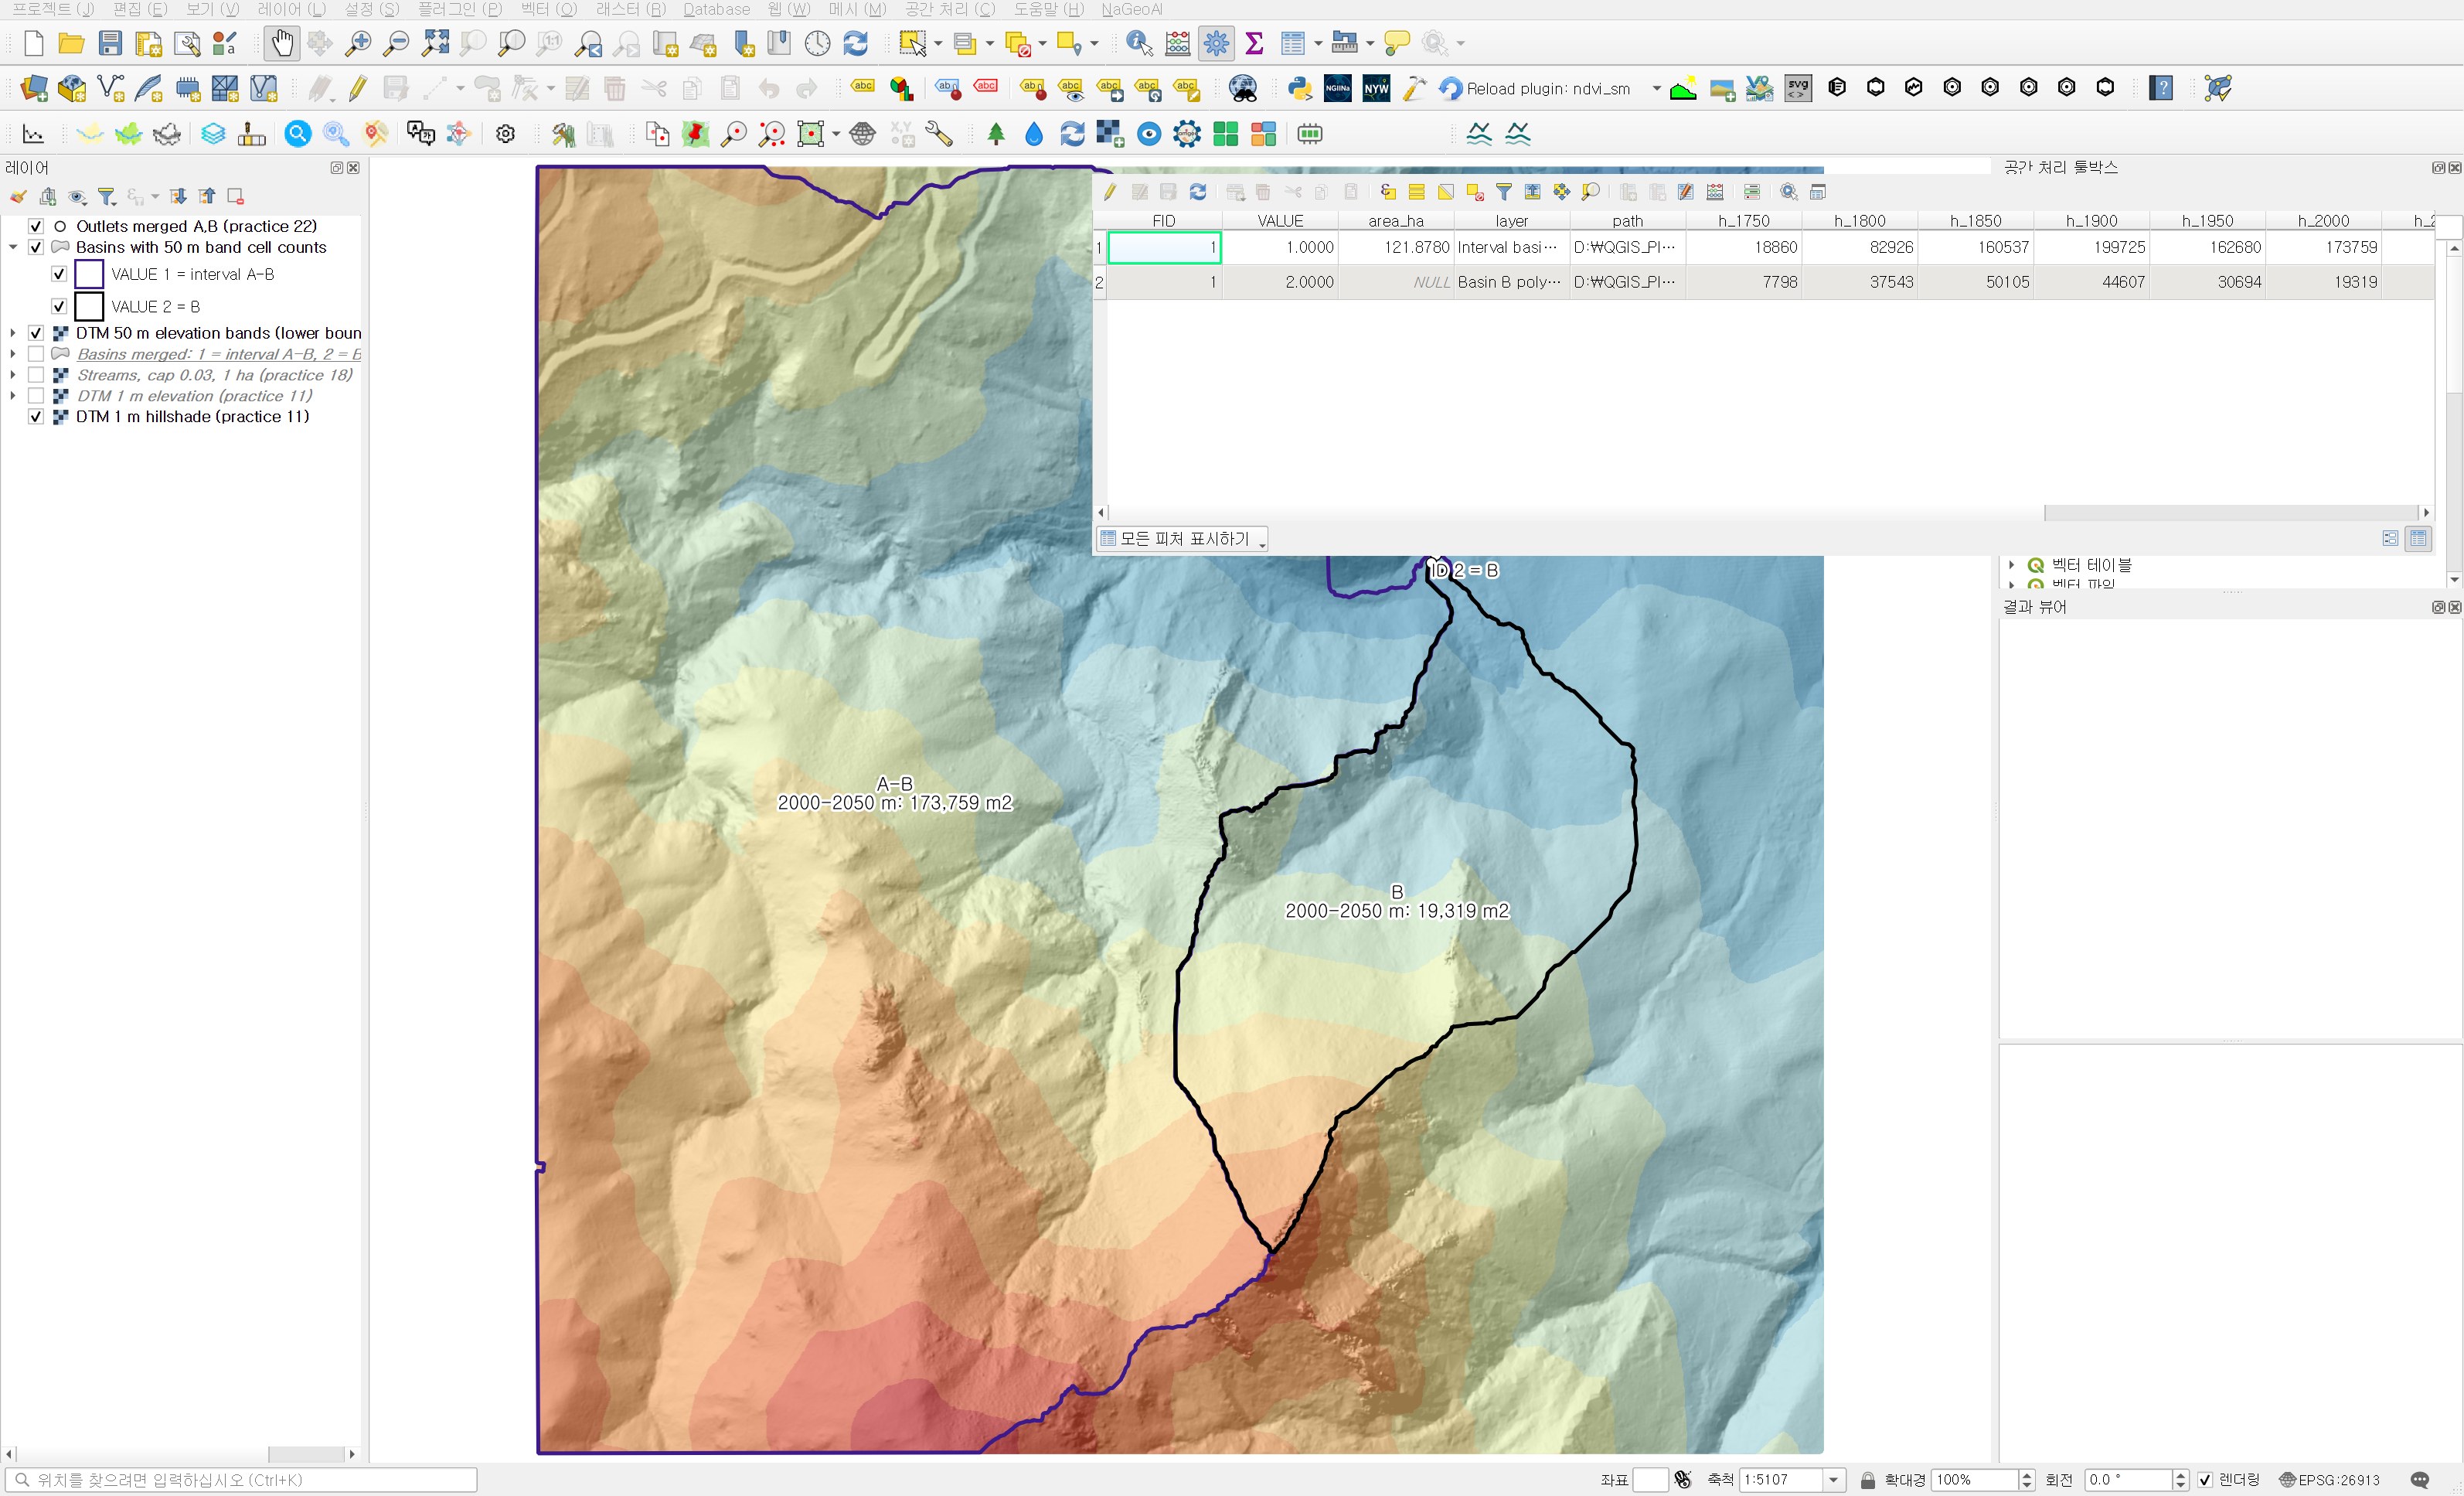
실행은 0.28초였다. 속성 표를 열면 h_1750부터 h_2250까지 11개 필드가 붙어 있다. 1700~1750 구간은 DTM 전체에 89,224개 셀이 있지만 두 유역 안에는 한 셀도 없어서 필드가 생기지 않았다. 두 유역의 최저 표고가 1,764.89 m, 1,765.33 m였으니 맞는 결과다.

Basins with 50 m band cell counts 속성 표와 지도. 표의 VALUE 1 행은 h_1750 18860, h_1800 82926, h_1850 160537, h_1900 199725, h_1950 162680, h_2000 173759이고, VALUE 2 행은 7798, 37543, 50105, 44607, 30694, 19319다. 오른쪽 필드는 표 폭 밖에 있다. 지도에는 중간유역 안에 A-B 2000-2050 m: 173,759 m2, B 유역 안에 B 2000-2050 m: 19,319 m2 라벨이 있다.
그림 4. 구역히스토그램 속성 표(h_2000까지 보임)와 2000~2050 m 구간 면적 라벨. 나머지 필드 값은 아래 표에 옮겼다.

구간별 면적과 비율

셀 수를 유역 전체 셀 수로 나눠 비율로 바꿨다. 면적이 다섯 배 넘게 차이 나는 두 유역을 비교하려면 절대 면적보다 비율이 낫다.

표고 구간중간유역 A−B 면적(m²)비율B 유역 면적(m²)비율
1750~1800 m18,8601.55%7,7983.69%
1800~1850 m82,9266.80%37,54317.76%
1850~1900 m160,53713.17%50,10523.71%
1900~1950 m199,72516.39%44,60721.10%
1950~2000 m162,68013.35%30,69414.52%
2000~2050 m173,75914.26%19,3199.14%
2050~2100 m153,33412.58%11,7475.56%
2100~2150 m147,37612.09%7,6053.60%
2150~2200 m74,9066.15%1,9130.91%
2200~2250 m33,3092.73%410.02%
2250~2300 m11,3680.93%00%
합계1,218,780100%211,372100%
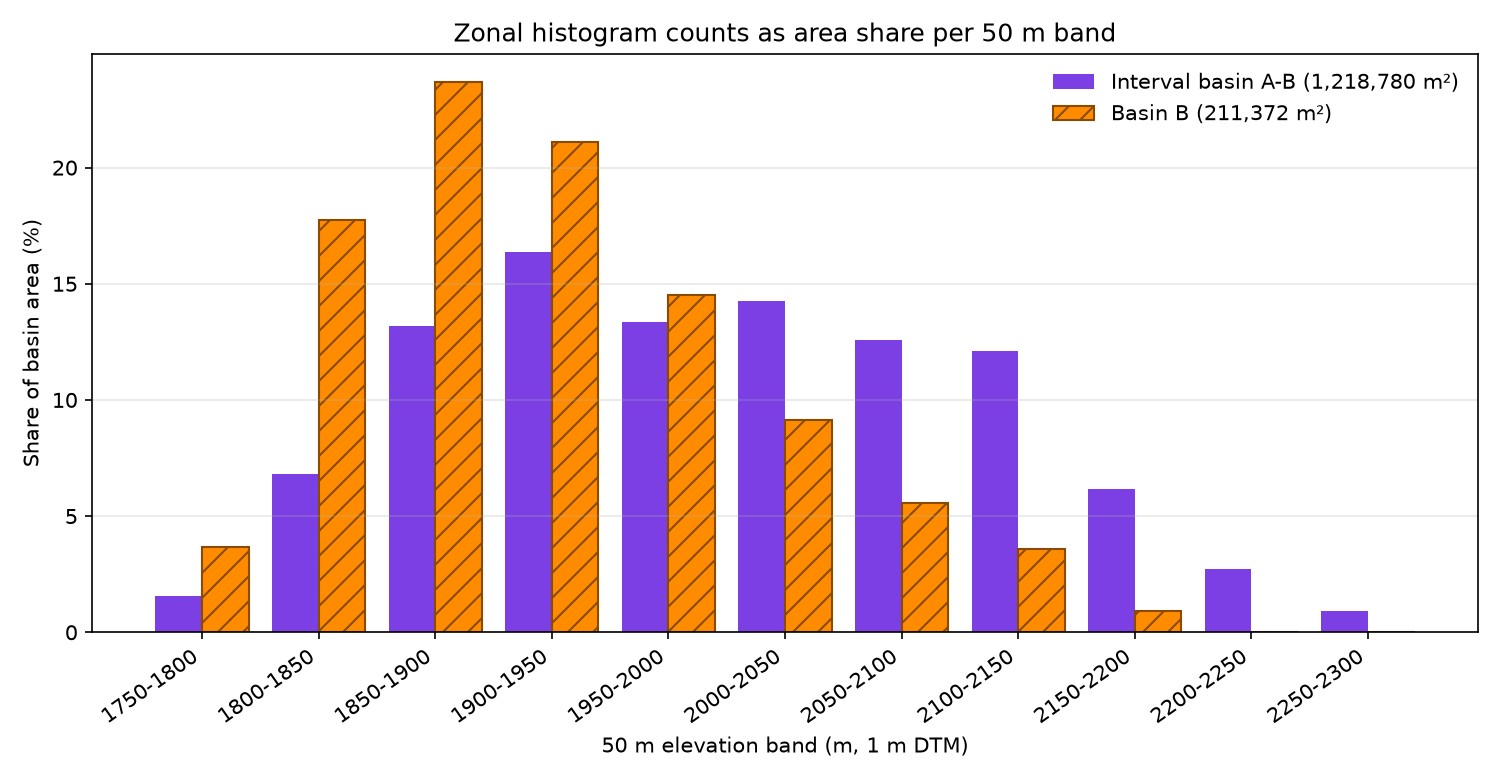
50 m 표고 구간별 유역 면적 비율 막대그래프. 가로축은 1750-1800부터 2250-2300까지 11개 구간, 세로축은 유역 면적 비율(%)이다. 보라색 막대(중간유역 A-B)는 1900-1950에서 16.4%로 가장 높고 1850~2150 구간에 12~16%로 고르게 퍼져 있다. 빗금 친 주황색 막대(B 유역)는 1850-1900에서 23.7%로 가장 높고 높은 구간으로 갈수록 빠르게 줄어 2200-2250에서 거의 0이다.
그림 5. 구역히스토그램 셀 수를 유역 면적 비율로 바꾼 막대그래프(QGIS 출력 표로 matplotlib에서 그림).

두 유역의 모양이 확실히 다르다. B는 1850~1900 m 구간이 23.71%로 가장 넓고, 그 위로 갈수록 빠르게 줄어든다. 1850~2000 m 세 구간에 면적의 59.33%가 몰려 있고, 2150 m 이상은 0.92%뿐이다. 유출구에서 멀지 않은 낮은 땅에 몸통이 있는 유역이다.

중간유역은 가장 넓은 구간(1900~1950 m)도 16.39%에 그친다. 대신 1850 m부터 2150 m까지 여섯 구간이 각각 12~16%로 거의 평평하게 이어진다. 2150 m 이상도 9.81%나 된다. 표고 폭 전체에 면적이 고르게 깔린 유역이라는 뜻이다. 26편에서 본 "2,000 m 이상 48.7% 대 19.2%"가 어디서 나왔는지 이 표에서 구간별로 보인다.

실무에서 이 차이가 의미 있는 건 표고가 기온, 강수 형태, 적설과 연결되기 때문이다. 같은 강우라도 높은 구간 비중이 큰 중간유역은 눈으로 내리는 면적이 더 넓을 수 있다. 다만 이 자료만으로 적설 면적이나 유출 시점을 말할 수는 없다. 그러려면 이 지역 기온 감률이나 관측 적설 자료를 따로 붙여야 한다. 여기서 확인한 건 표고별 면적 분포까지다.

독립 계산으로 확인

재분류 결과가 표대로 나왔는지, 히스토그램이 셀을 제대로 셌는지 별도 스크립트로 다시 계산했다. numpy로 표고를 50으로 나눠 내림한 뒤 50을 곱해 같은 구간 코드를 만들었더니 QGIS 출력과 225만 셀 전체에서 다른 셀이 0개였다. 폴리곤을 셀 중심 기준으로 같은 격자에 래스터화해 구간별 셀 수를 센 값도 속성 표와 두 유역 모든 구간에서 같았다. 유역별 셀 수 합계는 1,218,780과 211,372로 26편 면적과 정확히 일치한다.

실무에서 챙길 것

  • 재분류 범위 경계 기본값은 "최소 < 값 <= 최대"다. 구간 이름을 아래 경계 기준으로 붙일 거면 "최소 <= 값 < 최대"로 바꾼다.
  • 재분류 표가 DTM 전체 범위를 덮는지 먼저 확인한다. 범위 밖 값은 "Use NoData when no range matches value"를 끄면 원래 값으로 남아 엉뚱한 코드처럼 섞인다.
  • 구역히스토그램은 셀 중심이 폴리곤 안에 있는 셀만 센다. 이번처럼 래스터에서 만든 폴리곤이면 셀 수와 면적이 딱 맞지만, 다른 출처 경계라면 경계 셀 때문에 합계가 폴리곤 면적과 달라진다. 합계를 면적과 한 번 비교해 둔다.
  • 구간이 많아지면 shp 필드가 늘어나 속성 표가 옆으로 길어진다. 비교 표를 만들 때는 CSV로 내보내거나 이번처럼 비율 표로 옮긴다.
  • 50 m라는 간격은 이번 유역 표고 폭(약 520 m)에서 10개 남짓 구간이 나오도록 고른 값이다. 표고 폭이 좁은 유역이면 간격을 줄여야 분포 모양이 보인다.

다음 회차

표고 분포는 확인했으니 다음은 경사다. 26편에서 표준편차가 크다고 경사가 급한 건 아니라고 했는데, 실제로 DTM에서 경사 래스터를 만들어 두 유역의 경사 분포를 같은 방식(구간 재분류와 구역히스토그램)으로 비교해 보려고 한다.

작업 메모

이번 회차는 QGIS 시작 스크립트로 같은 대화상자에 값을 넣어 실행했고, 화면은 그때 캡처한 것이다. 원본 프로젝트는 그대로 두고 복사본(QGIS_Play_NaGeoAI_20261116_27_elevbands.qgz)에서 작업했다. 자료 출처는 USGS 3DEP(The National Map) 타일 13SDE474426이고, 원본 DTM은 재배포하지 않는다. 그림 5와 비율, 독립 계산은 출력 파일을 다시 읽는 별도 스크립트로 만든 것이다. QGIS 3.44.15. SHA-256 앞 12자리:

  • 입력 DTM 069a9c249240
  • 입력 병합 폴리곤 .shp / .dbf 235891ed214a / 67d3965a6d72
  • 50 m 구간 래스터 8ac146e8da50
  • 구역히스토그램 .shp / .dbf 235891ed214a / bf5a73f6f6d7

노르딕워킹 폴을 앞으로 멀리 찍게 될 때, 앞발 옆 무게중심 아래로 가져오는 점검

노르딕워킹을 시작하면 팔을 앞으로 쭉 뻗어 폴을 멀리 찍고 싶어집니다. 폴이 멀리 닿으면 멀리 나가는 느낌이 들기 때문입니다. 스위스 건강보험사 Helsana의 건강 블로그와 독일 폴 제조사 LEKI의 초보자 안내는 이 습관을 흔한 실수로 꼽습니다....