2026-09-30

산불을 위성으로 감시하고 피해를 추정하는 법 | GeoAI 기초 14편

산불을 위성으로 감시하고 피해를 추정하는 법 | GeoAI 기초 14편

🎬 1분 브리핑 영상

📌 3줄 요약

  • 열적외선 밴드로 열이 나는 화점을 찾아냅니다
  • dNBR로 불탄 정도(심도)를 지도로 만듭니다
  • 조기 감지와 사후 평가는 쓰임새가 다릅니다

새벽 세 시, 산속 어딘가에서 불씨가 번지기 시작합니다. 사람 눈에 연기가 보이기 전, 위성은 이미 그 자리의 온도 변화를 감지하고 있을 수 있습니다. 반대로 불이 다 꺼진 뒤에는 "얼마나 탔는지"를 알아야 복구 계획을 세울 수 있는데, 이건 또 다른 방식의 분석이 필요합니다. 산불 하나를 두고도 위성이 하는 일은 시점에 따라 완전히 다릅니다. 이번 편에서는 화점을 찾는 열적외선 원리와, 피해 정도를 수치로 매기는 dNBR을 나눠서 살펴보겠습니다.

Satellite wildfire heat detection
자료사진 · 사진: xresch / Pixabay

🔥 위성은 산불이 난 걸 어떻게 알아채나요?

사람이 하늘에서 산불을 확인하려면 연기나 불빛이 보여야 합니다. 하지만 위성은 그럴 필요가 없습니다. 열적외선(thermal infrared, 물체가 내는 열을 감지하는 파장 대역) 밴드는 연기나 야간의 어둠과 상관없이 지표면의 온도 자체를 잽니다. 불이 붙은 지점은 주변보다 훨씬 뜨거워서 이 밴드에서 밝은 점, 즉 화점(hotspot)으로 나타납니다. 이 방식 덕분에 야간이나 구름이 옅게 낀 상황에서도 최초 발화 신호를 비교적 빨리 잡아낼 수 있어, 산불 초기 대응에서 골든타임을 버는 데 실제로 활용됩니다.

🌡️ 열적외 밴드로 화점을 어떻게 골라내나요?

열적외 영상은 각 픽셀의 밝기온도(brightness temperature, 복사에너지를 온도로 환산한 값)를 계산합니다. 이 값이 주변 배경보다 일정 수준 이상 높으면 화점 후보로 표시하는 방식이 일반적입니다. 문제는 뜨거운 공장 지붕, 용광로, 사막의 뜨거운 암석 같은 것도 비슷하게 잡힐 수 있다는 점입니다. 그래서 여러 밴드를 함께 보거나 주변 픽셀과 비교하는 알고리즘을 씁니다. 실제 재난 대응에서는 위성 화점 정보를 그대로 신고 접수처럼 쓰지 않고, 지자체나 산림 당국이 다른 관측 자료와 교차 확인한 뒤 출동 여부를 판단하는 참고 자료로 활용합니다.

🌲 불이 지나간 자리, 얼마나 심하게 탔는지 어떻게 아나요?

불이 꺼진 뒤에는 화점 대신 정규탄화지수(NBR, Normalized Burn Ratio)를 씁니다. 식생은 근적외선을 잘 반사하고 단파적외선은 잘 흡수하는데, 타고 나면 이 관계가 뒤집힙니다. 이 차이를 이용해 화재 전 NBR에서 화재 후 NBR을 뺀 값을 dNBR(differenced NBR)이라 부르고, 값이 클수록 심하게 탄 것으로 해석합니다. dNBR 지도는 색깔로 등급을 나눠 보여주는 경우가 많아 어디가 완전 연소되고 어디가 살아남았는지 한눈에 보입니다. 이 지도는 복구 우선순위를 정하거나 산사태 위험이 커진 지역을 미리 파악하는 데 쓰입니다.

⏱️ 조기 감지와 사후 평가는 왜 역할이 다른가요?

조기 감지는 속도가 생명입니다. 해상도가 다소 거칠어도 하루에 여러 번 지나가는 위성으로 "지금 어디가 뜨거운가"를 빨리 알리는 게 목적입니다. 반면 사후 평가는 속도보다 정밀도가 중요합니다. 해상도가 좋은 영상으로 시간을 들여 dNBR을 계산하고, 피해 면적과 심도 등급을 구분해 보고서에 담습니다. 이 둘을 헷갈리면 곤란합니다. 화점 탐지 결과로 피해 면적을 발표하거나, dNBR 지도로 "지금 불이 어디 있는지"를 판단하려 하면 시점과 목적이 맞지 않는 분석이 됩니다.

⚠️ 위성으로 본 산불 정보, 그대로 믿어도 될까요?

위성 자료는 강력하지만 절대적이지 않습니다. 두꺼운 연기나 구름은 열적외선도 방해할 수 있고, dNBR 역시 지역의 식생 종류나 촬영 시기 차이에 따라 값이 흔들릴 수 있습니다. 그래서 실무에서는 위성 결과를 발표하기 전에 반드시 지상 조사나 드론 영상, 다른 위성 자료와 겹쳐 확인하는 절차를 거칩니다. 이건 해봐야 아는 부분인데, 같은 화재 전후 영상을 다른 임계값으로 나눠 보면 심도 등급 경계가 달라지는 걸 직접 확인할 수 있습니다. 이런 검증 없이 지도를 그대로 배포하면 복구 예산이나 위험 지역 판단이 어긋날 수 있어 주의가 필요합니다.

🖥️ 화면에서 따라하기

따라하기 단계

  1. 사이트 접속
    NASA FIRMS 같은 공개 화재 지도 웹사이트에 접속해 지도 화면을 연다
  2. 지역 선택
    지도를 이동하거나 검색창에 확인하려는 지명을 입력한다
  3. 레이어 켜기
    화면 오른쪽 레이어 패널에서 화점 레이어(예: VIIRS, MODIS)를 켠다
  4. 기간 설정
    화면 하단 날짜 슬라이더로 확인할 날짜 범위를 선택한다
  5. 화점 확인
    지도 위 표시된 점을 클릭해 감지 시각과 밝기온도 정보를 본다
  6. 전후 비교
    Google Earth Engine에서 화재 전후 Sentinel-2 영상을 불러와 NBR 값을 비교한다(메뉴 이름은 버전에 따라 다를 수 있어 못 찾으면 도움말이나 레이어 목록 쪽을 살펴보세요)

※ 프로그램 버전에 따라 메뉴 이름이 조금씩 다를 수 있습니다. 위 그림은 순서를 정리한 도식입니다.

✍️ 그대로 복사해 쓰는 프롬프트

dNBR 분석 결과를 바탕으로 산불 피해 보고서 초안 만들기

당신은 재난안전 부서에서 산불 피해 현황을 정리하는 담당자입니다. 아래 정보를 바탕으로 보고서 초안을 작성해 주세요.
화재 발생 지역: [지역명]
화재 발생 및 진화 일시: [일시]
dNBR 분석 결과: 심함 [면적/비율], 중간 [면적/비율], 약함 [면적/비율]
보고서에는 피해 요약, 등급별 해석, 향후 복구 시 우선 확인이 필요한 지역을 순서대로 담아 주세요.
전문 용어는 처음 나올 때 한 줄로 풀어서 설명하고, 확인되지 않은 수치나 원인은 추정하지 말고 "현장 확인 필요"로 표시해 주세요.
결과를 받으면 등급 구분 기준과 면적 수치가 실제 분석값과 일치하는지 반드시 대조해서 확인하세요.

※ 대괄호 부분을 상황에 맞게 바꿔서 쓰세요. 받은 답은 그대로 쓰지 말고 사실 확인을 거치세요.

🧪 직접 해보기

  • NASA FIRMS 같은 공개 화재 지도에서 최근 화점이 표시된 지역을 찾아본다
  • Google Earth Engine에서 화재 전후 Sentinel-2 영상으로 NBR 값을 계산해 비교해본다
  • 같은 화재 지역을 다른 날짜 범위로 조회해 화점 개수가 어떻게 달라지는지 확인해본다

❓ 자주 묻는 질문

Q. 산불 연기가 있으면 위성으로 화점을 못 찾나요?
A. 가시광선 영상은 연기에 가려지지만 열적외 밴드는 연기를 어느 정도 투과해 열원을 감지합니다. 다만 아주 두꺼운 연기나 구름은 여전히 방해가 될 수 있습니다.

Q. dNBR 값이 높으면 무조건 다 탔다는 뜻인가요?
A. dNBR은 상대적인 지표라 절대적인 판단 기준은 아니고, 지역별로 임계값을 나눠 등급으로 해석합니다. 지상 조사와 함께 확인하는 것이 안전합니다.

Q. 화점 탐지와 실제 화재 발생은 항상 일치하나요?
A. 아닙니다. 뜨거운 지붕이나 공장 같은 열원도 화점으로 잘못 표시될 수 있어 추가 영상이나 현장 확인이 필요합니다.

화점 탐지가 "지금 어디가 급한가"를 알려준다면, dNBR은 "얼마나 심각했는가"를 알려주는 도구입니다. 두 역할을 구분해 쓰는 것만으로도 산불 대응 보고서의 신뢰도가 달라집니다. 다음 편에서는 이렇게 얻은 피해 지도가 산사태나 토사 유출 위험과 어떻게 이어지는지 살펴보겠습니다.

GeoAI 기초 시리즈 14편 · 전체 43편


재난안전과 GeoAI 이야기를 더 보고 싶다면 아래 채널도 함께 보세요.

📌 바로가기

NaGeoAI 실제 QGIS 실습 3 | STAC로 Sentinel-2 영상 검색·다운로드와 자산 키 검증

실습 목적과 범위

이번 실습에서는 QGIS 3.44.12와 NaGeoAI 1.9.0의 추가 분석 → 위성영상 다운로드 기능으로 Microsoft Planetary Computer의 STAC(SpatioTemporal Asset Catalog)에서 Sentinel-2 L2A 자료를 검색하고 자산을 내려받았다. 검색 결과의 자산 키, 파일 형식, 좌표계, 구름량을 확인하는 데 목적이 있다. 영상분류나 변화탐지를 수행한 것은 아니다.

플러그인 설치와 예제 자료

  1. NaGeoAI 1.9.0 ZIP 배포본을 다운로드한다.
  2. QGIS의 플러그인 → 플러그인 관리 및 설치 → ZIP에서 설치에서 다운로드한 파일을 선택한다. 설치 후 플러그인을 활성화하고 NaGeoAI → 추가 분석 → 위성영상 다운로드를 연다.
  3. 이번 실습에서는 플러그인을 다시 설치하지 않았다. 설치 단계의 실제 과거 화면은 실습 1을 참고한다. 이 글의 QGIS 화면은 오늘 수행한 STAC 실습의 실제 캡처다.
  4. 별도 예제 파일을 선행 다운로드할 필요는 없다. 이 기능의 예제 자료는 Microsoft Planetary Computer의 Sentinel-2 STAC 카탈로그에서 아래 입력값으로 내려받는다. 이미 가진 QGIS 프로젝트의 배경지도는 분석 입력으로 사용하지 않았다.

실습 시작 프로젝트는 QGIS_Play.qgz(EPSG:5187)이고, 원본은 보존했다. 실습 내용은 QGIS_Play_NaGeoAI_20260930_stac.qgz라는 복사본에 저장한 후 QGIS를 정상 종료했다. 시작 프로젝트에는 분석용 래스터가 없으므로 이번 실습의 입력은 STAC 원격 검색 조건이다.

단계 1. 검색 조건 입력

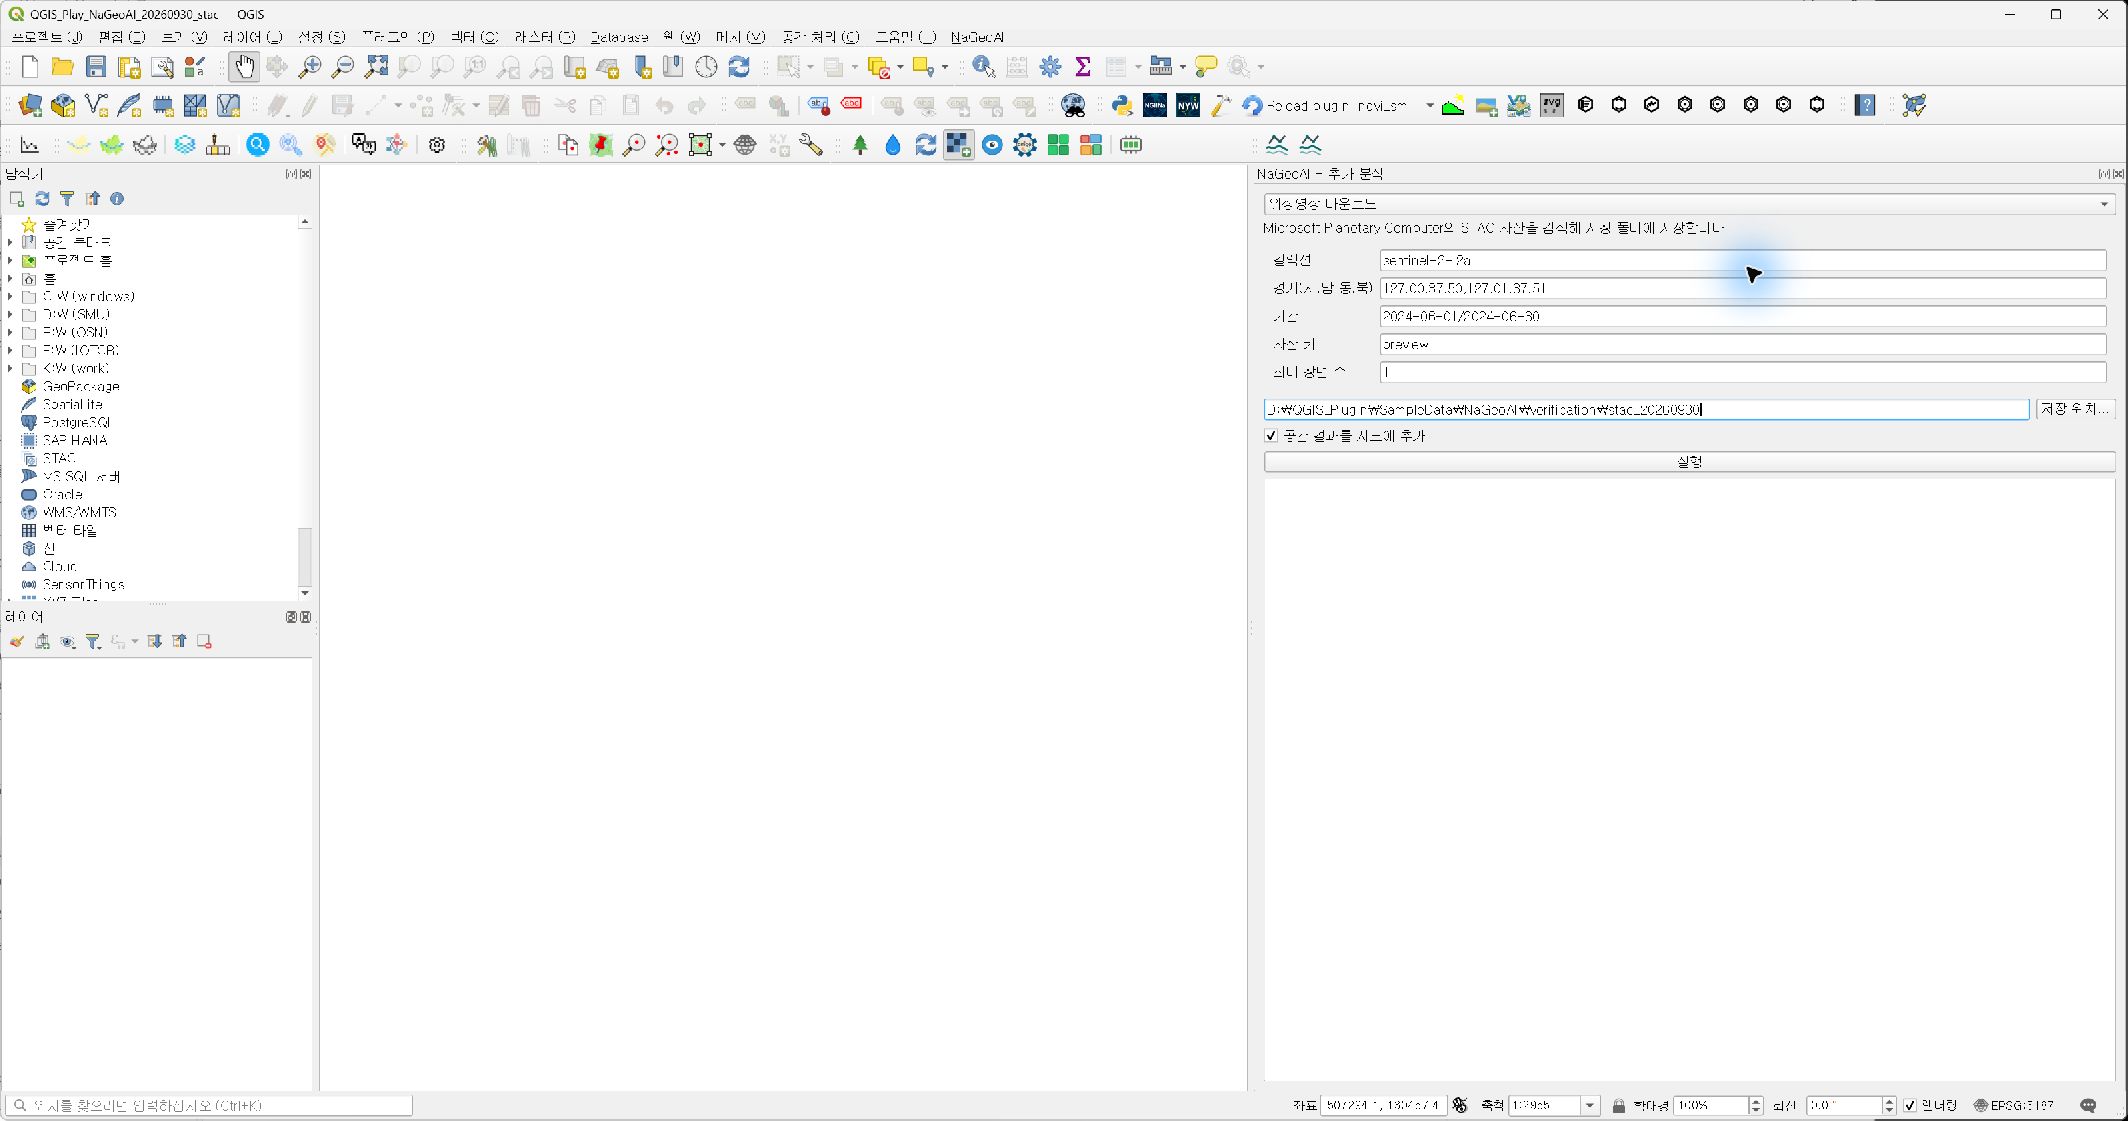
NaGeoAI 패널에서 컬렉션 sentinel-2-l2a, 검색 영역(BBOX, 경도·위도 순서) 127.00,37.50,127.01,37.51, 기간 2024-06-01/2024-06-30, 자산 키 preview, 최대 항목 수 1을 입력했다. 출력 폴더를 지정하고 지도에 추가 옵션을 선택했다. 프로젝트 CRS(EPSG:5187)와 검색 영역의 경위도 입력을 혼동하지 않아야 한다.

실제 QGIS 화면 1: 시작 프로젝트와 STAC 검색 입력값

그림 1. 시작 프로젝트와 STAC 검색 입력값(2026년 9월 30일 실제 QGIS 화면)

단계 2. 첫 결과와 구름량 확인

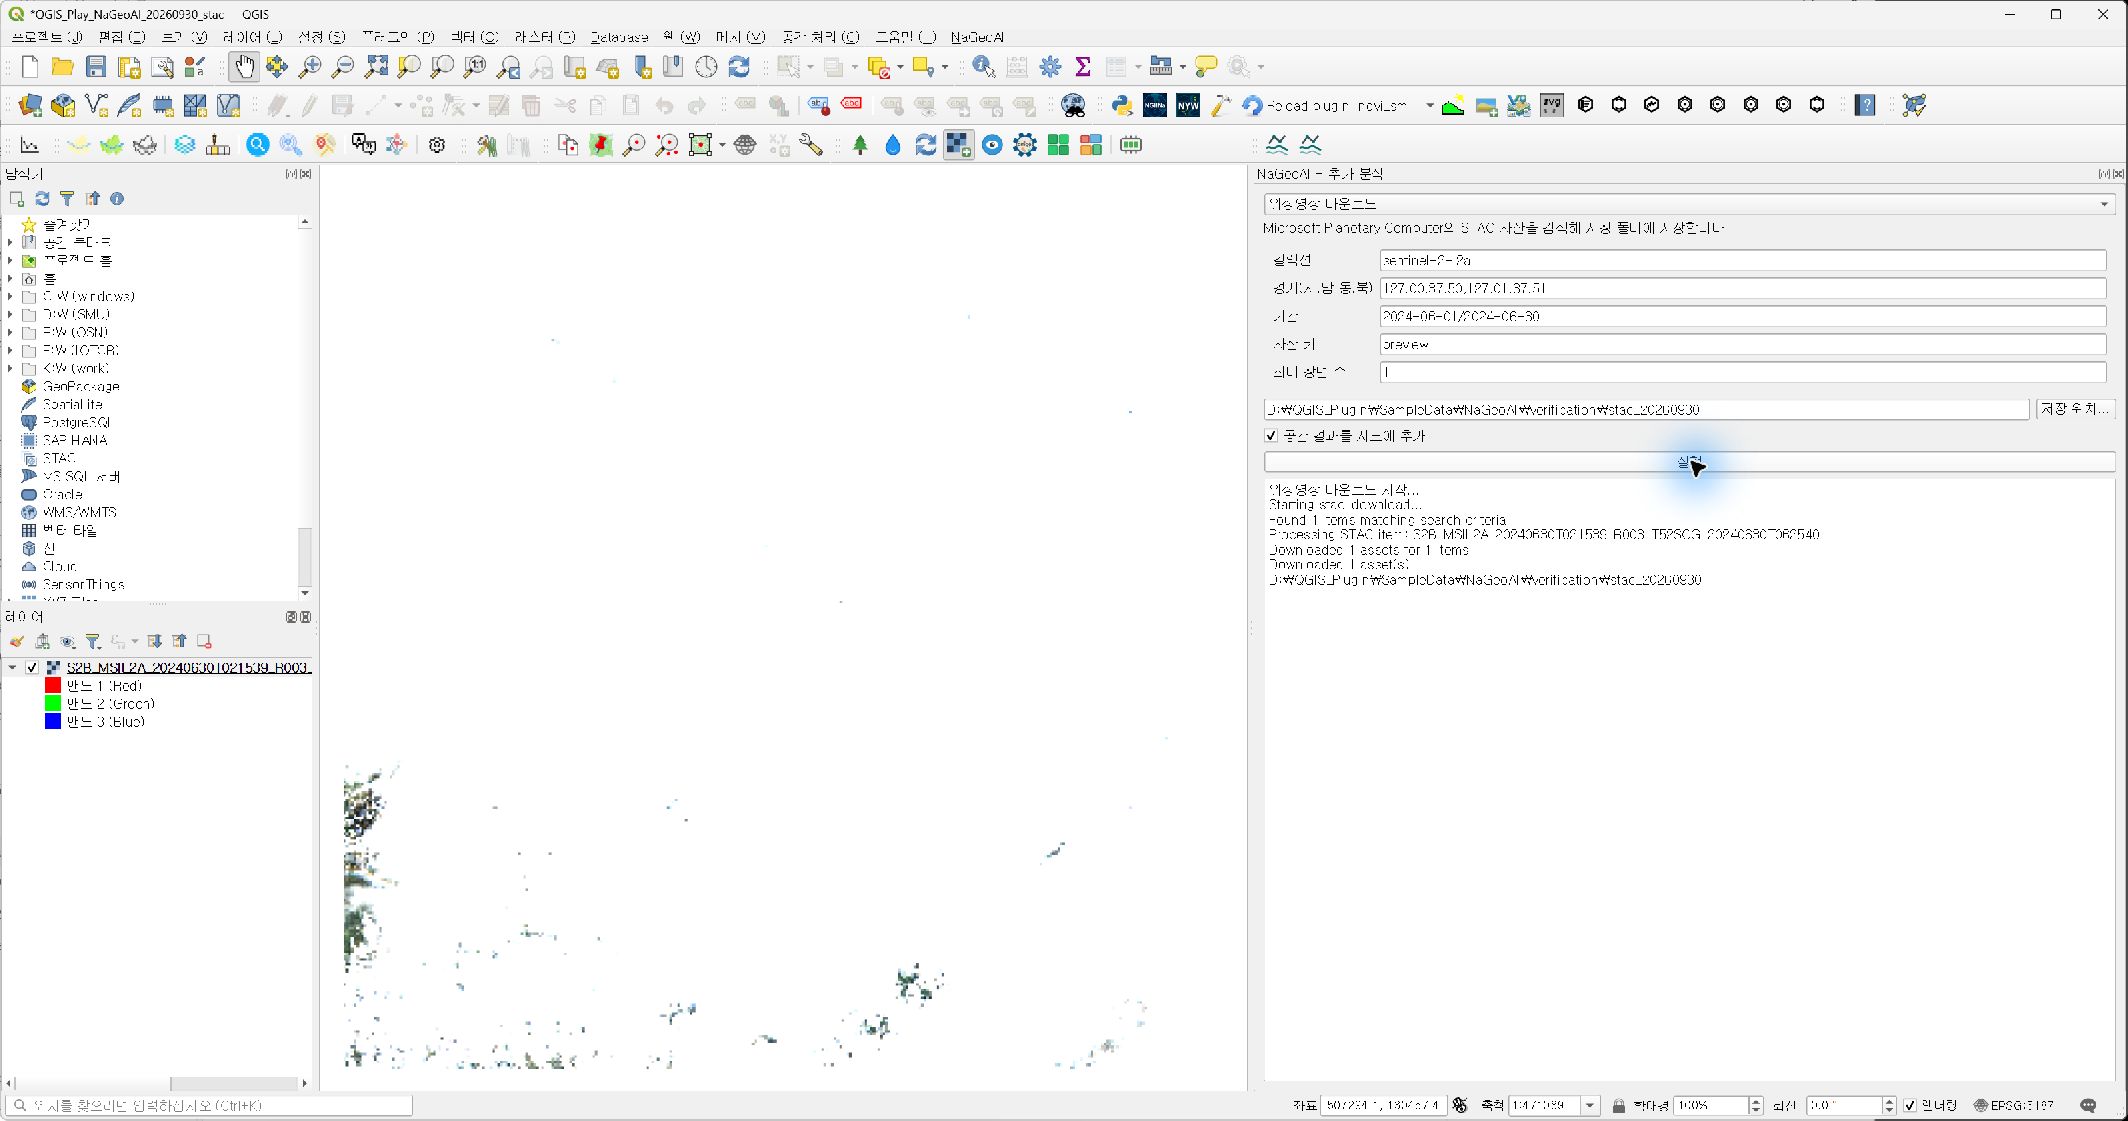
실행 로그에 1개 항목과 1개 자산의 처리가 기록되었다. 내려받은 항목 ID는 S2B_MSIL2A_20240630T021539_R003_T52SCG_20240630T062540이다. QGIS 지도에 추가된 preview TIFF는 거의 흰색으로 보였다. STAC 메타데이터의 eo:cloud_cover 값은 99.778891%였다. 따라서 다운로드 성공과 분석에 적합한 장면의 확보는 서로 다른 판단이다.

실제 QGIS 화면 2: 첫 다운로드 직후 로그와 출력 레이어

그림 2. 첫 다운로드 직후 로그와 출력 레이어(2026년 9월 30일 실제 QGIS 화면)

단계 3. 출력 파일의 공간정보 검증

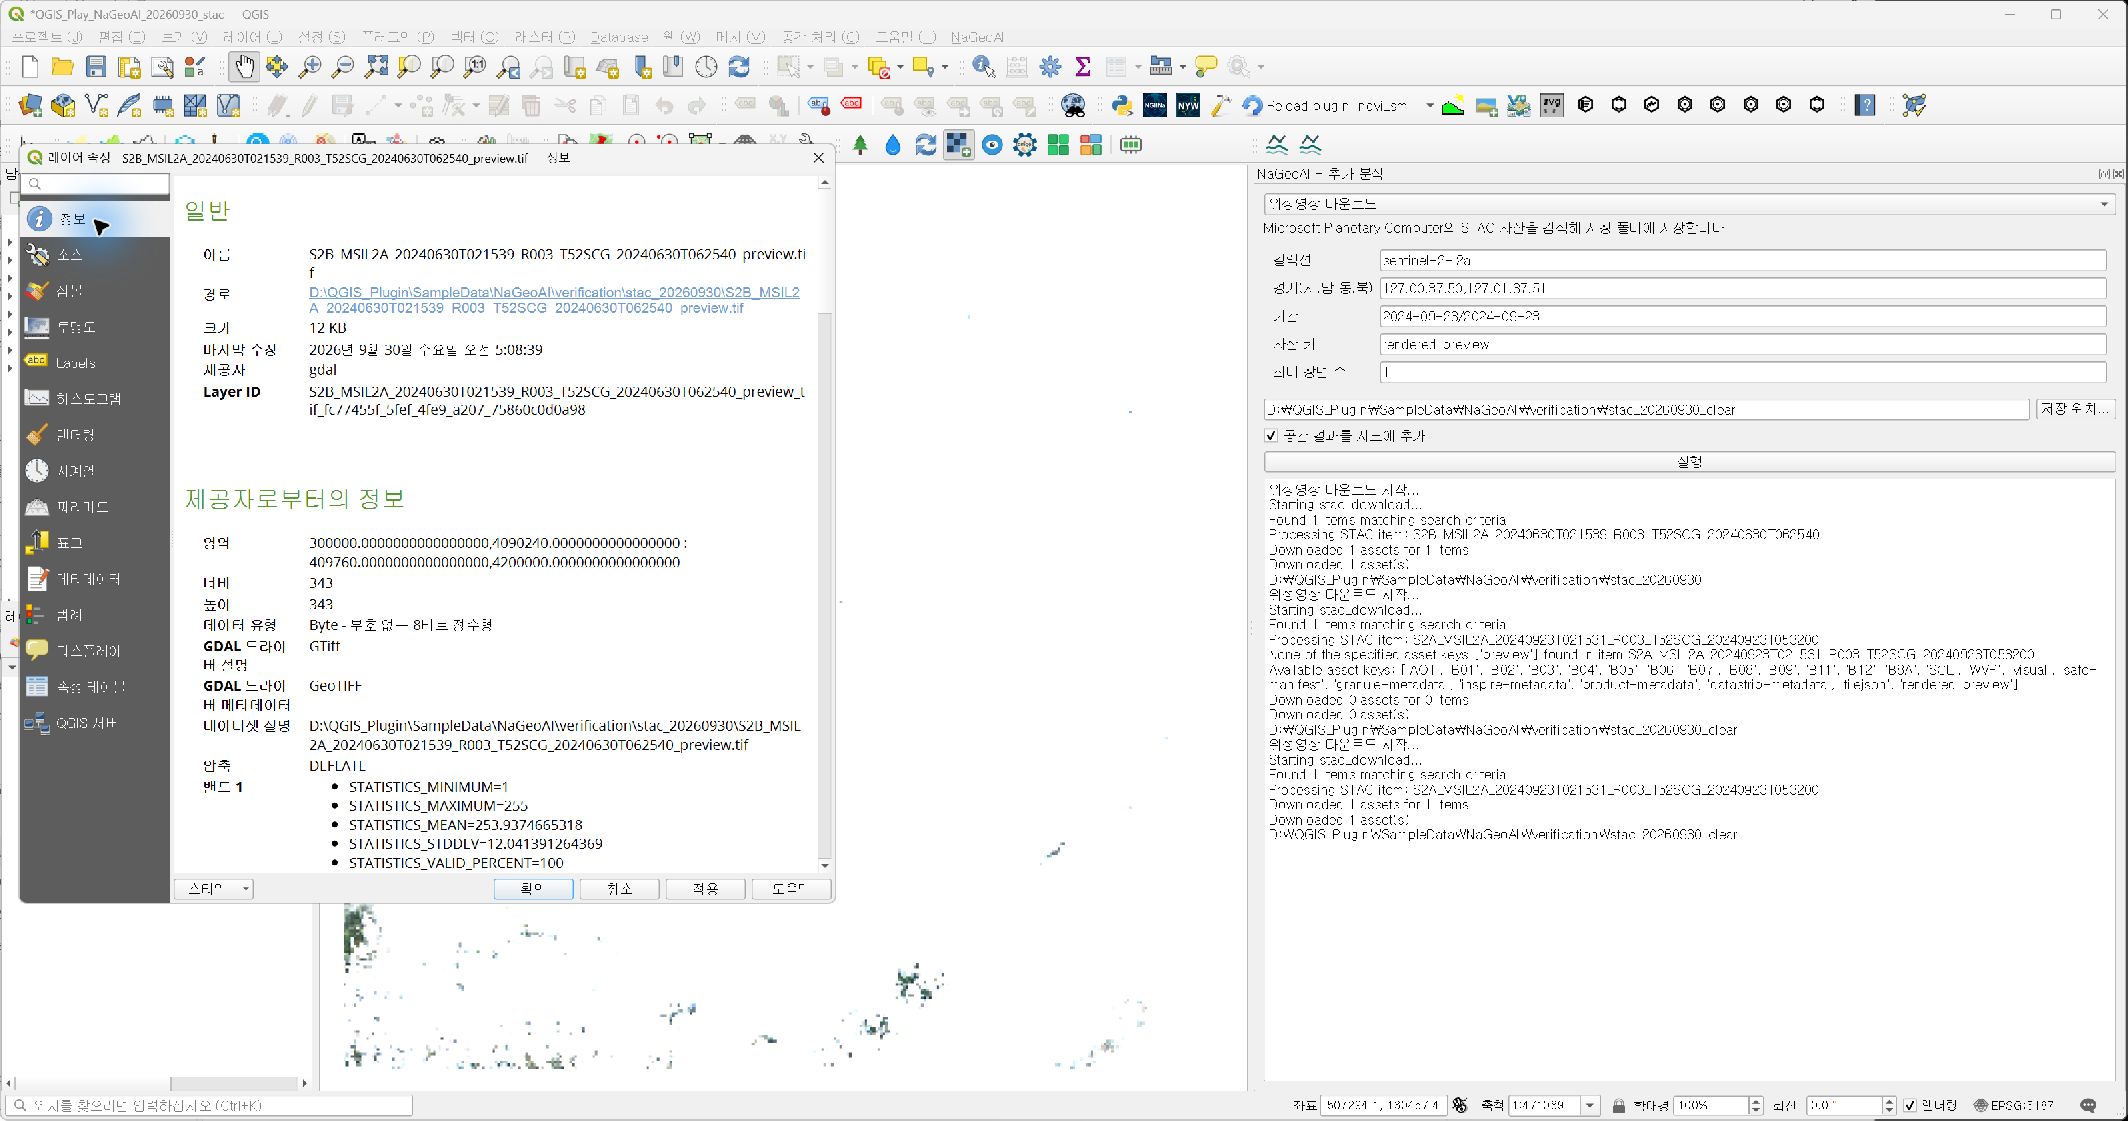
QGIS 레이어 속성에서 첫 TIFF의 크기가 343×343픽셀임을 확인했다. 별도의 GDAL 점검 결과 형식은 GeoTIFF, 밴드는 RGB 3개, 좌표계는 EPSG:32652, 픽셀 크기는 320m였다. EPSG:5187 프로젝트에서 보이더라도 래스터 자체의 좌표계는 EPSG:32652이므로 후속 분석에는 좌표계와 해상도를 구분해야 한다.

실제 QGIS 화면 3: GeoTIFF 레이어 속성과 격자 정보

그림 3. GeoTIFF 레이어 속성과 격자 정보(2026년 9월 30일 실제 QGIS 화면)

단계 4. 다른 날짜와 자산 키 확인

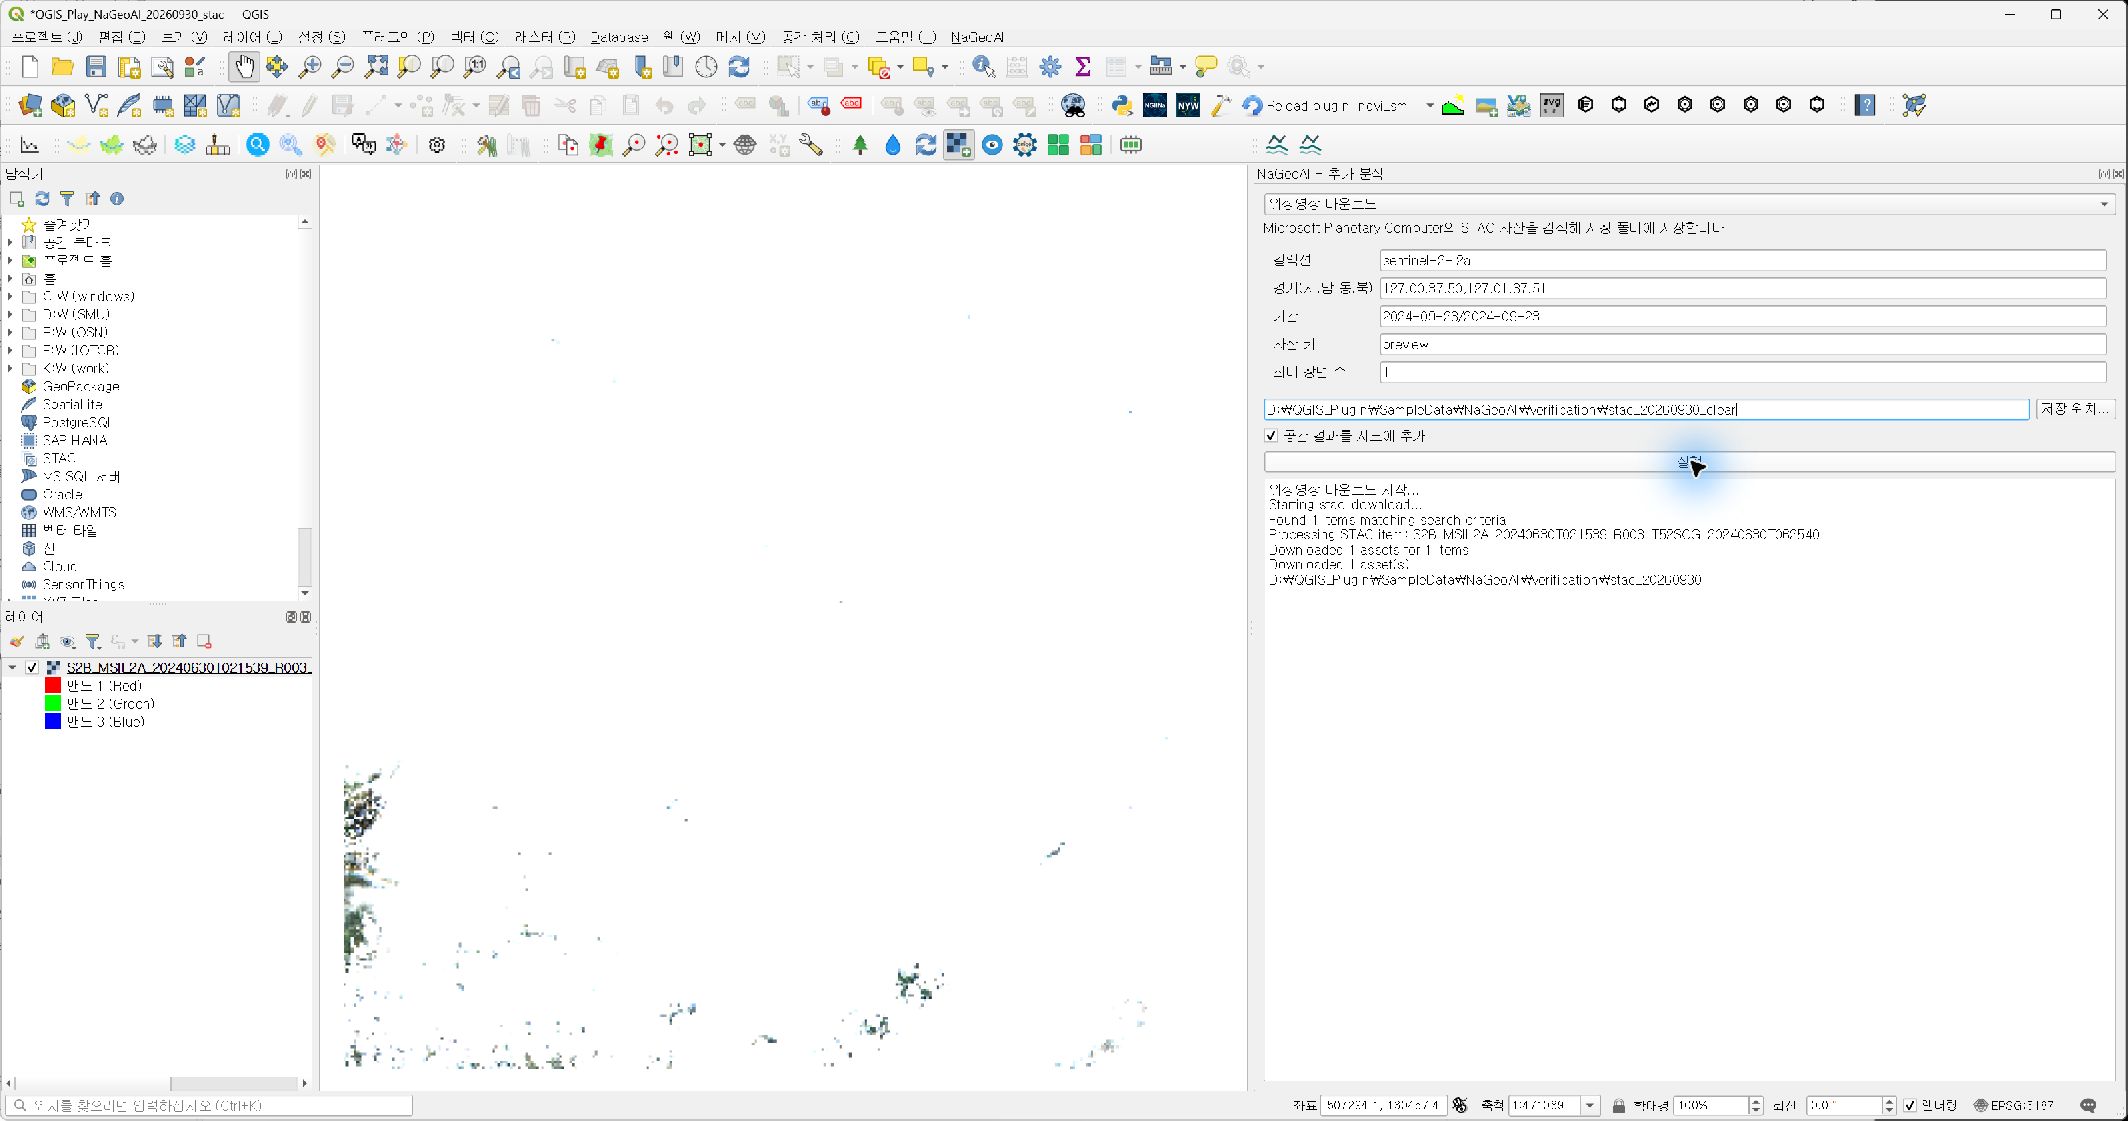
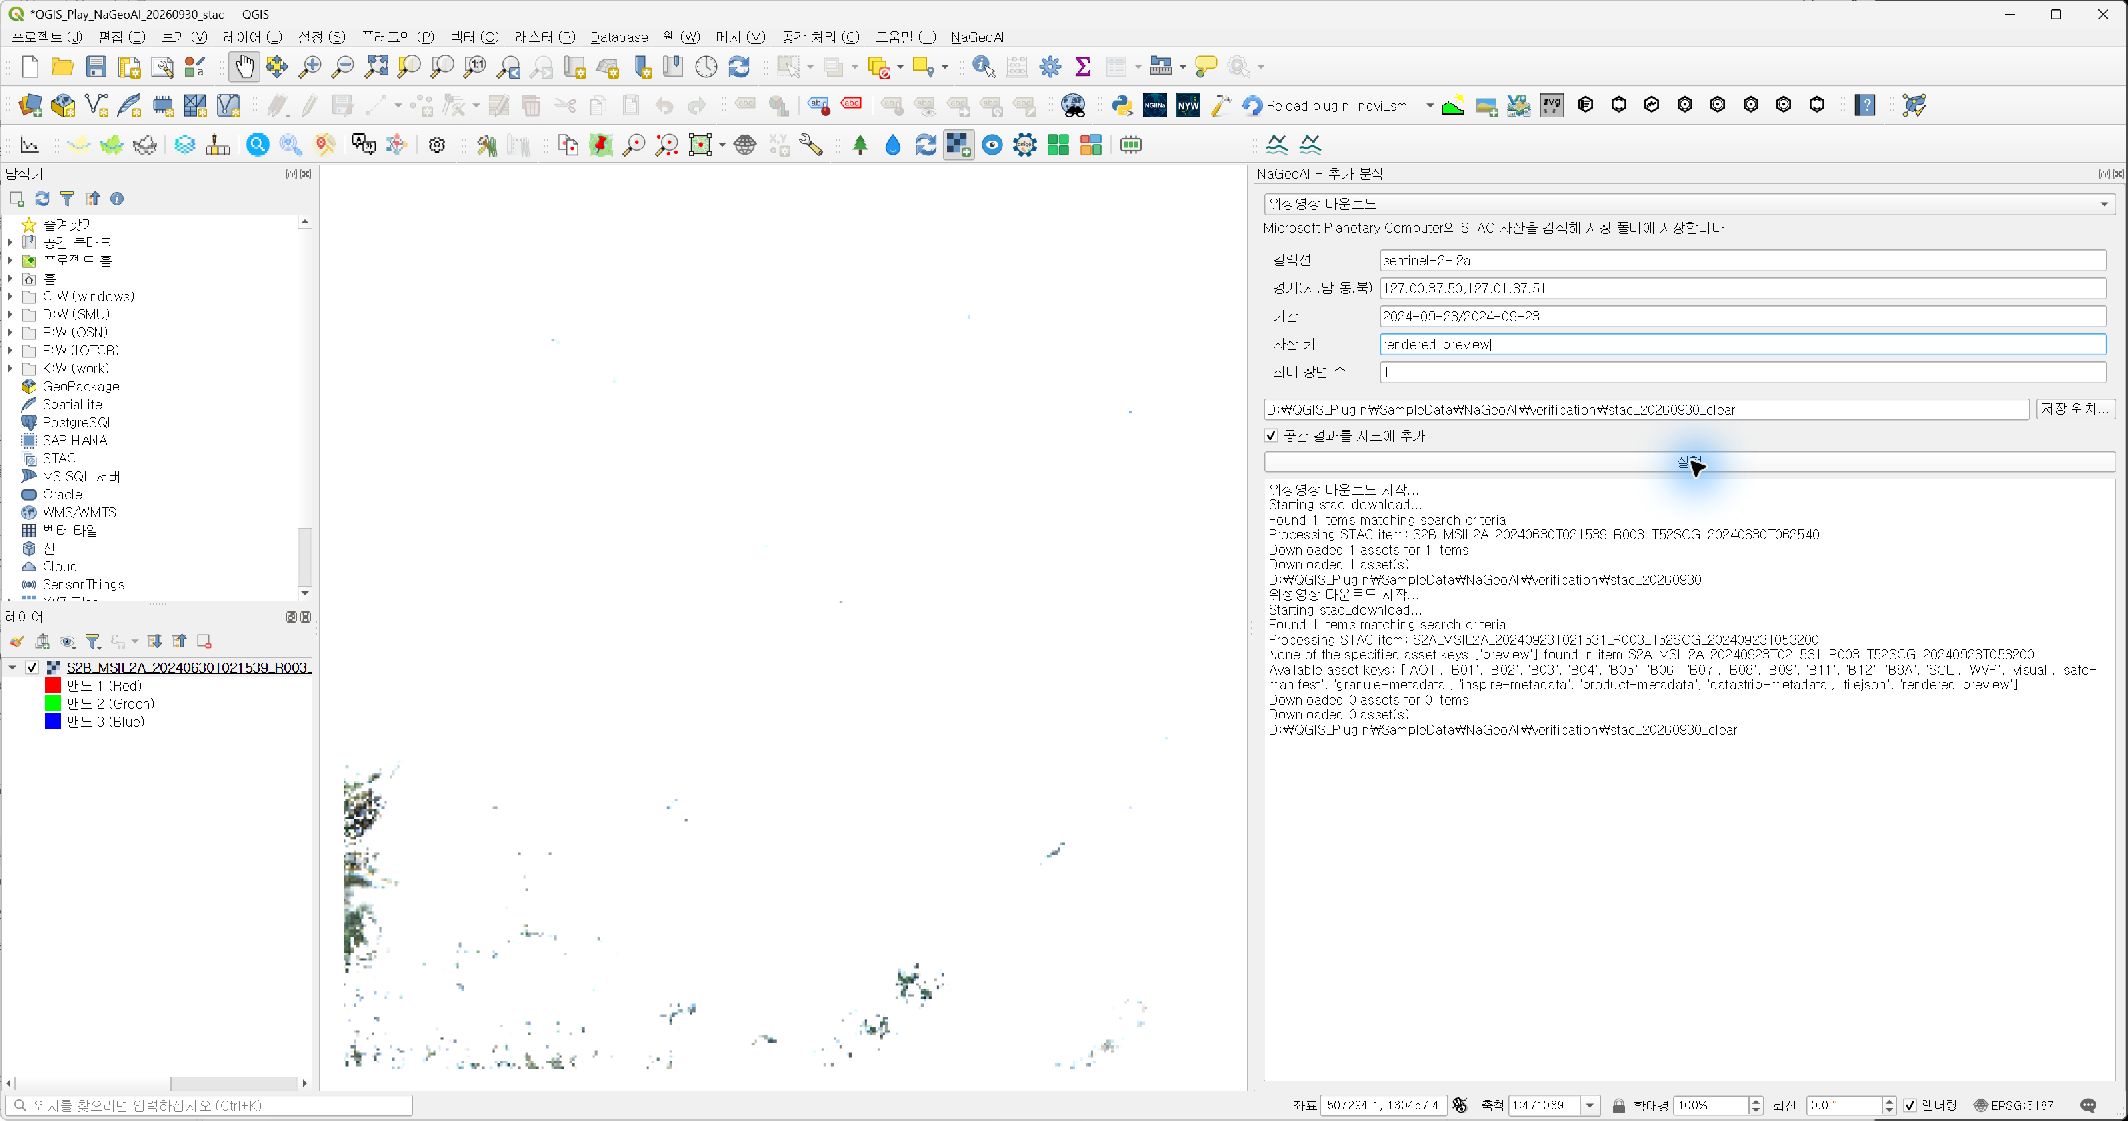
구름량이 더 낮은 항목을 확인하기 위해 기간을 2024-09-23/2024-09-23으로 변경하고 같은 검색 영역, 컬렉션, 최대 항목 수를 사용했다. 해당 항목 ID는 S2A_MSIL2A_20240923T021531_R003_T52SCG_20240923T053200, STAC 구름량은 0.42%였다. 다만 이 항목에는 preview 자산이 없어 실행 로그에 다운로드 0개가 기록되었다. 자산 키는 모든 항목에 동일하게 존재한다고 가정하면 안 된다.

실제 QGIS 화면 4: 낮은 구름량 장면 검색을 위한 날짜 변경

그림 4. 낮은 구름량 장면 검색을 위한 날짜 변경(2026년 9월 30일 실제 QGIS 화면)

실제 QGIS 화면 5: preview 자산이 없는 경우의 실행 로그

그림 5. preview 자산이 없는 경우의 실행 로그(2026년 9월 30일 실제 QGIS 화면)

단계 5. 사용 가능한 자산으로 다시 실행

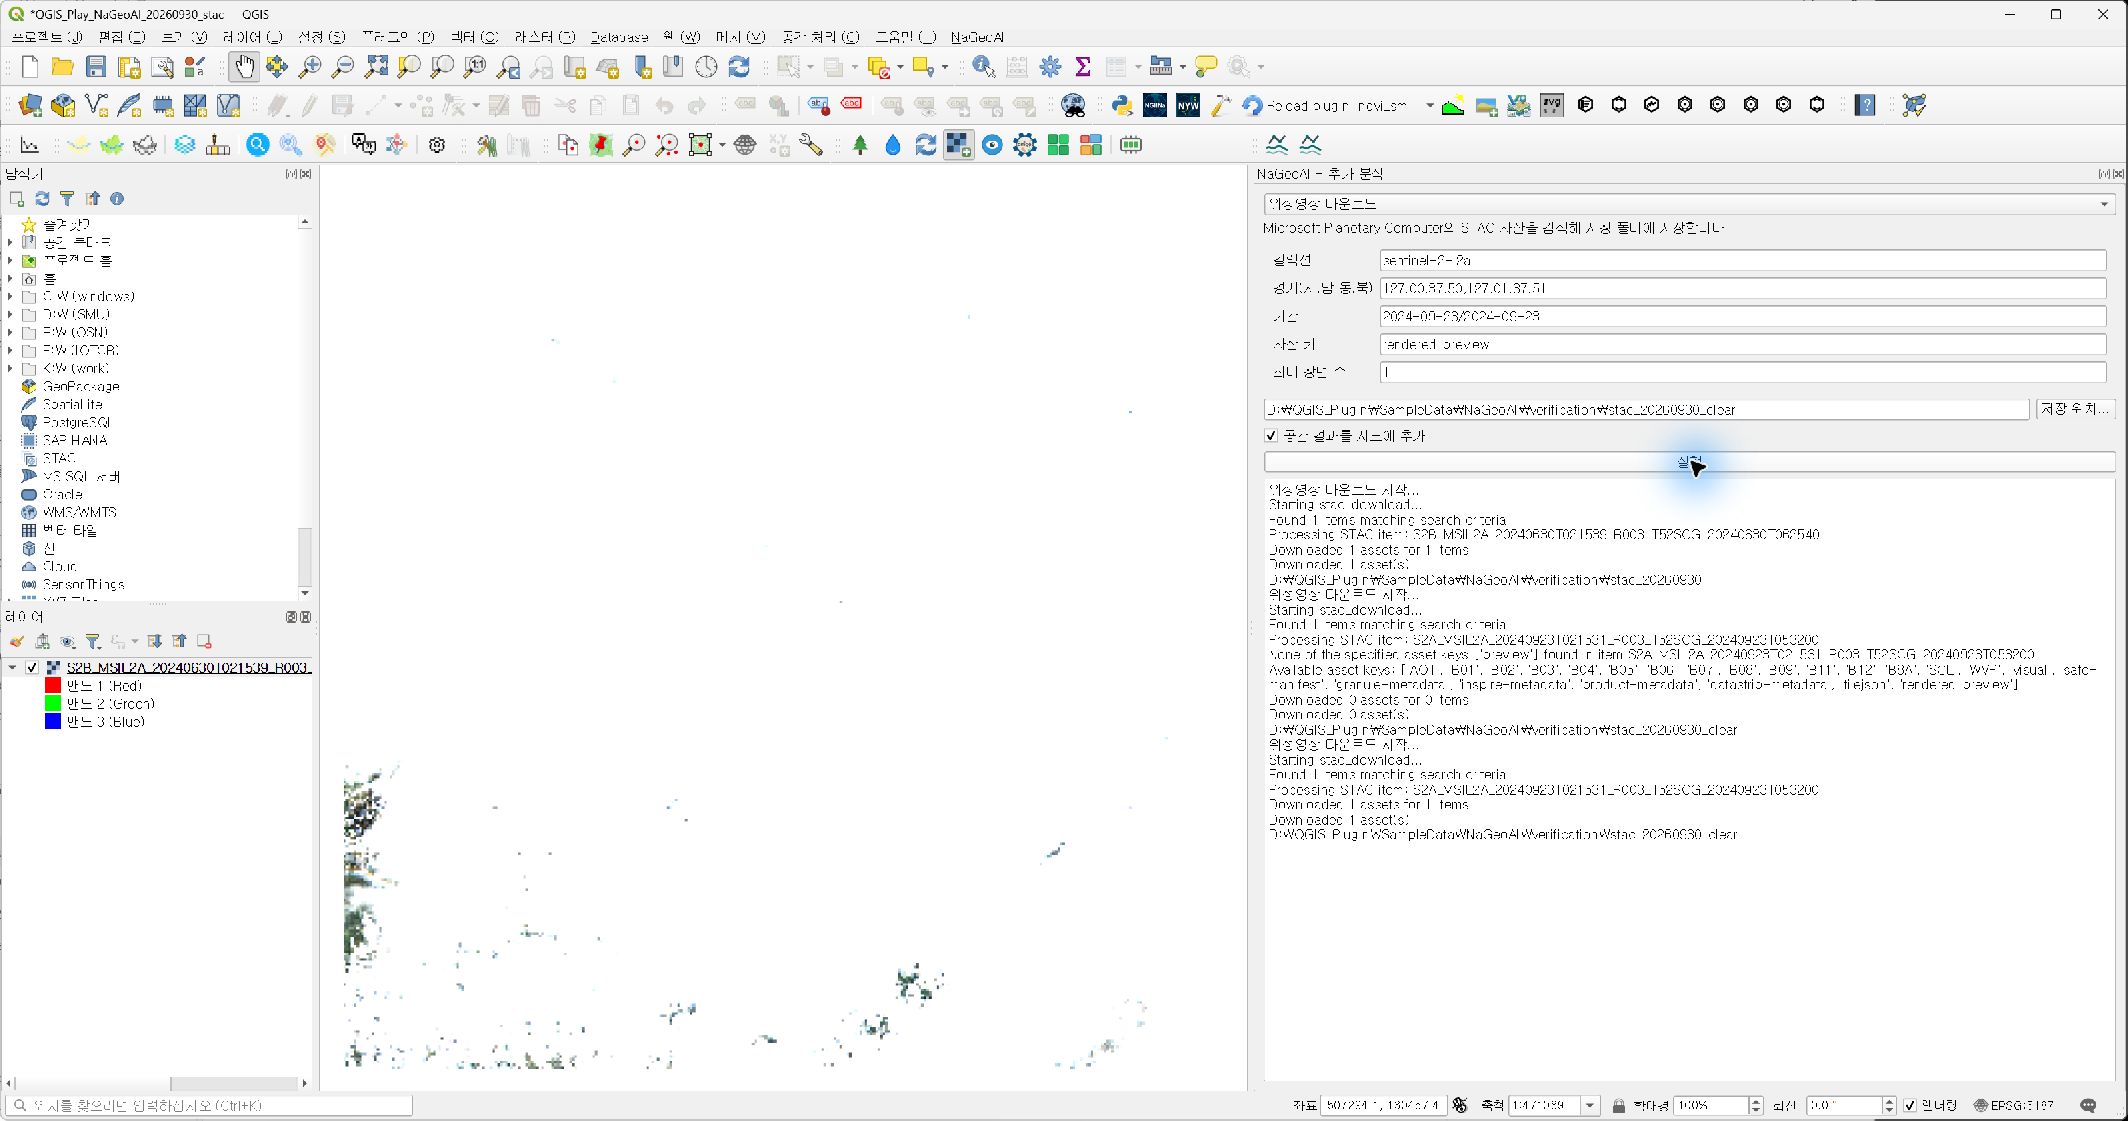
자산 키를 rendered_preview로 변경해 다시 실행한 결과, 로그에서 1개 자산 다운로드를 확인했다. 출력은 1024×1024픽셀, RGBA 4밴드 PNG였다. 파일에 공간 좌표계와 지오리퍼런스가 없으므로 시각 확인용 미리보기로만 사용한다. 공간 분석용 래스터라고 표시하지 않는다. 플러그인은 이 PNG를 QGIS 지도 레이어로 자동 추가하지 않았다.

실제 QGIS 화면 6: rendered_preview 다운로드 완료 로그

그림 6. rendered_preview 다운로드 완료 로그(2026년 9월 30일 실제 QGIS 화면)

결과와 주의사항

실제로 검증한 범위는 STAC 검색, 원격 자산 다운로드, QGIS 로그, 첫 GeoTIFF의 레이어 속성, 두 번째 PNG 파일의 형식 확인이다. 첫 장면은 구름이 매우 많고, 두 번째 결과는 좌표정보 없는 미리보기다. 분광 분석이나 정밀 위치 비교에는 각 항목의 지오리퍼런스가 있는 visual 또는 분광 밴드 자산을 별도로 선택·다운로드하고, 라이선스·좌표계·해상도·구름 마스크를 다시 확인할 필요가 있다. 오늘 그 후속 분석은 수행하지 않았다.

자료 출처: Microsoft Planetary Computer STAC 문서 및 Sentinel-2 카탈로그. Sentinel 자료의 이용 조건은 Copernicus Data Space 이용 조건도 확인한다. 서비스의 서명된 자산 URL과 인증 문자열은 글에 게시하지 않는다.

2026-09-29

AI 재난상황관리 시스템, 도시안전 정책이 바뀐다 | 재난안전과 GeoAI

AI 재난상황관리 시스템, 도시안전 정책이 바뀐다 | 재난안전과 GeoAI

🎬 1분 브리핑 영상

📌 3줄 요약

  • 한국전기안전공사가 2026년 9월 AI 재난상황관리 시스템 '케스코-사이렌'을 구축했다.
  • 서울에서 세계 도시 리더들이 모여 AI 시대 도시 안전 정책 해법을 논의했다.
  • Esri ArcGIS Living Atlas에 NOAA 홍수 침수 예측 지도가 새롭게 추가됐다.

안녕하세요! GeoAI와 생성형 AI가 재난안전·도시공간 정책의 핵심 도구로 자리를 잡아가는 요즘, 현장에서 체감할 수 있는 변화들이 속속 들어오고 있습니다. 오늘은 AI 기반 재난상황관리 시스템 구축 소식부터, 도시 안전 정책 포럼, ArcGIS 공간정보 플랫폼 업데이트, 원격탐사 역량 강화 세미나까지 폭넓게 정리해 드립니다.

특히 흩어진 재난정보를 한 곳에 통합해서 보여주는 AI 시스템이 공공기관에 실제로 도입됐다는 점, 그리고 세계 도시 리더들이 AI 시대 도시 안전을 주제로 머리를 맞댄다는 소식은 '재난안전'이 이제 단순한 현장 대응을 넘어 도시 설계와 정책 전반으로 확장되고 있음을 보여줍니다. 오늘 브리핑도 천천히 읽어 주세요.

🚨 AI로 재난정보를 한눈에 볼 수 있는 시스템이 생겼나요?

한국전기안전공사가 2026년 9월 29일 기준으로 AI 기반 재난상황관리 시스템인 '케스코-사이렌(KESCO-SIREN)'을 구축했다고 알려졌습니다. 이 시스템은 기존에 여러 경로로 흩어져 있던 재난 관련 정보를 하나의 플랫폼에서 통합 조회하고 관리할 수 있도록 설계된 것으로 보입니다. 전기안전 분야에 AI를 결합해 재난 상황을 실시간으로 감지하고 대응하는 역량을 높이겠다는 취지로 이해됩니다. 자세한 시스템 구성과 운영 방식은 원문을 참고하시기 바랍니다.

재난안전학적 관점에서 이 소식은 '통합 재난상황 모니터링(Integrated Emergency Monitoring)'이라는 개념이 공공기관 현장에 실제로 적용되기 시작했다는 점에서 주목할 만합니다. 학과에서 배우는 BCP(업무연속성계획)나 재난 초기 대응 체계는 정보 통합과 신속한 상황 판단이 핵심인데, 이처럼 AI가 정보 수집·분류를 자동화해 주면 담당자의 판단 부하가 크게 줄어들 것으로 보입니다. 충북·제천처럼 전기 인프라가 분산된 지역에서도 이런 시스템이 연계된다면 지역 재난 대응력 향상에 실질적인 기여를 할 수 있을 것이라고 생각합니다.

📰 기사 원문: 한국전기안전공사, AI 재난상황관리 시스템 '케스코-사이렌' 구축 - webeconomy.co.kr

🔗 흩어진 재난정보를 통합한다는 게 구체적으로 어떤 의미인가요?

같은 날 보도된 또 다른 기사에서도 한국전기안전공사의 '케스코-사이렌' 시스템 구축 소식을 다루고 있습니다. 이 매체에서는 "흩어진 재난정보를 한눈에" 볼 수 있다는 점을 강조하며, 기관 내 재난상황 대응의 가시성(visibility)을 높이는 것이 이 시스템의 핵심 목표임을 전하고 있습니다. 한국전기안전공사는 2026년 9월 해당 시스템을 구축 완료한 것으로 알려졌으며, 전기안전 분야의 AI 기반 재난관리 역량을 한 단계 끌어올린 사례로 평가받을 것으로 보입니다.

재난안전 분야에서 정보 통합은 오래전부터 '골든타임 확보'의 핵심 과제로 꼽혀 왔습니다. 다양한 센서·신고·기상 데이터가 각각 따로 존재하면 상황 판단이 늦어지는데, AI가 이를 실시간으로 분류·시각화해 준다면 초기 대응 속도가 눈에 띄게 개선될 수 있습니다. GeoAI 관점에서는 이런 통합 플랫폼에 공간정보(위치 기반)를 결합하면 재난 발생 위치, 피해 반경, 대피 경로까지 한 화면에서 의사결정을 지원하는 진정한 스마트 재난관리 체계로 발전할 수 있다고 봅니다.

📰 기사 원문: 흩어진 재난정보 한눈에… 전기안전公, 케스코사이렌 구축 - jjn.co.kr

🌏 세계 도시 리더들이 서울에서 AI 도시 안전을 논의한다고요?

2026년 9월 28일 보도에 따르면, 서울에 세계 각지의 도시 리더들이 모여 AI 시대의 도시 정책 해법을 모색하는 자리가 마련됐다고 알려졌습니다. 글로벌 도시들이 AI를 활용해 안전하고 지속가능한 도시를 만드는 방법을 공유하고, 서로의 정책 경험을 교류하는 장으로 서울이 선택된 것으로 보입니다. 행사의 구체적인 참여 도시 수나 세부 의제는 원문에서 확인하시기 바랍니다.

도시 안전 정책이 국제적 수준에서 논의된다는 사실은, 재난안전이 이제 지역 단위의 현장 대응을 넘어서 도시 설계·거버넌스 차원의 글로벌 의제가 됐음을 잘 보여줍니다. 공간정보 기술과 GeoAI가 도시 위험 분석, 취약 지구 식별, 대피 경로 최적화 등에 활발히 쓰이는 시대인 만큼, 이번 서울 포럼에서 어떤 정책 선언이나 공동 협력 방안이 나오는지 관심 있게 지켜볼 필요가 있습니다. 충북이나 제천 같은 지방 중소도시도 글로벌 스마트시티 정책 흐름에서 배울 점을 적극적으로 찾아야 할 것으로 보입니다.

📰 기사 원문: 서울에 모이는 세계 도시 리더들…AI 시대 도시정책 해법 찾는다 - 더글로벌기빙뉴스

🗺️ ArcGIS Living Atlas에 NOAA 홍수 침수 예측 지도가 추가됐나요?

2026년 9월 25일자 Esri ArcGIS 블로그에 따르면, 미국 해양대기청(NOAA)의 홍수 침수 예측 지도가 ArcGIS Living Atlas에 새롭게 추가됐다고 합니다. ArcGIS Living Atlas는 Esri가 운영하는 글로벌 공간정보 데이터 허브로, 누구나 접근해 분석에 활용할 수 있는 레이어를 모아 놓은 플랫폼으로 잘 알려져 있습니다. 이번 업데이트로 NOAA가 생산하는 홍수 범람 예측 데이터를 ArcGIS 환경에서 바로 불러와 시각화하고 분석에 활용할 수 있게 됐습니다. 자세한 레이어 구성이나 접근 방법은 원문 블로그를 참고하시기 바랍니다.

홍수 침수 예측 지도를 공간정보 플랫폼에서 실시간으로 활용할 수 있게 됐다는 것은 재해영향평가나 침수 위험 분석 실습에도 직접적인 의미를 가집니다. 학과 수업에서 GIS 기반 자연재해 위험도 분석을 공부할 때, 이런 공개 데이터 레이어를 활용하면 실제 침수 예측 시나리오를 만들어 볼 수 있는 좋은 실습 기회가 됩니다. 한국도 국가 수자원 관리 기관과 ArcGIS Living Atlas 수준의 공개 데이터 연계를 강화한다면, 지역별 침수 위험 예측의 정확도와 접근성이 크게 높아질 것이라고 봅니다.

📰 기사 원문: NOAA flood inundation prediction maps now in ArcGIS Living Atlas - Esri ArcGIS Blog

📡 원격탐사 역량을 키우는 세미나가 열렸다고요?

2026년 9월 25일을 전후해 '2026 원격탐사 역량 강화 세미나'가 개최됐다고 알려졌습니다. 원격탐사(Remote Sensing)는 위성·항공 이미지를 활용해 지표면 변화, 재해 피해 현황, 환경 모니터링 등을 수행하는 공간정보 핵심 기술로, 재난안전·국토관리·농업·기후 분야에서 폭넓게 활용됩니다. 이번 세미나에서 어떤 기술과 사례가 공유됐는지는 원문 블로그에서 더 자세히 확인할 수 있습니다.

원격탐사 기술은 GeoAI와 결합될 때 진가를 발휘합니다. 위성 이미지를 딥러닝 모델로 분석해 산사태 취약 지점을 미리 탐지하거나, 침수 지역 경계를 자동으로 추출하는 기술이 이미 국내외 연구·실무 현장에서 쓰이고 있습니다. 재난안전학을 공부하는 분이라면 원격탐사의 기초 개념(해상도, 밴드 조합, 변화탐지 등)을 익혀 두면 GeoAI 실무 역량과 직접 연결되니, 이런 세미나 정보를 꾸준히 챙겨보시기를 권합니다.

📰 기사 원문: 2026 원격탐사 역량 강화 세미나 - yuiverse (네이버블로그)

🧰 AI 재난관리 시스템과 GeoAI 공간정보 플랫폼, 이렇게 활용하세요

첫째, AI 재난상황관리 시스템의 핵심은 '정보 통합과 시각화'입니다. 케스코-사이렌처럼 여러 소스의 재난 데이터를 하나의 플랫폼으로 모으고, 그것을 공간정보와 연동해 지도 위에 표현하면 상황 판단 속도가 크게 향상됩니다. 재난안전 업무를 담당하거나 관심 있는 분이라면, 우리 기관·지역의 재난정보가 얼마나 통합되어 있는지 점검해 보는 것이 좋습니다.

둘째, ArcGIS Living Atlas처럼 공개된 글로벌 공간정보 데이터를 적극 활용하세요. NOAA 홍수 예측 지도처럼, 이미 검증된 공개 데이터를 분석에 바로 활용할 수 있다면 별도의 데이터 수집 없이도 재해영향평가나 위험도 분석의 질을 높일 수 있습니다. 학생이라면 ArcGIS Living Atlas에 무료로 접근해 실습 데이터로 활용해 볼 것을 권합니다.

셋째, 원격탐사와 GeoAI의 결합이 재난 대응의 '선제성'을 좌우합니다. 사후 대응 중심에서 벗어나 위성 이미지 분석으로 위험 징후를 조기에 포착하는 역량을 갖추는 것이 앞으로 재난안전 전문가에게 필수 역량이 될 것이므로, 관련 교육과 세미나에 지속적으로 참여하는 것이 중요합니다.

❓ 자주 묻는 질문

Q. 한국전기안전공사의 케스코-사이렌 시스템이 정확히 어떤 기능을 하나요?
A. 케스코-사이렌은 한국전기안전공사가 2026년 9월 구축한 AI 기반 재난상황관리 시스템으로, 기존에 분산되어 있던 재난 관련 정보를 하나의 플랫폼에서 통합 조회하고 관리할 수 있도록 설계된 것으로 알려져 있습니다. 세부 기능 구성은 원문 기사를 참고하시기 바랍니다.

Q. ArcGIS Living Atlas에 추가된 NOAA 홍수 침수 예측 지도는 누가 사용할 수 있나요?
A. ArcGIS Living Atlas는 Esri가 운영하는 글로벌 공간정보 데이터 허브로, ArcGIS 계정이 있는 사용자라면 누구나 NOAA 홍수 침수 예측 레이어를 불러와 분석에 활용할 수 있는 것으로 알려져 있습니다. 학생이나 연구자도 무료 혹은 교육용 계정으로 접근이 가능한 경우가 많으니 Esri 공식 블로그의 원문을 확인해 보시기 바랍니다.

Q. 원격탐사 역량 강화 세미나는 어디서 참여할 수 있나요?
A. 2026년에 개최된 원격탐사 역량 강화 세미나는 관련 블로그에서 소개된 것으로 알려졌으며, 구체적인 참여 방법이나 다음 일정은 원문 블로그나 주최 기관의 공지를 통해 확인하시는 것이 가장 정확합니다. 일반적으로 원격탐사 관련 세미나는 국토교통부, Esri Korea, 한국항공우주연구원 등에서 정기적으로 개최하니 관심 있는 분은 해당 기관의 홈페이지를 즐겨찾기에 추가해 두시길 권합니다.

오늘 소식들을 관통하는 흐름을 한 문장으로 정리하면, "AI와 공간정보 기술이 재난 대응의 사후 처리에서 선제적 예측·통합 관리 단계로 확실히 이동하는 흐름이 공공기관과 글로벌 플랫폼 양쪽에서 동시에 확인된 하루였습니다."

앞으로도 GeoAI·생성형AI·공간정보 분야의 재난안전 동향을 꾸준히 전해 드리겠습니다. 궁금한 점이나 다루어 줬으면 하는 주제가 있다면 댓글로 남겨 주세요. 감사합니다!


재난안전과 GeoAI 이야기를 더 보고 싶다면 아래 채널도 함께 보세요.

📌 바로가기
NaGeoAI 실제 QGIS 실습 2 | 2019·2022 NAIP 영상의 시계열 합성

본 실습에서는 동일 격자로 정합한 두 시기의 NAIP 항공영상을 NaGeoAI의 시계열 합성 기능으로 처리하고, 픽셀별 중앙값 합성영상을 QGIS에서 확인한다. 실제 실행 화면과 출력 파일을 함께 검증하였다.

1. 설치와 예제 파일 다운로드

  1. QGIS 3.44.12를 실행한다. NaGeoAI 1.9.0 ZIP을 내려받는다.
  2. QGIS에서 플러그인 → 플러그인 관리 및 설치 → ZIP에서 설치를 열어 ZIP을 선택하고, 설치 후 NaGeoAI → 추가 분석 메뉴가 나타나는지 확인한다. 설치 과정의 화면은 실습 1에 수록하였다. 이번 실습은 이미 설치된 플러그인을 사용했으며 ZIP 재설치 자체를 다시 검증한 것은 아니다.
  3. 2019년 예제 TIFF와 2022년 예제 TIFF를 내려받는다. 파일명은 각각 las_vegas_naip_2019_a.tif, las_vegas_naip_2022_a.tif이다. 제공 저장소는 Source Cooperative의 GeoAI 데이터셋이다.

원래 두 TIFF는 격자가 조금 다르다. 2022년 영상을 2019년 영상의 격자에 재표본화한 파생본이 필요하다. 이 PC에서는 앞선 실습에서 생성한 las_vegas_naip_2022_a_aligned_replay.tif을 사용했다. 해당 파일은 원본이 아닌 bilinear 정합 파생자료이며 블로그에서 재배포하지 않는다. NAIP 원자료의 배포·이용 정보는 미국 정부 자료 목록에서 확인할 수 있다. 원본 저장소의 개별 재배포 조건도 확인할 필요가 있다.

2. 입력 영상 검증

두 실습 입력은 모두 EPSG:26911, 4밴드, 2,721×1,420픽셀이며 픽셀 크기는 0.6m이다. 좌상단 좌표는 (649647.6, 4020075)로 같다. 각 파일의 gdalinfo -json 결과로 이 값을 비교했다. 시작 프로젝트 QGIS_Play.qgz의 CRS는 EPSG:5187이지만, 합성 계산은 동일한 두 입력 래스터 격자를 기준으로 수행한다. 프로젝트 원본은 보존하고 별도 복사본에서 작업했다.

3. QGIS에서 합성 실행

  1. QGIS에서 QGIS_Play.qgz를 열고 프로젝트 → 다른 이름으로 저장으로 실습용 복사본을 만든다.
  2. NaGeoAI → 추가 분석 패널을 열고 기능을 시계열 합성으로 설정한다.
  3. 입력 영상 목록에 2019년 TIFF와 정합된 2022년 TIFF를 한 줄에 하나씩 입력한다. 원본 2022년 TIFF를 정합 없이 바로 사용하지 않는다.
  4. 합성 방식은 median, 출력은 temporal_median_gui_20260929.tif로 지정한다. 공간 결과를 지도에 추가를 켠 다음 실행을 누른다.
  5. 로그의 입력 수, 밴드 수, 크기, 완료 메시지를 확인하고 출력 레이어를 지도에서 확인한다.
QGIS NaGeoAI 시계열 합성 입력값과 실행 로그 및 지도 결과
그림 1. 실제 QGIS의 NaGeoAI 시계열 합성 입력·로그·지도 결과. 클릭하면 원본 크기로 볼 수 있다.

4. 출력 검증과 해석 범위

QGIS 로그에는 Creating median composite from 2 scenes, 4 bands, 2721x1420 pixels, Valid observations: 7727640/7727640 (100.0%), Composite created from 2 rasters가 기록되었다. 출력 TIFF의 별도 검사에서도 EPSG:26911, 4밴드, 2,721×1,420픽셀, 0.6m 격자가 유지되었다. 출력은 QGIS 지도에 추가되어 영상 형태로 확인되었다.

QGIS에서 확인한 NAIP 중앙값 합성 영상
그림 2. QGIS 지도에서 확인한 중앙값 합성영상. 이 화면은 변화탐지도가 아니다.

두 장의 유효 관측값에 대한 중앙값은 두 값의 중간값이다. 따라서 이 결과는 시기 사이의 변화를 직접 표시하지 않으며, 두 시기의 피복 상태를 평균화할 수 있다. 촬영 시각·계절·태양고도·센서 차이와 정합 오차는 별도로 검토해야 한다. 분석에 사용하지 않은 배경지도 서비스의 연결 정보는 글과 화면에 포함하지 않았다.

2026-09-28

NaGeoAI 실제 QGIS 실습 1 | 설치부터 NAIP 변화탐지 결과 확인까지

실습 목적과 검증 범위

본 실습에서는 QGIS 3.44.12에서 NaGeoAI 1.9.0의 변화탐지를 실행하여 미국 라스베이거스 지역의 2019년·2022년 NAIP 예제 영상으로 이진 차분 마스크를 작성하였다. 아래 화면은 이번 작업에서 실제로 확인한 장면이다. 설치 ZIP 선택 화면은 재설치 완료 증거가 아니며, 이미 설치된 NaGeoAI의 실행과 분석 결과는 별도로 확인하였다.

1. NaGeoAI ZIP 내려받기와 설치 화면

NaGeoAI-1.9.0.zip 직접 다운로드 또는 GitHub 릴리스 페이지에서 배포본을 받는다. 배포 ZIP SHA-256은 479B508625839070AE952DF5A5E7CE04308A3971A81DF33B238F71AC4FCF9288이다. 설치 전 파일의 출처와 해시를 확인한다.

GitHub 릴리스에서 NaGeoAI 1.9.0 ZIP 다운로드 위치 확인
그림 1. GitHub 릴리스에서 NaGeoAI 1.9.0 ZIP 다운로드 위치 확인

QGIS에서 플러그인 → 플러그인 관리 및 설치 → ZIP에서 설치를 열고 내려받은 ZIP을 지정한다. 새로 설치하는 경우 설치 단추를 누른 뒤 QGIS를 다시 시작하고 NaGeoAI → 변화탐지 메뉴 또는 도구 모음이 나타나는지 확인한다. 이번 컴퓨터는 이미 1.9.0이 설치된 상태였으며, 재설치 단추는 누르지 않았다. 플러그인 관리자가 응답하지 않는 현상이 있어 그 단계의 완료 화면은 제시하지 않는다.

QGIS 플러그인 관리자의 ZIP에서 설치 탭에 배포본을 지정한 화면
그림 2. QGIS 플러그인 관리자의 ZIP에서 설치 탭에 배포본을 지정한 화면

2. 예제 영상 준비

예제는 Source Cooperative의 opengeos/geoai 공개 페이지에 있는 두 NAIP GeoTIFF다. 2019 영상 직접 다운로드와 2022 영상 직접 다운로드를 각각 받는다. 자료를 재배포하지 않고 원본 페이지로 연결한다. 이용 조건은 실제 활용 전에 자료 제공처에서 다시 확인한다.

Source Cooperative의 2019년 NAIP 예제 파일 화면
그림 3. Source Cooperative의 2019년 NAIP 예제 파일 화면
Source Cooperative의 2022년 NAIP 예제 파일 화면
그림 4. Source Cooperative의 2022년 NAIP 예제 파일 화면

두 영상은 모두 EPSG:26911, 2721×1420픽셀, 0.6m 픽셀 크기다. 그러나 2022 영상의 격자 원점은 2019 영상과 일치하지 않는다. 2019 영상의 범위 649647.6 4019223 651280.2 4020075와 크기 2721×1420을 기준으로 GDAL gdalwarp의 bilinear 재표본화를 적용해 2022 영상 사본을 정합하였다. 이는 QGIS에 포함된 GDAL 명령으로 수행한 전처리이며, QGIS의 ‘래스터 정렬’ GUI를 실행 완료했다고 주장하지 않는다. 원본 TIFF는 보존하였다. 작업 폴더가 영상이 있는 위치일 때의 재현 명령은 다음과 같다.

gdalwarp -of GTiff -co TILED=YES -co COMPRESS=LZW -s_srs EPSG:26911 -t_srs EPSG:26911 -te 649647.6 4019223 651280.2 4020075 -ts 2721 1420 -r bilinear las_vegas_naip_2022_a.tif verification/las_vegas_naip_2022_a_aligned_replay.tif

3. QGIS 프로젝트 사본과 입력 영상 확인

기존 QGIS_Play.qgz를 열고 프로젝트 → 다른 이름으로 저장으로 QGIS_Play_NaGeoAI_20260928_replay.qgz 사본을 만들었다. 현재 원본 프로젝트는 EPSG:5187의 빈 레이어 상태로 열렸으므로, 예제 분석은 복사 프로젝트에 새 레이어를 추가하여 수행하였다. 저장된 프로젝트 좌표계와 분석 자료 좌표계는 구별해야 한다.

원본을 덮어쓰지 않고 만든 QGIS 실습 프로젝트 사본
그림 5. 원본을 덮어쓰지 않고 만든 QGIS 실습 프로젝트 사본
QGIS에 불러온 2019년·2022년 원본 NAIP 래스터
그림 6. QGIS에 불러온 2019년·2022년 원본 NAIP 래스터

4. NaGeoAI 변화탐지 실행

QGIS 도구 모음의 변화탐지를 열어 이전 영상은 2019 원본, 이후 영상은 앞서 정합한 2022 사본으로 지정하였다. 분석 밴드는 1(Red), 방식은 절대 차분(원본 픽셀값), 임계값은 20, 출력은 새 GeoTIFF change_mask_gui_replay_20260928.tif로 지정하고 변화탐지 실행을 눌렀다.

NaGeoAI 변화탐지 패널의 이전·이후 영상 및 임계값 설정
그림 7. NaGeoAI 변화탐지 패널의 이전·이후 영상 및 임계값 설정

실제 QGIS 실행 로그에는 “유효 픽셀 3,861,099개 중 변화 2,165,338개 (56.08%)”가 표시되었다. 출력 래스터는 2721×1420픽셀, EPSG:26911, 0.6m 격자이며 0·1 이진값과 NoData 255를 가진다. 화면의 흰색은 설정 임계값을 넘은 후보 픽셀이다.

QGIS 지도에 추가된 변화 마스크와 NaGeoAI 완료 로그
그림 8. QGIS 지도에 추가된 변화 마스크와 NaGeoAI 완료 로그

결과 해석 시 주의사항

56.08%는 적색 밴드의 밝기 차이가 20을 초과한 유효 픽셀 비율이다. 실제 토지피복 변화율·피해면적·분류 정확도가 아니다. 촬영 시기, 조명, 색조, 재표본화와 정합 오차가 결과에 영향을 줄 수 있다. 현장 기준자료나 혼동행렬에 의한 정확도 검증은 이번 실습에서 수행하지 않았다. 모델 기반 기능에 필요한 PyTorch·OpenSR 모델 설치 여부 역시 본 변화탐지 결과만으로 확인할 수 없다.

생성형 AI 사용법 4 | 이미지 생성과 저작권 주의점

생성형 AI 사용법 4 | 이미지 생성과 저작권 주의점

📌 3줄 요약

  • 이미지 생성 AI는 개념 설명용 삽화엔 유용하지만 지도·통계 시각화엔 쓰면 안 된다.
  • 생성된 이미지는 실존 인물·건물·로고가 섞일 수 있어 출처 표기와 검토가 필수다.
  • 저작권·초상권 위험을 줄이려면 생성 전 프롬프트, 생성 후 사용 맥락을 모두 점검해야 한다.

재난안전 업무를 하다 보면 발표 자료나 교육 슬라이드에 넣을 이미지가 늘 부족합니다. 홍수 현장 사진은 저작권이 걸려 있고, 직접 찍은 사진은 화질이 아쉽고, 무료 스톡 이미지는 딱 맞는 장면을 찾기 어렵습니다. 그때 이미지 생성 AI를 쓰면 금방 그럴싸한 그림이 나와서 편리하게 느껴집니다.

그런데 막상 써보면 "이 이미지를 공식 자료에 넣어도 되나?", "지도처럼 생긴 그림을 AI가 만들어 줬는데 정보가 맞나?" 하는 의문이 생깁니다. 이번 글에서는 이미지 생성 AI의 기본 흐름을 살펴보고, 재난안전 실무 자료에 쓸 때 반드시 알아야 할 한계와 주의점을 정리합니다. 지난 편에서 다룬 환각(hallucination) 문제가 텍스트에만 국한되지 않는다는 것, 이미지에서도 똑같이 나타난다는 점이 이번 글의 출발점입니다.

🖼️ 이미지 생성 AI는 어떤 순서로 쓰는 건가요?

이미지 생성 AI는 사용자가 문장(프롬프트)을 입력하면 그 문장에서 단어와 맥락을 읽어 픽셀 단위의 이미지를 만들어 내는 도구입니다. 작동 원리는 수억 장의 이미지-텍스트 쌍을 학습해 "이런 단어가 들어오면 이런 시각 패턴이 어울린다"는 연결을 내부에 쌓아둔 것입니다. 마치 미술학원 선생님이 수천 장의 그림을 보고 나서 "폭우 속 도시"를 그려 달라 하면 빗줄기, 젖은 도로, 어두운 하늘을 함께 구성하는 것과 비슷합니다.

사용 흐름은 대체로 이렇습니다. 도구에 접속해 새 생성 창을 열고, 영어 또는 한국어로 원하는 장면을 구체적으로 묘사한 프롬프트를 입력합니다. 스타일(사진 느낌인지, 일러스트인지), 시점(위에서 내려다보는지, 사람 눈높이인지), 분위기(주간·야간·흐림)를 함께 쓸수록 의도에 가까운 결과가 나옵니다. 생성된 이미지 중 마음에 드는 것을 내려받고, 쓰임에 맞는지 검토한 뒤 자료에 삽입합니다. 재난안전 교육 슬라이드에서 "대피 행동 요령"을 시각화할 때 삽화 스타일 이미지를 빠르게 얻는 용도로 활용할 수 있습니다.

🚫 지도나 통계 그래프를 AI에게 그리게 해도 되나요?

결론부터 말하면, 지도·통계 그래프·수치가 들어간 도표를 이미지 생성 AI로 만드는 것은 실무 자료에 쓰기 매우 위험합니다. 이미지 생성 AI는 '그럴싸하게 보이는 시각 패턴'을 만들도록 학습되었을 뿐, 지리적 좌표나 실측 수치를 내부에 갖고 있지 않습니다. 생성된 지도 이미지에 나오는 행정경계선, 도로망, 강의 위치는 학습 이미지에서 가져온 패턴이지 실제 공간 정보가 아닙니다.

예를 들어 "경상남도 산사태 위험 지역 지도"를 프롬프트로 넣으면 지도처럼 생긴 이미지가 나옵니다. 그러나 거기 표시된 위험 구역은 완전히 지어낸 위치이고, 보는 사람은 그것을 실제 자료로 오해할 수 있습니다. 통계 막대 그래프도 마찬가지로 숫자가 맞지 않습니다. 지도와 통계 시각화는 반드시 QGIS, Google Earth Engine, 공공 데이터 포털의 검증된 데이터로 직접 만들어야 합니다. 홍수 피해 현황 지도를 AI가 그린 이미지로 대체했다가 잘못된 위치 정보가 보고서에 들어가면 의사결정 오류로 이어질 수 있습니다.

⚖️ 생성된 이미지의 저작권은 누구에게 있나요?

이미지 생성 AI로 만든 결과물의 저작권은 나라마다 판단 기준이 다르고, 도구를 제공하는 서비스의 이용 약관에 따라서도 달라집니다. 현재 여러 나라에서 논의가 진행 중이므로, "내가 프롬프트를 썼으니 내 것"이라고 단정하기 어렵습니다. 중요한 것은 두 가지입니다. 첫째, 사용하려는 도구의 이용 약관에서 생성물의 상업적 사용 허용 여부와 출처 표기 의무를 직접 확인해야 합니다. 약관은 서비스가 업데이트될 때마다 바뀔 수 있으므로, 중요한 공공 자료를 만들 때는 사용 시점 기준으로 다시 읽어두는 것이 안전합니다.

둘째, 생성된 이미지가 학습 데이터에 포함된 특정 작가의 화풍을 그대로 재현하거나, 실존하는 유명 사진과 유사한 구도로 나올 수 있습니다. 이럴 때는 원본 저작물 침해 논란이 생길 수 있습니다. 재난안전 기관의 공식 홍보물이나 보도 자료에 사용할 때는 법무 담당자 또는 기관의 저작권 지침을 먼저 확인하는 절차가 필요합니다.

👤 실존 인물이나 실제 장소가 나올 때 어떻게 판단하나요?

이것이 '해봐야 아는 것' 영역입니다. 프롬프트에 특정 인물 이름이나 실제 건물·장소 이름을 쓰지 않더라도, 생성된 이미지에 실존하는 사람의 얼굴과 유사한 인물이 등장하거나 특정 기관의 건물·로고와 닮은 요소가 섞여 나오는 경우가 있습니다. 이를 직접 확인하는 절차는 다음과 같습니다. 생성된 이미지를 눈으로 먼저 살피고, 인물이 포함되어 있다면 역이미지 검색(Google 이미지 검색 또는 유사 서비스에서 이미지를 업로드해 검색)을 해서 실존 인물 사진과 유사한지 확인합니다. 건물이나 로고가 나왔다면 유사성을 직접 비교합니다. 유사도가 높다고 판단되면 해당 이미지는 쓰지 않고 프롬프트를 바꿔 다시 생성하는 것이 안전합니다.

초상권은 살아있는 사람뿐 아니라 일부 나라에서는 사망한 공인에게도 인정될 수 있습니다. 재난 상황을 묘사하는 이미지에서 피해자처럼 보이는 인물이 특정인을 닮았다면 명예훼손이나 초상권 문제로 번질 수 있습니다. 산불 대피 훈련 홍보 포스터에 생성 이미지를 넣을 때도 동일한 기준으로 점검해야 합니다.

📋 생성 이미지를 자료에 넣을 때 어떻게 표기하나요?

생성형 AI 이미지를 공식 자료나 교육 자료에 사용할 때는 출처 표기 방식을 미리 정해두는 것이 좋습니다. 일반적으로는 이미지 아래 또는 자료 말미에 "AI 생성 이미지(사용 도구명, 생성 연월)" 형식으로 표기합니다. 여기서 사용 도구명은 자신이 실제로 쓴 서비스 이름을 그대로 씁니다. 이렇게 하면 자료를 보는 사람이 해당 이미지가 실제 현장 사진이 아니라는 점을 알 수 있고, 정보 오독을 막을 수 있습니다.

기관 내부 지침이나 보고서 작성 기준에 따라 AI 생성물 사용 자체가 제한될 수 있으므로, 처음 쓰기 전에 소속 기관의 관련 지침을 확인하는 것이 순서입니다. 표기 없이 사진처럼 제시하는 것은 정보 윤리 측면에서 문제가 됩니다. 대피 경로 안내 리플릿이나 재난 대응 매뉴얼 같은 신뢰도가 중요한 자료일수록 표기를 명확히 해야 합니다.

🖥️ 화면에서 따라하기

따라하기 단계

  1. 새 생성 창 열기
    사용하는 이미지 생성 AI 도구에 로그인 후 새 이미지 생성 또는 Create 버튼 클릭
  2. 프롬프트 입력
    텍스트 입력란에 장면·스타일·시점·분위기를 포함한 구체적 문장 입력 (예: "aerial view of a flooded residential area, illustration style, daytime")
  3. 이미지 생성
    Generate 또는 이미지 생성 버튼 클릭 후 결과 이미지 4컷 내외 확인
  4. 인물·건물 점검
    생성된 이미지를 구글 이미지 검색 창에 드래그하거나 '이미지로 검색' 클릭해 실존 인물·건물 유사 여부 확인
  5. 이미지 저장
    문제 없으면 Download 또는 저장 버튼으로 파일 내려받기 (도구마다 메뉴 위치가 다를 수 있으며, 못 찾을 때는 도구 공식 도움말에서 'download' 또는 '내려받기' 검색)
  6. 출처 표기
    자료에 삽입 후 이미지 하단에 "AI 생성 이미지([도구명], [생성 연월])" 문구 추가

※ 프로그램 버전에 따라 메뉴 이름이 조금씩 다를 수 있습니다. 위 그림은 순서를 정리한 도식입니다.

✍️ 그대로 복사해 쓰는 프롬프트

재난안전 교육 슬라이드용 삽화 프롬프트를 구체적 맥락 없이 막연하게 쓸 때와 맥락을 갖춰 쓸 때를 비교해 더 나은 결과를 얻기 위한 참고용

[막연한 요청 예시 — 결과 품질이 낮은 이유를 확인하려는 목적]
홍수 그림 그려줘.

[맥락을 갖춘 요청 예시 — 실제로 사용할 때 이 형태로 쓴다]
너는 재난안전 교육 자료를 위한 삽화를 만드는 역할이야.
다음 조건에 맞는 이미지 프롬프트(영어)를 작성해줘. 내가 이미지 생성 AI 도구에 직접 붙여 넣을 거야.
장면: [홍수로 침수된 주택가, 주민이 대피 가방을 들고 이동하는 모습]
스타일: 실사 사진이 아닌 깔끔한 디지털 일러스트레이션
시점: 사람 눈높이
인물: 특정 인종·성별을 연상시키지 않는 중립적 실루엣
포함하지 말 것: 실존 건물 로고, 특정 인물 얼굴, 지명이 적힌 간판
결과 형식: 이미지 생성 AI에 바로 쓸 수 있는 영어 프롬프트 1개, 한국어 설명 1~2줄

※ 대괄호 부분을 상황에 맞게 바꿔서 쓰세요. 받은 답은 그대로 쓰지 말고 사실 확인을 거치세요.

🧪 직접 해보기

  • 이미지 생성 AI 도구에서 "홍수 피해 현장 지도" 같은 지도형 프롬프트를 입력해 결과가 실제 지리 정보와 얼마나 다른지 직접 눈으로 확인해 본다.
  • 생성된 이미지를 구글 이미지 검색의 '이미지로 검색' 기능에 업로드해 실존 인물·사진과 얼마나 유사한지 비교해 보고, 유사 결과가 나오는지 확인한다.
  • 자신이 사용하려는 이미지 생성 AI 도구의 이용 약관 페이지에서 '상업적 사용', '저작권', '출력물 소유권' 항목을 찾아 현재 기준을 직접 읽어본다.

❓ 자주 묻는 질문

Q. AI가 만든 이미지를 공공기관 보고서에 써도 되나요?
A. 기관마다 내부 지침이 다르고, 도구별 이용 약관도 다르므로 일률적으로 답하기 어렵습니다. 먼저 소속 기관의 저작물·AI 활용 지침을 확인하고, 사용 도구의 약관에서 공공·상업적 사용 허용 여부를 직접 읽어본 뒤 결정하는 것이 안전합니다.

Q. 프롬프트에 특정 인물 이름을 쓰지 않으면 초상권 문제가 없나요?
A. 이름을 쓰지 않아도 생성된 이미지가 실존 인물을 닮은 얼굴로 나오는 경우가 있습니다. 결과물을 역이미지 검색으로 직접 확인하고, 유사성이 높다고 판단되면 사용하지 않는 편이 안전합니다.

Q. AI 이미지에 출처를 어떻게 표기해야 하나요?
A. 정해진 국제 표준은 아직 명확하지 않지만, "AI 생성 이미지(사용 도구명, 생성 연월)" 형식을 이미지 아래나 자료 말미에 적는 방식이 일반적으로 쓰입니다. 기관 내부 가이드라인이 있다면 그것을 따르는 것이 우선입니다.

이미지 생성 AI는 개념 설명용 삽화나 분위기 묘사 이미지를 빠르게 얻는 데 유용한 도구입니다. 하지만 지도, 통계 그래프, 수치 정보처럼 정확성이 생명인 시각 자료를 대체할 수 없고, 저작권·초상권 문제는 생성 전과 생성 후 두 단계에서 모두 점검해야 합니다. 무엇보다 AI가 만든 이미지라는 사실을 자료에 명시하는 것이 정보 신뢰를 지키는 기본입니다. 재난안전 실무에서 시각 자료의 신뢰성은 곧 현장 대응 판단의 신뢰성과 연결됩니다. 다음 편에서는 이미지가 아닌 표·서식 같은 구조화된 자료를 생성형 AI로 만들 때 어떤 방식이 효과적이고 어디서 오류가 자주 생기는지를 살펴볼 예정입니다.

생성형AI 사용법 시리즈 4편 · 전체 15편


재난안전과 GeoAI 이야기를 더 보고 싶다면 아래 채널도 함께 보세요.

📌 바로가기
산사태 위험지도는 어떻게 만드나 | 취약성 모델링 | GeoAI 기초 13편

산사태 위험지도는 어떻게 만드나 | 취약성 모델링 | GeoAI 기초 13편

🎬 1분 브리핑 영상

📌 3줄 요약

  • 경사·지질·강우 등 공간 인자를 조합해 산사태 취약성 지도를 만든다.
  • 통계 모델과 머신러닝 모델은 원리가 다르지만 목표는 같다.
  • 위험지도의 숫자는 확률이지 예언이 아니므로 해석에 주의가 필요하다.

장마철이 끝나고 뉴스에 "이 지역은 산사태 위험 1등급"이라는 자막이 뜹니다. 그 숫자는 어디서 나온 걸까요? 누군가가 산을 직접 걸어 다니며 위험도를 매긴 것은 아닙니다. 경사각, 지질 특성, 과거 강우 기록, 토지피복 정보 같은 여러 공간 데이터를 모아 모델에 넣고 계산한 결과입니다.

산사태 위험지도를 만드는 과정을 취약성 모델링이라고 합니다. 취약성(vulnerability)이란 어떤 조건에서 재난이 발생하기 쉬운 정도를 수치로 표현한 것입니다. 이 모델이 어떻게 만들어지고, 지도를 읽을 때 무엇을 조심해야 하는지 차근차근 살펴보겠습니다.

🏔️ 산사태 위험지도를 만들 때 어떤 데이터가 필요한가요?

취약성 모델링의 첫 단계는 입력 인자를 고르는 일입니다. 입력 인자란 산사태 발생과 관련이 있다고 알려진 지형·지질·기상 정보를 말합니다. 가장 기본이 되는 것은 경사각입니다. 경사가 가파를수록 중력 방향으로 토양이 미끄러지기 쉽습니다. 여기에 경사 방향(사면향), 곡률(지표면이 오목한지 볼록한지)도 함께 씁니다.

지질 정보도 중요합니다. 같은 경사라도 암석이 풍화된 정도, 점토 함량, 투수성에 따라 물이 스며드는 속도가 달라집니다. 강우 자료는 누적 강우량과 시간당 강도를 모두 고려합니다. 토지피복(숲, 나지, 논밭 등)은 뿌리가 토양을 붙잡는 효과를 반영합니다. 이 밖에 도로 절개지나 계곡 거리 같은 인위적 요소도 포함할 수 있습니다. 실무에서는 각 기관이 보유한 수치 표고 모델(DEM)과 지질도, 기상 관측 데이터를 GIS에서 같은 격자 크기로 정렬하는 작업부터 시작합니다.

📊 통계 모델로 취약성을 계산하면 어떤 원리인가요?

통계 기반 모델의 대표적인 방식은 로지스틱 회귀(logistic regression)입니다. 회귀라는 이름이 낯설어도 개념은 단순합니다. 과거에 산사태가 났던 지점과 나지 않은 지점을 비교해서, 어떤 인자 조합이 산사태와 얼마나 함께 나타났는지 수치로 정리하는 것입니다. 결과는 0과 1 사이의 값, 즉 발생 가능성으로 표현됩니다.

비슷한 원리의 도구로 빈도비(frequency ratio) 방법이 있습니다. 전체 지역에서 특정 경사 범위가 차지하는 면적 대비 그 범위에서 실제 산사태가 일어난 비율을 계산해 가중치를 매기는 방식입니다. 계산이 투명해서 결과를 설명하기 쉽다는 장점이 있습니다. 재난안전 담당자가 지방자치단체에 위험 등급을 설명할 때, 어떤 인자가 얼마나 기여했는지 보여 줄 수 있어 실무에서도 많이 활용됩니다.

🤖 머신러닝 모델은 통계 모델과 무엇이 다른가요?

머신러닝 모델은 인자 간의 비선형 관계를 스스로 찾아냅니다. 예를 들어 랜덤 포레스트(random forest)는 수백 개의 결정 트리를 만들고 투표로 결과를 냅니다. 결정 트리는 "경사 30도 이상이면서 점토 함량이 높으면 위험"처럼 조건을 나무 가지처럼 분기하는 구조입니다. 여러 트리의 의견을 합치니 한 트리가 과적합되는 문제를 줄일 수 있습니다.

모델을 직접 써보고 싶다면 파이썬의 scikit-learn 라이브러리로 시작할 수 있습니다.

from sklearn.ensemble import RandomForestClassifier
from sklearn.model_selection import train_test_split
from sklearn.metrics import roc_auc_score

X_train, X_test, y_train, y_test = train_test_split(
    features, labels, test_size=0.2, random_state=42
)
model = RandomForestClassifier(n_estimators=100, random_state=42)
model.fit(X_train, y_train)
print("AUC:", roc_auc_score(y_test, model.predict_proba(X_test)[:,1]))

AUC(수신자 조작 특성 곡선 아래 면적)는 모델이 산사태 발생 지점과 미발생 지점을 얼마나 잘 구분하는지 보여주는 지표입니다. 1에 가까울수록 구분 능력이 높습니다. 실무 적용 전에 검증 데이터로 반드시 이 값을 확인해야 합니다.

🗺️ 완성된 위험지도, 어떻게 읽어야 하나요?

취약성 지도는 격자(픽셀) 또는 소유역 단위로 색깔을 달리해 등급을 표시합니다. '매우 높음'으로 표시된 구역은 과거 발생 패턴과 입력 인자를 종합했을 때 상대적으로 위험도가 높다는 뜻입니다. 반드시 기억해야 할 점은 이 값이 확률이지 예언이 아니라는 것입니다. 위험도가 낮은 구역에서도 예상치 못한 강우나 지형 변화로 산사태가 발생할 수 있고, 높은 구역이라고 해서 반드시 이번 장마에 무너진다는 뜻이 아닙니다.

해봐야 아는 것도 있습니다. 모델이 출력한 지도를 현장 사진이나 최근 항공영상과 겹쳐보면, 실제 산사태 흔적이 고위험 구역과 얼마나 일치하는지 직접 눈으로 확인할 수 있습니다. QGIS에서 래스터 레이어를 불러온 뒤 레이어 패널에서 오른쪽 클릭 > 속성 > 심볼로지 탭에서 단계 구분 색상을 설정하고, 위성영상 레이어를 아래에 깔아 투명도를 조절해 보면 지도의 신뢰성을 직관적으로 점검할 수 있습니다.

⚠️ 위험지도를 실무에 쓸 때 어떤 한계를 알아야 하나요?

모델은 학습 데이터 품질에 크게 좌우됩니다. 과거 산사태 목록이 불완전하거나 특정 지역에만 편중되어 있으면, 모델도 그 편향을 그대로 이어받습니다. 또한 입력 인자의 공간 해상도가 낮으면(예: 경사 데이터가 30m 격자일 때) 좁은 계곡이나 절개지처럼 세밀한 위험 구역을 놓칠 수 있습니다.

모델 종류마다 결과가 다르게 나오는 것도 흔한 일입니다. 같은 지역을 로지스틱 회귀와 랜덤 포레스트로 각각 분석하면 고위험 구역의 위치와 면적이 달라질 수 있습니다. 따라서 단일 모델의 결과를 절대적으로 믿기보다는 여러 모델의 결과를 비교하거나 앙상블(여러 모델의 결과를 합산)하는 방법을 씁니다. 실무에서는 위험지도를 만든 기관, 사용한 데이터의 기준 연도, 모델 검증 지표를 메타데이터로 함께 보관해야 다음 담당자가 지도를 올바르게 해석할 수 있습니다.

🖥️ 화면에서 따라하기

따라하기 단계

  1. DEM 내려받기
    국토지리정보원 공개 DEM 포털에서 연구 대상 지역의 수치 표고 모델 파일을 내려받는다.
  2. QGIS 불러오기
    QGIS 상단 메뉴 레이어 > 레이어 추가 > 래스터 레이어에서 내려받은 DEM 파일을 선택하고 추가를 누른다.
  3. 경사 계산
    상단 메뉴 래스터 > 분석 > 경사(Slope)를 선택하고 입력 레이어에 DEM을 지정한 뒤 실행을 누른다 (메뉴 위치는 QGIS 버전에 따라 다를 수 있으며, 못 찾으면 상단 검색창에 'Slope'를 입력한다).
  4. 심볼로지 설정
    경사 레이어에서 오른쪽 클릭 > 속성 > 심볼로지 탭에서 단일 밴드 의사 색상을 선택하고 등급 수를 5로 지정한 뒤 분류를 누른다.
  5. 위성영상 겹치기
    XYZ Tiles에서 Google Satellite 레이어를 레이어 패널 아래쪽으로 드래그해 배치하고, 경사 레이어의 투명도를 50%로 조절해 두 레이어를 함께 본다.
  6. 결과 점검
    실제 산사태 발생 이력 지점(시도 재난안전 부서 제공 데이터)을 벡터 레이어로 불러와 고경사 구역과 일치 여부를 눈으로 확인한다.

※ 프로그램 버전에 따라 메뉴 이름이 조금씩 다를 수 있습니다. 위 그림은 순서를 정리한 도식입니다.

✍️ 그대로 복사해 쓰는 프롬프트

산사태 취약성 분석 결과를 주민 설명 자료나 내부 보고서 형식으로 정리할 때 사용

당신은 재난안전 분야 보고서 작성을 돕는 전문 보조자입니다.
아래 조건에 맞게 산사태 취약성 분석 결과 요약문을 작성해 주세요.

- 대상 지역: [시·군·구명]
- 분석에 사용한 주요 인자: [경사, 지질, 강우 등 실제 사용 인자 목록]
- 모델 종류: [로지스틱 회귀 / 랜덤 포레스트 / 기타]
- 고위험 구역 비율: [전체 면적 대비 %]
- 모델 검증 지표(AUC 등): [값]

작성 조건:
1. 주민이나 비전문가도 이해할 수 있도록 전문용어는 괄호 안에 짧게 설명한다.
2. 위험지도는 확률적 결과이며 예언이 아님을 명시하는 문장을 반드시 포함한다.
3. 결과를 과장하거나 특정 지점이 반드시 붕괴된다는 표현은 쓰지 않는다.
4. 분량은 A4 반 페이지(약 400자) 이내로 한다.
5. 작성 후 사람이 확인해야 할 항목을 별도로 3가지 나열한다.

※ 대괄호 부분을 상황에 맞게 바꿔서 쓰세요. 받은 답은 그대로 쓰지 말고 사실 확인을 거치세요.

🧪 직접 해보기

  • 국토지리정보원 브이월드(Vworld) 지도 서비스에서 '산사태 위험지도' 레이어를 켜고, 내가 사는 지역의 등급을 직접 확인해 본다.
  • QGIS에서 공개 DEM 데이터를 내려받아 경사 분석을 실행하고, 결과 색상이 지형과 눈으로 봤을 때 일치하는지 위성영상과 겹쳐 비교해 본다.
  • 같은 지역에 대해 로지스틱 회귀와 랜덤 포레스트를 각각 돌려 결과 지도가 어떻게 달라지는지 비교하며 모델 선택의 영향을 직접 느껴본다.

❓ 자주 묻는 질문

Q. 산사태 위험지도에서 '1등급'이 나오면 무조건 위험한 건가요?
A. 1등급은 동일한 조건의 지역 중 상대적으로 취약성이 높다는 뜻이지, 반드시 산사태가 발생한다는 예언이 아닙니다. 등급은 모델이 사용한 데이터와 기준에 따라 달라질 수 있으므로, 지도를 만든 기관의 메타데이터(사용 데이터, 기준 연도, 검증 지표)를 함께 확인하는 것이 중요합니다.

Q. 머신러닝 모델이 통계 모델보다 항상 더 정확한가요?
A. 어떤 모델이 더 정확한지는 데이터 품질, 지역 특성, 학습 샘플 수에 따라 달라집니다. 머신러닝 모델은 복잡한 패턴을 잘 잡지만 결과를 설명하기 어렵고, 통계 모델은 해석이 쉽지만 비선형 관계를 놓칠 수 있습니다. 두 접근법의 장단점을 이해하고 목적에 맞게 선택하는 것이 바람직합니다.

Q. 강우 데이터 없이 경사와 지질 정보만으로도 위험지도를 만들 수 있나요?
A. 가능은 하지만 정확도가 떨어질 수 있습니다. 산사태는 강우가 방아쇠 역할을 하는 경우가 많아, 강우 인자를 제외하면 같은 지형에서도 발생 시점을 반영하지 못합니다. 보유한 데이터 종류에 따라 인자를 조합하되, 모델 검증 지표로 결과의 신뢰성을 반드시 점검해야 합니다.

산사태 위험지도는 수십 년의 지형·지질 정보와 기상 기록을 수치로 압축한 결과물입니다. 그 지도를 보는 사람이 확률과 예언의 차이를 이해하고 있어야 올바른 대피 계획과 예산 결정으로 이어질 수 있습니다. 모델이 틀릴 수 있다는 것을 알면서도 최선의 판단을 내리는 것, 그것이 재난안전 실무의 핵심입니다. 다음 편에서는 이렇게 만들어진 위험지도를 대피로 계획이나 주민 대피 의사결정에 어떻게 연결하는지, 공간 네트워크 분석의 기초를 함께 살펴보겠습니다.

GeoAI 기초 시리즈 13편 · 전체 43편


재난안전과 GeoAI 이야기를 더 보고 싶다면 아래 채널도 함께 보세요.

📌 바로가기
2026-09-27

훈련 시나리오 쓰기 | 생성형 AI로 상황 부여와 진행표 만들기 | 안전한국훈련 실무 3편

훈련 시나리오 쓰기 | 생성형 AI로 상황 부여와 진행표 만들기 | 안전한국훈련 실무 3편

📌 3줄 요약

  • 훈련 시나리오는 계획서와 달리 '상황 부여'와 '대응 흐름'이 핵심이다.
  • 생성형 AI는 초안을 빠르게 잡아 주지만, 지역 실정과 매뉴얼 반영은 사람이 해야 한다.
  • AI 초안은 전문가 검토 후 hwpx로 최종 정리해 결재에 올려야 한다.

훈련 실시계획서를 다 써 놓고 나서야 막히는 단계가 있습니다. 바로 훈련 당일 진행자가 읽어 내려가는 '상황 부여 카드'와 '시간대별 진행표'입니다. 계획서에는 "10시에 홍수 상황을 가정한다"고 적혀 있어도, 실제 훈련장에서는 "현재 시각 10시 00분, A아파트 지하주차장에 침수가 시작됐다는 신고가 들어왔습니다"처럼 구체적인 말이 나와야 참가자들이 움직입니다. 이 문장들을 처음부터 사람이 한 줄씩 쓰다 보면 반나절이 금방 갑니다. 생성형 AI를 활용하면 이 초안 작업을 크게 단축할 수 있습니다. 다만 AI가 만들어 준 시나리오를 그대로 쓰는 것은 위험합니다. 이번 글에서는 AI에게 무엇을 줘야 쓸 만한 초안이 나오는지, 받은 초안에서 무엇을 반드시 사람이 고쳐야 하는지, 그리고 최종 결과물을 한글 문서로 정리하는 방법까지 순서대로 살펴보겠습니다.

📋 시나리오는 계획서와 무엇이 다른가요?

훈련 실시계획서(이하 계획서)는 목적, 일시, 참여 기관, 역할 분담, 예산처럼 '무엇을 왜 하는가'를 담은 문서입니다. 반면 훈련 시나리오는 '무슨 일이 언제 어떻게 벌어지는가'를 시간 순서로 묘사하는 문서입니다. 시나리오의 핵심 요소는 두 가지입니다. 첫째는 상황 부여(Inject)로, 진행자가 참가자에게 전달하는 가상의 사건 정보입니다. 둘째는 대응 흐름으로, 참가자가 그 상황을 받고 어떤 절차를 밟아야 하는지 기대 조치를 정리한 것입니다. 계획서가 공연의 기획안이라면, 시나리오는 실제 대본에 해당합니다. 대본 없이 배우가 무대에 서면 즉흥에 의존하게 되듯, 시나리오가 부실하면 훈련 참가자들이 어디서 무엇을 해야 할지 몰라 흐름이 끊깁니다. 홍수 대피 훈련이라면 "주민 대피 명령을 내리는 의사결정 단계"와 "대피소에서 인원을 집계하는 단계"가 각각 별개의 상황 부여로 나뉘어야 훈련 목표를 측정할 수 있습니다.

🗂️ 상황 부여 카드는 어떻게 구성하면 되나요?

상황 부여 카드 한 장에는 네 가지 항목이 들어가야 합니다. 첫째, 시각입니다. 훈련 시간표상의 몇 분인지, 그리고 가상 상황에서 며칠 몇 시인지를 함께 적습니다. 둘째, 상황 내용입니다. "○○천 수위가 경보 수준을 넘어 제방 일부가 침식되고 있다"처럼 구체적인 장소와 현상을 씁니다. 셋째, 전달 대상입니다. 이 카드를 읽어 주는 진행자와 그것을 받는 기능반(예: 상황반, 주민대피반)을 명시합니다. 넷째, 기대 조치입니다. 참가자가 이 상황 부여를 받고 취해야 하는 표준 행동을 진행자용 정보로 적어 둡니다. 이 항목을 빠뜨리면 평가자가 참가자 행동이 맞는지 판단할 기준이 없어집니다. AI에게 이 네 항목을 형식으로 지정해 달라고 요청하면 일관된 카드를 빠르게 생성할 수 있습니다. 산불 훈련에서는 "발화 지점 좌표와 바람 방향"을 상황 내용에 넣으면 현장감이 살아납니다.

🌍 지역 위험요소와 실제 매뉴얼을 넣어야 하는 이유는 무엇인가요?

AI가 생성하는 기본 시나리오는 일반적인 재난 상황을 가정합니다. 서울의 반지하 침수와 해안 저지대의 해일 피해, 산지 마을의 산사태는 맥락이 전혀 다르지만, AI에게 지역 정보를 주지 않으면 무난하고 추상적인 내용만 나옵니다. 프롬프트에 넣어야 할 정보는 세 가지입니다. 첫째, 지역 내 위험요소입니다(예: 반경 2km 이내 화학물질 취급 업체, 노후 제방 구간, 경사도 30도 이상 절개지). 둘째, 적용할 매뉴얼 또는 행동지침의 주요 절차입니다. 실제 법령명이나 지침 번호를 AI가 임의로 생성하면 오류가 날 수 있으므로, 담당자가 소관 부처 공고와 최신 지침을 직접 확인해 핵심 절차만 텍스트로 정리해서 붙여 넣는 것이 안전합니다. 셋째, 기관 간 연락 체계입니다. AI는 실제 협조 기관명과 연락처를 모르기 때문에 이 부분은 빈칸으로 남겨 두고 담당자가 채웁니다. 이렇게 하면 시나리오가 지역 실정에 맞게 구체화되어 참가자들이 훈련과 실제 상황을 연결해 생각할 수 있습니다.

⚡ 돌발 상황을 추가해 난이도를 올리는 프롬프트는 어떻게 쓰나요?

기본 시나리오만으로는 "예상대로 흘러가는 훈련"이 되기 쉽습니다. 실제 재난은 계획대로 진행되지 않습니다. 통신 두절, 부상자 발생, 자원 부족 같은 돌발 상황을 넣으면 참가자가 즉흥 판단 능력을 연습할 수 있습니다. AI에게 돌발 상황을 추가할 때는 다음 방식이 효과적입니다. 기존 시나리오 초안을 붙여 넣고, "훈련 시작 30분 후에 지휘소와 현장반 간 무선 통신이 끊기는 상황을 추가하고, 참가자가 취해야 할 대체 연락 방법(유선, 전령 등)을 기대 조치에 써 달라"처럼 구체적으로 요청합니다. 난이도를 단계적으로 올리고 싶다면 "초급·중급·고급 버전으로 나눠서 각 버전에 돌발 상황을 1개씩 추가해 달라"고 요청할 수도 있습니다. 해봐야 아는 것이 있습니다. 같은 돌발 상황 카드를 넣어도 훈련 참가자 구성(신규 직원 비율, 숙련자 비율)에 따라 흐름이 완전히 달라집니다. 실제 운영 전에 내부 시뮬레이션을 한 번 돌려 보고, 기대 조치가 현실적으로 가능한지 직접 확인하는 과정이 반드시 필요합니다.

✏️ AI 초안을 그대로 결재에 올리면 안 되는 이유는 무엇인가요?

AI가 생성한 시나리오에는 세 가지 유형의 오류가 자주 섞입니다. 첫째, 존재하지 않는 기관명이나 매뉴얼 조항을 그럴듯하게 만들어 냅니다(환각). 둘째, 지역 도로명·시설명·연락처처럼 고유 정보가 틀리거나 비어 있습니다. 셋째, 훈련 규모와 예산, 참가 인원이 해마다 달라지는데 AI는 그 변동 사항을 모릅니다. 훈련 일정과 규모는 소관 부처 공고와 해당 연도 지침에 따라 달라지므로, 초안에 들어간 숫자와 기관명은 담당자가 하나씩 대조해야 합니다. 전문가가 반드시 확인해야 할 항목은 다음과 같습니다. 상황 부여 카드에 적힌 수위·풍속·피해 규모 등의 수치가 해당 지역 기상·수문 자료와 맞는지, 기대 조치의 절차 순서가 실제 매뉴얼과 일치하는지, 협조 기관과 연락 체계가 현행 조직도를 반영하는지입니다. 최종 초안은 훈련 담당 실무자, 유관 기관 담당자, 가급적 재난관리 전문가가 함께 검토한 뒤 결재에 올려야 합니다. 검토 없이 AI 초안을 그대로 올리면 현장에서 혼선이 생기고, 이는 훈련의 목적 자체를 무너뜨립니다.

🖥️ 화면에서 따라하기

따라하기 단계

  1. 준비 자료 수집
    지역 위험요소 목록, 기관 연락 체계, 훈련 목표를 텍스트 파일에 정리해 둔다
  2. AI 초안 요청
    ChatGPT·Claude 등 생성형 AI 채팅창에 아래 프롬프트를 붙여 넣고 전송한다
  3. 초안 검토
    출력된 시나리오에서 기관명·수치·법령 조항을 소관 지침 원문과 하나씩 대조한다
  4. 돌발 상황 추가
    기존 초안을 붙여 넣고 "통신 두절 상황을 30분 시점에 추가해 달라"고 재요청한다
  5. 내부 시뮬레이션
    담당자끼리 카드를 소리 내어 읽으며 기대 조치가 실제로 가능한지 직접 확인한다
  6. hwpx 파일 생성
    최종 확인된 본문을 복사해 한글(HWP) 새 문서에 붙여 넣거나, AI 도구의 문서 내보내기 기능에서 hwpx 형식을 선택해 다운로드한다(메뉴 이름은 도구 버전에 따라 다를 수 있으므로 공식 도움말을 함께 확인한다)

※ 프로그램 버전에 따라 메뉴 이름이 조금씩 다를 수 있습니다. 위 그림은 순서를 정리한 도식입니다.

✍️ 그대로 복사해 쓰는 프롬프트

지역 위험요소와 훈련 목표를 입력해 상황 부여 카드 초안을 받는 프롬프트

당신은 지방자치단체 재난안전 훈련 시나리오 작성을 돕는 보조 도구입니다.
아래 정보를 바탕으로 훈련 시나리오 상황 부여 카드 초안을 만들어 주세요.

[훈련 대상 재난]: [예: 집중호우로 인한 하천 범람]
[훈련 지역 특성]: [예: 반경 1km 내 노후 제방 구간, 지하상가 2개소, 요양원 1개소]
[훈련 목표]: [예: 주민 대피 명령 발령 절차 숙달, 기관 간 상황 보고 체계 확인]
[훈련 시간]: [예: 총 2시간, 오전 10시 시작]
[참가 기관·역할반]: [예: 상황반, 주민대피반, 의료반]

출력 형식은 다음과 같이 해주세요.
카드 번호 / 훈련 경과 시간 / 가상 상황 시각 / 상황 내용(장소와 현상을 구체적으로) / 전달 대상 기능반 / 기대 조치(표준 절차 순서로 3~5단계)
카드는 총 5장으로 구성하고, 마지막 카드에는 돌발 상황(통신 두절 또는 부상자 발생 중 하나)을 포함해 주세요.
기관명·법령 조항·연락처는 임의로 생성하지 말고 [담당자 확인 필요]로 표시해 주세요.
훈련 규모와 일정은 소관 부처 공고에 따라 달라지므로 구체적인 수치는 넣지 마세요.

완성된 초안의 돌발 상황 난이도를 단계적으로 높이는 프롬프트

아래는 기존에 작성된 훈련 시나리오 카드 초안입니다.
[기존 시나리오 초안 붙여 넣기]

이 시나리오를 초급·중급·고급 세 버전으로 나눠 주세요.
초급에는 돌발 상황 없이 기본 흐름만, 중급에는 부상자 1명 발생 상황을 훈련 45분 시점에 추가, 고급에는 부상자 발생과 함께 지휘소-현장반 무선 통신 두절 상황을 동시에 넣어 주세요.
각 버전마다 진행자가 읽을 멘트와 기대 조치를 별도로 써 주세요.
기관명·연락처·법령 번호는 [담당자 확인 필요]로 남겨 두세요.

※ 대괄호 부분을 상황에 맞게 바꿔서 쓰세요. 받은 답은 그대로 쓰지 말고 사실 확인을 거치세요.

🧪 직접 해보기

  • 생성형 AI 채팅창에 자신이 담당하는 지역의 대표 위험요소 3가지를 입력하고, 위 프롬프트로 상황 부여 카드 5장 초안을 받아 본다.
  • 받은 초안의 기대 조치 순서가 자신이 알고 있는 실제 매뉴얼 절차와 다른 점이 몇 군데인지 직접 찾아 표시해 본다(해봐야 아는 것).
  • 초안을 한글(HWP) 새 문서에 붙여 넣은 뒤, 표 서식을 써서 카드 번호·시각·상황·기대 조치를 열로 나눠 정리해 보고 인쇄 미리 보기로 가독성을 확인한다.

❓ 자주 묻는 질문

Q. AI가 만든 시나리오에 법령 이름이 나왔는데 그대로 써도 되나요?
A. 그대로 쓰면 안 됩니다. 생성형 AI는 법령명·조항 번호·지침 제목을 그럴듯하게 생성하지만 실제와 다를 수 있습니다. 반드시 소관 부처 공고나 국가법령정보센터에서 원문을 확인한 뒤 수정해야 합니다.

Q. 상황 부여 카드를 몇 장 만들어야 적당한가요?
A. 훈련 시간과 목표에 따라 다릅니다. 일반적으로 1~2시간 훈련이라면 주요 의사결정 단계마다 1장씩, 5~8장 안팎이 현장에서 다루기 편합니다. 너무 많으면 진행 속도를 따라가기 어렵고, 너무 적으면 훈련 흐름이 단조로워집니다.

Q. hwpx 파일을 AI가 직접 만들어 줄 수 있나요?
A. 일부 AI 도구는 문서 내보내기 기능을 제공하며, hwpx 형식을 지원하는 경우도 있습니다. 다만 지원 여부와 방식은 도구와 버전에 따라 다르므로, 해당 도구의 공식 도움말에서 '내보내기' 또는 '다운로드' 메뉴를 확인하는 것이 가장 정확합니다.

훈련 시나리오는 계획서보다 훨씬 구체적인 문서이고, 그만큼 만드는 데 품이 많이 듭니다. 생성형 AI는 이 초안 작업에서 시간을 크게 아껴 주지만, 지역 실정을 반영하고 매뉴얼과 대조하고 전문가 검토를 거치는 일은 사람의 몫입니다. AI가 준 초안은 출발점이지 완성본이 아닙니다. 검토가 끝난 시나리오는 한글 문서(hwpx)로 정리해 두면 다음 해 훈련 때 수정 작업이 훨씬 수월해집니다. AI 채팅창에서 최종 본문을 복사해 한글 새 문서에 붙여 넣은 뒤 표와 쪽 번호를 정리하거나, 도구가 hwpx 내보내기를 지원한다면 그 기능을 이용해 한 번에 받을 수 있습니다. 어느 방법이든 저장 후 한글 프로그램에서 열어 글꼴과 여백이 올바른지 확인하는 단계는 빠뜨리지 마세요. 다음 편에서는 이렇게 만든 시나리오와 GIS 공간 데이터를 연결해, 훈련 지도 위에 상황 부여 위치를 표시하는 방법을 살펴볼 예정입니다.

안전한국훈련 실무 시리즈 3편 · 전체 9편


재난안전과 GeoAI 이야기를 더 보고 싶다면 아래 채널도 함께 보세요.

📌 바로가기
SAR 위성으로 침수 지역을 찾는 원리 | GeoAI 기초 12편

SAR 위성으로 침수 지역을 찾는 원리 | GeoAI 기초 12편

📌 3줄 요약

  • SAR 위성은 구름·밤에도 레이더파로 지표를 관측할 수 있다
  • 물 표면은 레이더파를 정반사해 후방산란이 낮아 어둡게 보인다
  • 홍수 전후 영상을 비교하는 변화탐지로 침수 범위를 구분한다

집중호우가 48시간째 이어지는 상황을 상상해 보세요. 하늘은 두꺼운 구름으로 가득 차 있고, 재난 대응 기관은 어느 지역이 얼마나 잠겼는지 파악하지 못해 구조 차량 배치도 못 하고 있습니다. 이때 일반 광학 위성은 구름 때문에 지표를 아예 볼 수 없습니다.

SAR(합성개구레이더, Synthetic Aperture Radar) 위성은 이 상황에서 빛을 발합니다. SAR는 마이크로파 대역의 레이더 신호를 스스로 쏘고 반사돼 돌아오는 신호를 기록하기 때문에, 구름이 두껍거나 야간이어도 지표 정보를 얻을 수 있습니다. 홍수 대응 실무에서 SAR 영상으로 침수 범위를 찾는 원리를 단계별로 풀어 보겠습니다.

🛰️ SAR 위성은 어떤 방식으로 지표를 관측하나요?

SAR는 안테나에서 마이크로파를 지표를 향해 비스듬히 쏘고, 지표 물체에 부딪혀 돌아오는 신호의 세기(후방산란, backscatter)를 측정합니다. 후방산란이 강할수록 영상에서 밝게, 약할수록 어둡게 표현됩니다. 건물이나 울퉁불퉁한 숲은 신호를 사방으로 반사해 많은 양이 안테나로 되돌아오기 때문에 밝게 나타납니다. 반대로 표면이 고르고 매끄러울수록 신호는 거울처럼 멀리 튕겨 나가 안테나로는 거의 돌아오지 않습니다. 위성 운용 기관에 따라 관측 주파수(C밴드, L밴드 등)와 해상도가 다르므로, 분석 전에 사용할 영상의 메타데이터를 반드시 확인해야 합니다. 홍수 대응에서는 이 특성 덕분에 구름이 낀 재난 상황에서도 반복 관측이 가능하고, 야간 침수 확산 모니터링에도 활용됩니다.

🌊 물이 SAR 영상에서 어둡게 보이는 이유가 뭔가요?

잔잔한 물 표면은 거울과 비슷하게 작동합니다. SAR 신호가 비스듬히 입사하면, 수면은 신호를 입사각과 반대 방향으로 정반사(specular reflection)시켜 버립니다. 안테나로 되돌아오는 에너지가 극히 적으므로 후방산란 값이 낮아지고, 영상에서는 어두운 색으로 표현됩니다. 이 원리는 잔잔한 호수, 침수된 논, 도시 침수 구역 모두에 동일하게 적용됩니다. 단, 바람이 강하거나 수면에 파도가 생기면 거칠어진 수면이 신호를 분산 반사하기 때문에 후방산란이 올라가 어두운 정도가 줄어들 수 있습니다. 재난 현장에서 강풍을 동반한 태풍 상황에는 이 점을 감안해 침수 범위가 실제보다 좁게 탐지될 수 있다는 것을 미리 고려해야 합니다.

🔍 변화탐지로 침수 범위를 찾는 절차는 어떻게 되나요?

변화탐지(Change Detection)는 같은 지역을 촬영한 두 시기의 영상을 비교해 달라진 부분을 찾아내는 방법입니다. 홍수 침수 탐지에서는 다음 순서로 진행합니다. 첫째, 홍수 이전(평상시) SAR 영상과 홍수 이후 영상을 준비합니다. 둘째, 두 영상을 같은 좌표계로 정합(registration)하여 픽셀 위치를 맞춥니다. 셋째, 후방산란 차이값(후방산란_이전 빼기 후방산란_이후)을 계산합니다. 홍수로 물이 고인 곳은 이전에는 밝았다가 이후에는 어두워지므로, 차이값이 큰 음수로 나타납니다. 넷째, 임계값(threshold)을 정해 그 이하인 픽셀을 침수 후보로 분류합니다. 이 임계값은 지역과 계절마다 달라질 수 있어 직접 확인해야 하는 부분입니다. 실무에서는 이렇게 추출한 침수 후보 영역을 행정 경계, 인구 데이터와 겹쳐서 피해 가구 수를 추정하는 데 활용합니다.

아래는 Python과 numpy를 사용해 후방산란 차이 이미지를 구하는 간단한 예시입니다.

import numpy as np
import rasterio

with rasterio.open("sar_before.tif") as src:
    before = src.read(1).astype(float)

with rasterio.open("sar_after.tif") as src:
    after = src.read(1).astype(float)

diff = after - before
threshold = -3.0  # dB 단위 임계값은 지역별로 직접 조정 필요
flood_mask = diff < threshold

⚠️ 오탐이 생기는 주요 원인은 무엇인가요?

SAR 변화탐지에서 자주 마주치는 오탐(false positive, 실제로는 침수가 아닌데 침수로 잡히는 경우)은 크게 두 가지입니다. 첫째는 그림자입니다. 산지나 고층 건물 뒤편에 생기는 레이더 그림자(radar shadow) 영역은 신호가 거의 도달하지 않아 후방산란이 낮게 나오며, 이 부분이 물로 오인될 수 있습니다. 둘째는 매끄러운 지면입니다. 비포장 도로, 짧게 깎은 잔디밭, 건조한 소금 평지처럼 표면이 고른 곳은 잔잔한 수면과 비슷한 낮은 후방산란을 보일 수 있습니다. 이를 걸러내려면 DEM(수치표고모델)으로 경사가 심한 그림자 영역을 마스킹하거나, 토지피복 데이터를 겹쳐 건물 밀집 지역과 교차 확인하는 과정이 필요합니다. 재난 대응 결정권자에게 탐지 결과를 보고할 때는 이런 오탐 가능성을 함께 명시하는 것이 신뢰도 높은 보고서의 기본 요건입니다.

🗺️ 실제 재난 대응 업무에서는 어떻게 연결되나요?

침수 범위가 벡터 폴리곤으로 확정되면, 이 데이터는 여러 단계의 의사결정에 연결됩니다. 행정안전부나 지자체의 재난 상황실에서는 침수 폴리곤을 도로망 데이터와 겹쳐 접근 불가 구역을 파악하고, 구조 차량 경로를 재설정하는 데 씁니다. 또 주민등록 기반 거주지 데이터와 교차하면 고립 가능 인구를 빠르게 추정할 수 있습니다. 이 과정에서 영상 촬영 시각과 분석 결과 제공 시각 사이의 시간 지연이 현장 활용성을 크게 좌우합니다. 따라서 분석 자동화 파이프라인을 미리 구축해 두고, 위성 영상이 수신되는 즉시 처리 결과가 나오도록 준비해 두는 것이 실무에서 점점 중요해지고 있습니다. 다음 편에서는 이런 자동화 흐름에 딥러닝 모델을 얹는 방법을 살펴볼 예정입니다.

🖥️ 화면에서 따라하기

따라하기 단계

  1. 영상 검색
    ESA Copernicus Data Space(https://dataspace.copernicus.eu) 접속 후 검색창에 관심 지역 입력, Sentinel-1 GRD 필터 선택
  2. 기간 설정
    날짜 범위 필드에 홍수 발생 전 30일과 발생 후 날짜를 각각 입력, 두 영상 다운로드
  3. SNAP 열기
    ESA SNAP 실행 > File > Open Product로 두 영상(.zip) 차례로 불러오기 (버전에 따라 메뉴 위치가 다를 수 있으므로 SNAP 공식 문서 참고)
  4. 전처리 실행
    Radar > Geometric > Terrain Correction 선택, 출력 좌표계를 EPSG:4326으로 설정 후 Run
  5. 차이 계산
    Raster > Band Maths 클릭, 수식 입력창에 'after_VV - before_VV' 입력 후 OK
  6. 임계값 분류
    Band Maths 재실행, '(after_VV - before_VV) < -3.0' 입력해 침수 마스크 생성, 결과 레이어 내보내기

※ 프로그램 버전에 따라 메뉴 이름이 조금씩 다를 수 있습니다.

✍️ 그대로 복사해 쓰는 프롬프트

SAR 침수 탐지 분석 결과를 재난 상황실 보고용 설명문으로 정리할 때 사용

당신은 재난안전 분야 GIS 분석가입니다.
아래 SAR 변화탐지 분석 결과를 바탕으로, 재난 상황실 비전문가 담당자가 이해할 수 있는 간결한 보고 문단을 작성해 주세요.
분석 개요: [홍수 발생 지역], [촬영 날짜 전후], Sentinel-1 GRD 영상 사용
침수 추정 면적: [숫자] km²
주요 침수 행정구역: [구역 목록]
오탐 가능성 지역: [해당 지역 또는 '없음']
작성 조건:
- 200자 내외의 한국어 단락 1개로 작성
- SAR, 후방산란 같은 전문용어는 괄호 안에 한 줄 설명 추가
- 분석의 불확실성(오탐 가능성, 바람 영향 등)을 마지막 문장에 반드시 포함
- 확인되지 않은 수치는 절대 추가하지 말 것
사람이 확인해야 할 항목: 면적 수치가 실제 입력값과 일치하는지, 불확실성 문장이 빠지지 않았는지 검토하세요.

※ 대괄호 부분을 상황에 맞게 바꿔서 쓰세요. 받은 답은 그대로 쓰지 말고 사실 확인을 거치세요.

🧪 직접 해보기

  • Copernicus Data Space에서 국내 하천 인근 지역의 Sentinel-1 GRD 영상을 두 시기 검색해, 육안으로 밝기 차이가 보이는 위치를 찾아보세요
  • ESA SNAP의 Band Maths 기능으로 두 시기 영상의 VV 밴드 차이 이미지를 만들고, 히스토그램을 확인해 임계값을 직접 조정하며 침수 후보 영역이 어떻게 바뀌는지 관찰하세요
  • 추출한 침수 마스크를 QGIS에서 레이어로 불러온 뒤, 배경 지도와 비교해 그림자·도로 등 오탐 의심 지점을 3곳 이상 찾아 메모해 보세요

❓ 자주 묻는 질문

Q. 광학 위성 NDWI와 SAR 침수 탐지는 어떻게 다른가요?
A. NDWI는 가시광·근적외선 반사율 차이를 이용하므로 구름이 없을 때만 사용할 수 있습니다. SAR는 마이크로파를 직접 쏘기 때문에 구름과 야간에도 관측이 가능합니다. 두 방법의 결과를 교차 검증하면 탐지 신뢰도를 높일 수 있습니다.

Q. 임계값은 어떻게 정하나요?
A. 정해진 고정값은 없습니다. 지역의 토지피복, 계절, 위성 관측 각도에 따라 달라지므로 먼저 분석 지역 안에서 확실히 침수된 곳과 침수되지 않은 곳을 몇 군데 골라 후방산란 차이값 분포를 직접 확인해야 합니다. 이렇게 기준 지점을 정해 임계값을 조정하는 과정을 현장 검증(ground truthing)이라고 합니다.

Q. SAR 영상은 어디서 무료로 받을 수 있나요?
A. ESA(유럽우주국)의 Copernicus Data Space에서 Sentinel-1 영상을 등록 후 내려받을 수 있습니다. 제공 조건과 접근 방식은 플랫폼 정책에 따라 변경될 수 있으므로, 이용 전에 해당 사이트의 최신 이용 약관을 확인하세요.

SAR 영상에서 물이 어둡게 보이는 이유는 물리적으로 단순합니다. 잔잔한 수면이 레이더 신호를 먼 곳으로 튕겨 버리기 때문입니다. 이 단순한 원리 위에 변화탐지라는 비교 절차를 얹으면, 구름이 가득한 재난 상황에서도 침수 범위를 추정하는 실용적인 도구가 됩니다. 다만 그림자와 매끄러운 지면이 만드는 오탐은 자동 분석만으로는 완전히 걸러내기 어렵고, 반드시 사람이 지형·토지피복 데이터를 함께 보며 검토하는 단계가 필요합니다. 침수 범위를 픽셀 단위로 찾아냈다면, 다음 질문은 자연스럽게 이어집니다. 이 침수 지역에 딥러닝 모델을 얹으면 더 빠르고 정확하게 탐지할 수 있을까요?

GeoAI 기초 시리즈 12편 · 전체 43편


재난안전과 GeoAI 이야기를 더 보고 싶다면 아래 채널도 함께 보세요.

📌 바로가기
2026-09-26

생성형 AI 사용법 3 | 틀린 답(환각)을 걸러내는 법

📌 3줄 요약

  • 생성형 AI의 환각은 모델 구조 특성에서 비롯된 필연적 현상이다.
  • 숫자·법령·출처가 포함된 답변은 반드시 원문 자료로 재확인해야 한다.
  • 확인 습관과 출처 요구 프롬프트를 함께 쓰면 오류를 줄일 수 있다.

재난안전 업무에서 생성형 AI를 쓰다 보면 이런 일이 생깁니다. 홍수 대피 기준 거리를 물었더니 AI가 법령 조항 번호까지 들어 자신 있게 대답합니다. 문장도 매끄럽고, 구조도 그럴듯합니다. 그런데 실제 법령을 국가법령정보센터에서 검색해 보면 그 조항이 없거나, 숫자가 다릅니다. AI가 거짓말을 하려고 만든 답이 아닙니다. 모델 자체의 작동 방식에서 이런 오류가 생깁니다.

이 현상을 '환각(Hallucination)'이라고 부릅니다. AI가 없는 정보를 있는 것처럼 그럴듯하게 만들어 내는 것을 뜻하는 용어입니다. 환각이 생기는 이유를 알고, 어떤 항목을 반드시 확인해야 하는지 기준을 세워 두면, AI를 훨씬 안전하게 쓸 수 있습니다. 이번 글에서는 그 원리와 확인 습관을 실무 관점에서 짚어 보겠습니다.

🤔 환각은 왜 생기나요? AI가 일부러 속이는 건가요?

생성형 AI는 '다음에 올 가능성이 높은 단어'를 계속 이어 붙이는 방식으로 문장을 만듭니다. 방대한 텍스트를 학습해 언어 패턴을 익힌 것이지, 사실 데이터베이스를 검색하는 구조가 아닙니다. 그러다 보니 질문에 어울리는 형태의 답을 생성하는 과정에서 실제로 존재하지 않는 숫자, 논문 제목, 조항 번호가 만들어지기도 합니다. 틀린 내용이더라도 문체와 형식이 자연스럽기 때문에 독자가 걸러내기 어렵습니다. 의도적인 거짓이 아니라 구조적 한계입니다. 재난 상황에서는 대피 거리, 경보 발령 기준, 법적 의무 조항 같은 정보가 잘못 전달되면 직접적인 피해로 이어질 수 있으므로, 이 특성을 먼저 이해하는 것이 중요합니다.

🔍 어떤 종류의 답변을 특히 의심해야 하나요?

모든 답변을 일일이 검증하기는 어렵습니다. 우선순위를 두어야 합니다. 확인 없이 그대로 쓰면 안 되는 항목은 다음과 같습니다. 첫째, 법령 조항 번호와 내용입니다. 재난안전법, 자연재해대책법, 급경사지법 등은 개정이 잦아서 AI가 학습한 시점과 현재가 다를 수 있습니다. 둘째, 통계 수치와 연도입니다. 피해 규모, 사망자 수, 발생 빈도 같은 숫자는 출처 없이 신뢰할 수 없습니다. 셋째, 기관명과 담당 부서입니다. 조직 개편으로 이름이 바뀐 경우가 많습니다. 넷째, 인용 논문이나 보고서 제목과 저자입니다. 아예 존재하지 않는 문헌이 만들어지는 경우가 드물지 않습니다. 산사태 위험 등급 기준이나 홍수 예보 발령 조건처럼 수치가 기준이 되는 항목은 반드시 원문 고시나 지침서에서 확인하세요.

📋 출처를 요구하는 프롬프트는 어떻게 써야 하나요?

출처를 함께 달라고 요청하면 AI가 참고 자료처럼 보이는 목록을 붙여 주기도 합니다. 그런데 그 목록도 환각일 수 있습니다. 그래서 프롬프트에 출처를 요구할 때는 두 가지를 함께 적는 것이 좋습니다. 하나는 "출처를 모를 경우 솔직하게 모른다고 써 달라"는 지시이고, 다른 하나는 "내가 확인할 수 있는 공개 문서 이름이나 기관 사이트를 함께 알려 달라"는 요청입니다. 이렇게 하면 AI가 그럴듯한 가짜 출처를 만들 여지가 줄고, 독자가 직접 검색할 방향을 잡을 수 있습니다. 재난안전 문서를 작성할 때는 AI가 제시한 법령 이름을 국가법령정보센터(law.go.kr)에서 직접 검색해 조항 내용을 대조하는 것을 습관으로 만드세요.

✅ 받은 답변을 직접 검증하는 절차가 있나요?

해봐야 아는 것이 있습니다. AI에게 같은 질문을 맥락 없이 한 번, 역할과 조건을 구체적으로 준 다음 한 번, 총 두 번 물어보세요. 그리고 두 답변에서 숫자나 조항이 일치하는지 비교합니다. 일치하지 않는다면 둘 다 신뢰하면 안 됩니다. 일치하더라도 원문 자료를 확인하기 전까지는 초안 수준으로만 다루어야 합니다. 확인 순서를 간단히 정리하면 이렇습니다. 법령은 국가법령정보센터, 통계는 출처 기관 공식 사이트, 사업 지침은 해당 부처 공문이나 고시로 확인합니다. 특히 산불 진화 인력 기준이나 홍수 대피령 발령 요건처럼 행정적 판단의 근거가 되는 항목은, AI 답변을 초안으로만 쓰고 반드시 원문에서 재확인하는 두 단계 절차를 유지하세요.

🗂️ AI를 믿고 쓸 수 있는 부분과 그렇지 않은 부분은 어떻게 나누나요?

생성형 AI가 상대적으로 잘하는 영역이 있습니다. 이미 내가 가진 내용을 다른 표현으로 정리하거나, 문장 흐름을 자연스럽게 다듬거나, 항목별 체크리스트 형식으로 바꾸는 일입니다. 반대로 새로운 사실을 생성하거나, 특정 시점의 최신 현황을 알려주거나, 법적 효력이 있는 정보를 정확하게 인용하는 일은 AI에게 맡기기 어렵습니다. 실무에서 이 선을 그을 때는 간단한 기준 하나를 쓸 수 있습니다. '내가 이 내용을 직접 확인할 경로가 있는가?' 경로가 있으면 AI 초안을 바탕으로 확인하면 됩니다. 경로가 없거나 불분명하다면 그 내용 자체를 문서에 포함시키지 않는 것이 안전합니다. 대피 계획서나 훈련 결과 보고서에서 잘못된 수치가 들어가면, 다음 훈련 설계나 실제 대응 체계에 오류가 그대로 누적됩니다.

🖥️ 화면에서 따라하기

  1. 새 대화 시작
    AI 도구 화면에서 새 대화(New Chat) 버튼을 눌러 이전 맥락 없이 시작한다.
  2. 역할·맥락 입력
    첫 메시지에 "나는 재난안전 담당자이고, [주제] 관련 초안을 쓰려 한다"를 먼저 입력한다.
  3. 출처 조건 지정
    같은 메시지에 "모르는 내용은 모른다고 써 달라, 법령 이름은 확인 가능한 것만"을 추가한다.
  4. 답변 수령 후 분리
    받은 답변에서 숫자·법령 조항·기관명을 색깔펜으로 따로 표시해 목록을 만든다.
  5. 원문 대조 확인
    법령은 law.go.kr, 통계는 출처 기관 사이트에서 직접 검색해 항목별로 맞는지 확인한다.
  6. 재요청(필요시)
    틀린 항목을 발견하면 같은 대화에서 "이 부분은 [원문 내용]으로 수정해 달라"고 입력한다.

※ 프로그램 버전에 따라 메뉴 이름이 조금씩 다를 수 있습니다.

✍️ 그대로 복사해 쓰는 프롬프트

막연하게 요청했을 때 어떤 답이 나오는지 확인용 (비교 기준)

[재난 종류]와 관련된 대피 기준을 알려줘.

맥락과 조건을 준 요청으로, 환각 가능성을 줄이고 검증 방향을 함께 얻는 프롬프트

너는 재난안전 분야 문서 작성을 돕는 보조자야.
나는 [기관명] 소속 재난안전 담당자이고, [재난 종류] 관련 대피 기준을 내부 보고서 초안에 활용하려 해.
아래 조건을 반드시 지켜줘.
1. 법령 조항 번호나 고시 제목은 네가 확인하지 못한 경우 "확인 필요"라고 표시해.
2. 수치가 들어간 항목마다 "출처: [확인 가능한 기관 또는 문서명]"을 한 줄로 달아줘.
3. 최신 개정 여부는 알 수 없으므로, 독자가 law.go.kr에서 재확인해야 한다는 안내를 마지막에 한 줄 넣어줘.
4. 내가 직접 확인해야 할 항목을 답변 끝에 별도 목록으로 정리해줘.
출력 형식은 항목별 표 또는 번호 목록으로 해줘.
결과를 한글 문서로 받고 싶으면 답변 마지막에 "위 내용을 hwpx 형식으로 내려받을 수 있게 파일로 만들어 줘"라고 추가 요청하면 됩니다(도구에 따라 지원 여부가 다릅니다).

※ 대괄호 부분을 상황에 맞게 바꿔서 쓰세요. 받은 답은 그대로 쓰지 말고 사실 확인을 거치세요.

🧪 직접 해보기

  • AI에게 아무 조건 없이 재난 관련 법령 조항을 물어보고, 그 답변을 law.go.kr에서 직접 검색해 일치 여부를 확인해 본다.
  • 위에 제시한 '맥락을 준 프롬프트'를 복사해 직접 붙여 넣고, 막연한 요청과 결과가 얼마나 다른지 비교해 본다.
  • AI가 준 답변에서 숫자가 포함된 문장만 골라 목록으로 만들고, 그중 하나라도 원문과 다른 항목이 있는지 확인해 본다.

❓ 자주 묻는 질문

Q. AI가 출처를 달아줬는데 그것도 믿으면 안 되나요?
A. AI가 제시한 출처는 실제로 존재하지 않는 경우가 있습니다. 출처 이름을 받았다면, 그 이름을 직접 검색해 문서가 실제로 있는지 확인하는 것이 필수입니다. 출처 목록이 있어도 검증 절차는 생략할 수 없습니다.

Q. 환각을 완전히 없애는 프롬프트 방법이 있나요?
A. 완전히 없애는 방법은 현재 알려진 것이 없습니다. 조건을 구체적으로 줄수록, 모르면 모른다고 표시하도록 요청할수록 오류가 줄어드는 경향이 있지만, 어느 도구든 확인 절차를 대체하지는 못합니다.

Q. 재난안전 문서에서 AI 답변을 그대로 쓰면 어떤 문제가 생기나요?
A. 잘못된 법령 조항이나 수치가 공식 문서에 들어가면 행정적 오류나 현장 대응 혼선으로 이어질 수 있습니다. 대피 기준, 경보 발령 조건, 담당 기관 정보 등은 반드시 원문을 확인한 후 문서에 반영해야 합니다.

생성형 AI는 문서 초안을 빠르게 잡거나, 복잡한 내용을 읽기 쉽게 다듬는 데 분명히 유용합니다. 그런데 그 편리함 뒤에는 구조적으로 오류가 끼어들 수 있다는 사실을 늘 기억해야 합니다. 특히 재난안전 분야에서는 작은 숫자 하나, 조항 번호 하나가 현장 대응과 직결됩니다. AI를 쓸수록 확인 습관이 더 중요해지는 이유가 여기 있습니다. 환각을 걸러내는 습관이 자리를 잡으면, 다음으로 자연스럽게 떠오르는 질문이 있습니다. AI와 대화를 이어가면서 이전 맥락을 어떻게 유지하고, 긴 문서 작업을 끊기지 않게 하려면 어떻게 해야 할까요?

생성형AI 사용법 시리즈 3편 · 전체 15편


재난안전과 GeoAI 이야기를 더 보고 싶다면 아래 채널도 함께 보세요.

📌 바로가기
안전한국훈련 실시계획서, AI로 초안 잡고 검토하기 | 안전한국훈련 실무 2편

안전한국훈련 실시계획서, AI로 초안 잡고 검토하기 | 안전한국훈련 실무 2편

🎬 1분 브리핑 영상

📌 3줄 요약

  • 실시계획서는 기본계획서보다 한 단계 더 구체적인 실행 문서다
  • AI에게 기본계획서 전문을 붙여 주면 일관된 초안을 빠르게 받을 수 있다
  • AI 초안은 반드시 사람이 현장 적합성과 법령 준수 여부를 검토해야 한다

훈련 한 달 전, 기본계획서는 이미 결재가 끝났습니다. 이제 현장 담당자들이 실제로 들고 다닐 문서를 만들어야 합니다. 언제, 누가, 어디서, 무엇을 하는지가 줄 단위로 적힌 실시계획서입니다. 기본계획서를 보고 실시계획서를 처음부터 다시 쓰려고 하면 같은 내용을 두 번 입력하는 낭비가 생깁니다. 이 글에서는 기본계획서 내용을 AI에게 그대로 물려주면서, 시간대별 진행표와 역할분담표, 안전관리 항목, 평가 기준까지 표 형태로 받는 순서를 단계별로 설명합니다. 받은 초안을 검토하는 질문, 현장에서 지켜지지 않을 계획을 미리 걸러내는 방법, 마지막으로 한글 문서(.hwpx)로 완성하는 순서까지 실무 흐름 그대로 따라갈 수 있도록 정리했습니다. 훈련 일정과 규모는 해마다 달라지므로 소관 부처의 최신 공고와 지침을 반드시 확인하세요.

📋 기본계획서와 실시계획서, 무엇이 다른가요?

기본계획서는 "우리 기관이 이번 훈련에서 무엇을 목표로, 어떤 범위에서 훈련하겠다"는 방향 문서입니다. 훈련 목적, 대상 재난 유형, 참가 기관과 인원 규모, 예산 개요 같은 큰 그림이 담깁니다. 반면 실시계획서는 그 틀 안에서 "9시 00분 대피령 발령, 담당자 홍길동, 장소 1층 방재실 유선전화"처럼 누가 언제 어디서 무엇을 하는지를 한 줄씩 채운 실행 설명서입니다. 같은 기관이 만드는 두 문서이지만 독자가 다릅니다. 기본계획서는 상급 기관이나 결재자가 주로 읽고, 실시계획서는 현장 참여자 모두가 훈련 당일 손에 들고 움직입니다. 그래서 실시계획서에는 시간대별 진행표, 역할분담표, 비상연락망, 장비 점검 목록, 평가 항목이 모두 포함되어야 합니다. 산불 대응 훈련이라면 진화대 출동 시각, 드론 운용자 이름, 지휘본부 좌표까지 들어가야 현장에서 쓸 수 있습니다.

🤖 AI에게 기본계획서를 어떻게 물려주나요?

AI가 실시계획서 초안을 잘 만들려면 기본계획서의 내용을 그대로 알아야 합니다. 가장 효과적인 방법은 대화창에 기본계획서 전문을 붙여 넣고, 첫 문장에 "아래 기본계획서 범위 안에서만 작성해 주세요"라고 제한을 거는 것입니다. 이렇게 하면 AI가 임의로 기관명을 지어내거나 훈련 목적을 바꾸는 오류를 크게 줄일 수 있습니다. 문서가 길어서 한 번에 붙여 넣기 어려울 경우, 목적·범위·참가기관·일정 항목만 먼저 주고 "이 정보를 기억해 두세요, 이후 질문에서 활용합니다"라고 알린 뒤 다음 대화에서 세부 표를 요청하는 방식으로 나눌 수 있습니다. 단, AI 도구마다 대화 내에서 앞선 내용을 유지하는 방식이 다르므로 긴 세션에서는 핵심 정보를 다시 한번 상기시켜 주는 것이 안전합니다. 홍수 대피 훈련처럼 대피 동선이 핵심인 경우, 기본계획서의 대피 구역 정보를 그대로 붙여 주면 각 구역별 담당자 배치표를 일관성 있게 받을 수 있습니다.

🗂️ 표 형태의 진행표와 역할분담표, 어떻게 요청하나요?

AI에게 표를 요청할 때는 열 이름을 직접 지정하는 것이 좋습니다. "시간, 훈련 단계, 담당자, 장소, 필요 장비, 비고 열로 구성된 시간대별 진행표를 만들어 주세요"처럼 구체적으로 쓰면 원하는 형태에 가깝게 받을 수 있습니다. 역할분담표는 "직위, 성명(임시), 담당 임무, 연락 수단, 대체자 열"로 요청합니다. 성명은 AI가 임의로 채우지 않도록 "[현장에서 입력]"이라고 빈칸 표시를 달아 달라고 요청하세요. 안전관리 항목은 "훈련 중 발생 가능한 위험 상황, 예방 조치, 발생 시 대응 절차, 책임자"를 열로 지정하면 체크리스트 형태로 받을 수 있습니다. 평가 항목은 "평가 지표, 측정 방법, 합격 기준, 평가자" 열로 구성하면 훈련 후 결과 보고서와 연결하기 쉽습니다. 산사태 대응 훈련이라면 사면 붕괴 신호 감지 시각과 주민 대피 완료 시각 사이의 간격이 주요 평가 지표가 될 수 있습니다.

🔍 현장에서 지켜지지 않을 계획, 어떻게 걸러내나요?

AI가 만든 초안은 논리적으로는 그럴듯하지만 현장 조건을 모릅니다. 초안을 받은 뒤 다음 질문들을 스스로 던져 보세요. 이것이 해봐야 아는 것들입니다.

첫째, "이 시간 안에 실제로 가능한가?" 입니다. 예를 들어 진행표에 "9시 10분 대피 완료"가 있다면, 해당 건물 재실 인원이 계단을 통해 실제로 빠져나오는 데 걸리는 시간을 한 번이라도 측정해 본 적 있는지 확인하세요.

둘째, "담당자가 그날 자리에 있을 수 있는가?" 입니다. 이름이 빈칸인 항목은 실제 담당자를 배정한 뒤 해당 인원의 다른 업무 일정과 충돌하지 않는지 확인해야 합니다.

셋째, "장비가 실제로 준비되어 있는가?" 입니다. AI가 "드론 촬영"이나 "이동식 방송 차량"을 계획에 넣었다면, 기관이 실제로 보유하고 있는지, 예약이 필요한 장비라면 예약이 완료되었는지 따로 확인하세요.

이 세 가지 질문만으로도 AI 초안의 상당 부분이 수정 대상으로 걸러집니다. 대피 경로가 특정 계절이나 기상 조건에서 달라지는 경우도 있으므로, 훈련 당일 예상 날씨와 현장 동선을 함께 검토하는 것이 실무에서 유용합니다.

📝 완성된 초안을 한글 문서(.hwpx)로 만들려면 어떻게 하나요?

AI가 표와 텍스트로 구성된 초안을 내놓으면 두 가지 방법으로 한글 문서를 만들 수 있습니다.

첫 번째는 복사해서 붙여 넣는 방법입니다. AI 대화창에서 초안 전체를 선택해 복사한 뒤, 한글(HWP)을 열고 새 문서에서 붙여넣기를 합니다. 표는 마크다운 형식으로 붙여지는 경우가 많으므로, 한글의 표 > 마크다운 표 변환 기능이 있는 버전을 쓰거나, 표 부분만 따로 복사해 삽입 > 표 삽입 메뉴에서 직접 그린 뒤 셀 내용을 채우는 방식이 깔끔합니다. 버전마다 메뉴 이름이 다를 수 있으므로 한글 공식 도움말을 함께 참고하세요.

두 번째는 일부 AI 도구가 제공하는 문서 내보내기 기능을 활용하는 방법입니다. 특정 도구는 대화 결과를 hwpx 또는 docx 형식으로 직접 내려받을 수 있는 기능을 제공하기도 합니다. 다만 이 기능의 제공 여부와 방식은 도구와 버전에 따라 다르므로 해당 도구의 안내 페이지를 확인하세요. 어떤 방법을 쓰더라도 AI 초안을 그대로 결재에 올리는 것은 금물입니다. 기관명, 담당자 이름, 연락처, 장소명, 날짜는 반드시 실무자가 직접 입력·확인해야 하며, 법령 근거 조항은 소관 부처의 최신 지침을 기준으로 다시 작성해야 합니다.

🖥️ 화면에서 따라하기

따라하기 단계

  1. 기본계획서 준비
    기본계획서 파일을 열고 목적·범위·참가기관·일정 항목을 텍스트로 복사한다
  2. AI 대화창 입력
    대화창 첫 줄에 "아래 기본계획서 범위 안에서만 작성해 주세요"를 쓰고 복사한 텍스트를 바로 붙여 넣는다
  3. 표 구조 요청
    "시간·훈련 단계·담당자·장소·필요 장비·비고 열로 시간대별 진행표를 마크다운 표로 만들어 주세요"를 입력하고 전송한다
  4. 초안 검토
    받은 표에서 시간 간격의 현실성, 장비 보유 여부, 담당자 공란을 한 줄씩 확인한다
  5. 한글 문서 작성
    한글(HWP)을 열고 삽입 > 표 삽입으로 표 틀을 만든 뒤 AI 초안 내용을 셀 단위로 옮겨 입력한다 (메뉴 이름은 버전마다 다를 수 있으므로 한글 도움말 F1을 누른다)
  6. 최종 확인 결재
    기관명·담당자명·연락처·날짜·법령 근거를 실무자가 직접 수정한 뒤 내부 결재 절차를 거친다

※ 프로그램 버전에 따라 메뉴 이름이 조금씩 다를 수 있습니다. 위 그림은 순서를 정리한 도식입니다.

✍️ 그대로 복사해 쓰는 프롬프트

기본계획서 내용을 넘겨주고 실시계획서의 시간대별 진행표와 역할분담표를 표 형태로 받기

당신은 지방자치단체 재난안전 담당자를 돕는 행정 문서 작성 보조자입니다.
아래에 붙여 넣은 내용은 [기관명]이 작성한 안전한국훈련 기본계획서 전문입니다.
이 기본계획서의 범위와 내용을 벗어나지 말고, 아래 두 가지 표를 마크다운 형식으로 만들어 주세요.
기본계획서 내용에 없는 수치나 기관명, 인명은 절대 지어내지 말고 "[현장에서 입력]"으로 표시하세요.
표 1. 시간대별 훈련 진행표
열 구성: 시간 | 훈련 단계 | 주요 활동 내용 | 담당자 | 장소 | 필요 장비 | 비고
훈련 시작 시각은 [훈련 시작 시각]으로 설정하고, 전체 훈련 시간은 [총 훈련 시간]으로 맞추세요.
표 2. 역할분담표
열 구성: 직위 | 성명 | 담당 임무 | 연락 수단 | 대체자
표를 모두 만든 뒤, 현장에서 현실적으로 지키기 어려울 수 있는 항목을 세 가지 이상 별도로 지적해 주세요.
--- 기본계획서 시작 ---
[기본계획서 전문을 여기에 붙여 넣으세요]
--- 기본계획서 끝 ---

AI 초안의 현장 적합성을 검토하기 위한 체크리스트 생성 요청

당신은 재난안전 훈련 실무 경험이 있는 검토자입니다.
아래는 [기관명]의 안전한국훈련 실시계획서 초안입니다.
이 초안을 읽고, 훈련 당일 현장에서 지켜지지 않을 가능성이 높은 항목을 찾아 주세요.
각 항목마다 "문제가 될 수 있는 이유"와 "수정 또는 확인이 필요한 사항"을 함께 써 주세요.
법령 조항이나 지침 번호는 임의로 적지 말고, 확인이 필요하다는 표시만 남겨 주세요.
결과는 번호 목록 형식으로 작성하고, 각 항목은 세 줄 이내로 간결하게 써 주세요.
--- 실시계획서 초안 시작 ---
[실시계획서 초안을 여기에 붙여 넣으세요]
--- 실시계획서 초안 끝 ---

※ 대괄호 부분을 상황에 맞게 바꿔서 쓰세요. 받은 답은 그대로 쓰지 말고 사실 확인을 거치세요.

🧪 직접 해보기

  • 지난 편에서 만든 기본계획서 초안이 있다면, 오늘 프롬프트에 그대로 붙여 넣고 시간대별 진행표를 받아 본다
  • 받은 진행표에서 각 단계 사이 시간 간격을 실제 이동 거리나 인원 규모와 비교해 현실성을 직접 점검해 본다
  • 한글(HWP) 빈 문서에 삽입 > 표 삽입으로 6열짜리 표를 만들고 AI가 준 마크다운 표를 셀 단위로 옮겨 입력해 본다

❓ 자주 묻는 질문

Q. AI가 만든 실시계획서 초안을 그대로 결재에 올려도 되나요?
A. 안 됩니다. AI는 기관의 실제 인력 배치, 장비 보유 현황, 현장 지형을 알지 못하기 때문에 논리적으로는 그럴듯하지만 현장과 맞지 않는 내용이 섞여 있을 수 있습니다. 담당자, 연락처, 장소명, 법령 근거는 반드시 실무자가 직접 확인하고 수정해야 합니다.

Q. 기본계획서가 너무 길어서 AI 대화창에 한 번에 붙여 넣기 어려울 때는 어떻게 하나요?
A. 목적, 훈련 범위, 참가기관, 일정, 역할 분류 항목만 추려서 먼저 입력하고, "이 내용을 기준으로 이후 질문에 답해 주세요"라고 알린 뒤 표 요청을 이어가면 됩니다. 다만 세션이 길어지면 AI가 앞 내용을 덜 반영할 수 있으므로 중요한 제약 조건은 각 질문마다 한 줄씩 다시 상기시켜 주는 것이 좋습니다.

Q. 안전한국훈련 실시계획서에 반드시 들어가야 하는 항목이 정해져 있나요?
A. 소관 부처의 훈련 지침과 해당 연도 공고에서 서식과 필수 항목을 정합니다. 해마다 지침이 바뀔 수 있으므로, 훈련 전에 반드시 최신 공고를 확인하고 그 서식 기준에 맞춰 문서를 작성하세요. AI 초안은 그 기준을 채우기 위한 보조 도구로 활용하는 것이 적절합니다.

실시계획서는 작성보다 검토에 더 많은 시간이 걸립니다. AI는 틀을 빠르게 잡아 주지만, 그 틀이 실제 현장과 맞는지는 사람이 확인해야 합니다. 기본계획서를 그대로 물려주는 습관, 열 이름을 지정해서 표를 받는 습관, 받은 초안에 세 가지 검토 질문을 던지는 습관이 쌓이면 훈련 문서 작성에 드는 시간을 실질적으로 줄일 수 있습니다. 다음 편에서는 훈련이 끝난 뒤 결과 보고서와 미흡사항 개선 계획서를 AI와 함께 정리하는 방법을 다룰 예정입니다. 훈련 결과 데이터를 어떻게 정리해야 다음 훈련 기획에 쓸 수 있을지 궁금하다면 계속 지켜봐 주세요.

안전한국훈련 실무 시리즈 2편 · 전체 9편


재난안전과 GeoAI 이야기를 더 보고 싶다면 아래 채널도 함께 보세요.

📌 바로가기

2026-09-25

토지피복 분류 | 위성으로 땅의 쓰임을 읽는 법 | GeoAI 기초 11편

토지피복 분류 | 위성으로 땅의 쓰임을 읽는 법 | GeoAI 기초 11편

📌 3줄 요약

  • 위성영상으로 땅의 쓰임새를 구분하는 것이 토지피복 분류다.
  • 불투수면 비율은 홍수 유출량 예측의 핵심 입력값으로 쓰인다.
  • 혼동행렬과 카파 계수로 분류 결과의 신뢰도를 숫자로 확인한다.

재난 대응 부서에서 홍수 피해를 예측하려면 "이 유역의 땅이 얼마나 빗물을 흡수하는가"를 먼저 알아야 합니다. 그런데 현장을 일일이 걸어 다닐 수는 없으니, 위성이 찍은 영상을 보고 숲인지, 논밭인지, 아스팔트인지를 구분하는 작업이 필요합니다. 이것이 토지피복 분류입니다.

토지피복 분류는 픽셀 하나하나에 "이 땅은 무엇으로 덮여 있는가"라는 꼬리표를 붙이는 작업입니다. 꼬리표의 종류는 목적에 따라 달라지는데, 재난 분야에서는 도시(불투수면), 식생, 수계, 나지, 농지처럼 물의 흐름과 직결되는 항목으로 나누는 경우가 많습니다. 이 편에서는 분류의 원리, 불투수면과 유출계수의 관계, 그리고 결과의 신뢰도를 어떻게 따지는지까지 차근차근 살펴보겠습니다.

🗺️ 토지피복 분류가 정확히 무엇인가요?

토지피복(land cover)은 땅 표면이 실제로 무엇으로 덮여 있는지를 가리킵니다. 건물·도로처럼 사람이 만든 것, 숲·초지·논처럼 식생이 덮인 것, 강·호수 같은 수면, 흙이나 모래가 드러난 나지 등이 대표적인 항목입니다. 이를 위성영상의 픽셀 단위로 구분하는 것이 토지피복 분류입니다.

비슷한 개념으로 토지이용(land use)이 있는데, 이것은 사람이 그 땅을 어떤 목적으로 쓰는가를 뜻합니다. 같은 녹지라도 공원으로 지정된 곳과 방치된 빈터는 토지이용 측면에서 다르지만, 위성이 보는 표면 반사율은 비슷할 수 있습니다. 분류 결과를 해석할 때 이 차이를 알고 있으면 헷갈리지 않습니다.

분류 방법은 크게 두 갈래입니다. 전문가가 직접 픽셀의 밝기 범위를 정해 구분하는 규칙 기반 방식, 그리고 학습 데이터를 주고 알고리즘이 패턴을 찾게 하는 기계학습 방식입니다. 홍수나 산불 직후 빠르게 피해 범위를 파악할 때는 두 방식을 함께 쓰는 경우도 많습니다.

💧 불투수면과 유출계수는 왜 중요한가요?

불투수면(impervious surface)은 빗물이 스며들지 못하는 표면, 즉 아스팔트·콘크리트·지붕 같은 면을 뜻합니다. 비가 같은 양이 내려도 불투수면이 많을수록 지면 아래로 흡수되지 않고 하천으로 빠르게 몰리는 빗물의 양이 늘어납니다.

유출계수는 강수량 중 실제로 지표를 흘러 하천에 도달하는 비율입니다. 예를 들어 숲은 유출계수가 낮고, 포장도로는 높습니다. 홍수 수문 모형에서 이 계수를 설정할 때 토지피복 분류 결과가 직접 입력됩니다. 도시화가 진행될수록 불투수면 비율이 올라가고, 같은 비가 내려도 첨두유량(강이 가장 높이 불어나는 시점의 유량)이 커지는 이유가 여기 있습니다.

도심 속 내수 침수 취약 지역을 찾거나, 개발 예정지의 홍수 영향을 사전에 평가할 때 토지피복 분류로 산출한 불투수면 비율은 핵심 수치로 활용됩니다.

🤖 위성영상을 어떻게 분류 결과로 만드나요?

분류 과정은 크게 세 단계로 볼 수 있습니다. 첫째, 위성영상을 준비합니다. 광학영상이라면 밴드별 반사율 값이 입력 데이터가 됩니다. 여기에 NDVI(식생지수)나 NDWI(수분지수) 같은 파생 지표를 추가하면 분류 성능이 높아지는 경우가 많습니다(NDVI·NDWI에 대한 자세한 내용은 이 시리즈 4편을 참고하세요).

둘째, 학습 샘플을 만듭니다. 각 항목(도시, 숲, 논, 수계 등)에 해당하는 픽셀을 직접 골라 꼬리표를 붙이는 작업입니다. 9편에서 다룬 라벨링 과정과 같습니다. 샘플의 수와 균형이 결과 품질을 크게 좌우합니다.

셋째, 알고리즘을 돌려 나머지 픽셀에 항목을 배정합니다. 랜덤 포레스트(Random Forest, 여러 개의 결정 트리를 만들어 다수결로 분류하는 기계학습 기법)는 위성영상 분류에서 안정적인 성능을 보여 실무에서 자주 쓰입니다. Google Earth Engine에서는 다음처럼 간단히 호출할 수 있습니다.

var classifier = ee.Classifier.smileRandomForest(100)
  .train({
    features: trainingData,
    classProperty: 'landcover',
    inputProperties: bands
  });
var classified = image.classify(classifier);

이 코드에서 100은 트리 개수, trainingData는 앞서 만든 학습 샘플입니다.

📊 분류 결과가 맞는지 어떻게 확인하나요?

분류를 마쳤다고 바로 쓰면 안 됩니다. 결과가 실제와 얼마나 맞는지를 확인하는 단계가 반드시 필요합니다. 이때 쓰는 도구가 혼동행렬(confusion matrix, 예측 항목과 실제 항목을 표로 맞대어 얼마나 헷갈렸는지 보는 표)입니다.

표의 가로축은 분류 알고리즘이 예측한 항목, 세로축은 실제로 확인된 항목입니다. 대각선이 정확히 맞은 경우고, 나머지 칸은 틀린 경우입니다. 예를 들어 '논'으로 예측했는데 실제로는 '습지'였다면, 그 칸의 수가 클수록 두 항목을 혼동하고 있다는 신호입니다.

전체 정확도(overall accuracy)는 모든 픽셀 중 맞게 분류된 비율입니다. 그런데 항목별 샘플 수가 극단적으로 차이 나면 전체 정확도만으로는 판단이 어렵습니다. 이를 보완하기 위해 카파 계수(Kappa coefficient)를 씁니다. 카파는 0에서 1 사이 값으로, 우연히 맞을 확률을 제외한 뒤 실제 성능을 나타냅니다. 도구에 따라 다르지만 0.8 이상이면 통상적으로 신뢰할 만한 수준으로 봅니다.

해봐야 아는 것이 있습니다. 정확도 수치보다 혼동행렬의 어떤 항목끼리 자주 헷갈리는지를 먼저 봐야 합니다. 재난 분석에서는 불투수면과 나지를 혼동하거나, 수계와 그늘진 경사면을 혼동하는 오류가 자주 나타납니다. 이런 오류가 어느 방향으로 발생하는지 확인한 뒤, 그 항목의 학습 샘플을 보완하거나 분류 후 검토 과정을 추가해야 결과를 신뢰할 수 있습니다.

🏙️ 도시화 모니터링과 재난 대응에는 어떻게 쓰이나요?

토지피복 분류의 실제 쓰임은 단순히 지도 한 장을 만드는 것에 그치지 않습니다. 여러 시점의 분류 결과를 비교하면 어느 지역이 얼마나 빠르게 도시화되었는지를 확인할 수 있습니다. 논이었던 곳이 10년 뒤 공장 부지가 됐다면, 그 면적만큼 불투수면이 늘고 인근 하천의 홍수 위험도가 높아졌다는 뜻입니다.

산사태 위험 지역에서는 산림 피복이 얼마나 건강한지, 벌채나 산불로 나지가 늘었는지를 분류 결과로 주기적으로 확인합니다. 산불 이후 지표가 드러나면 다음 우기에 토사가 쏟아질 가능성이 커지기 때문에, 분류 결과는 사전 대피 계획의 근거 자료로도 씁니다.

분류 결과를 지자체 방재 부서에서 사용할 때는, 지도가 만들어진 시점과 현재 시점 사이에 개발이나 자연 변화가 없었는지 반드시 현장 확인이나 최신 항공사진과 대조해야 합니다. 지도가 아무리 정확해도 시간 차이가 있으면 의사결정에 오류가 생길 수 있습니다.

🖥️ 화면에서 따라하기

따라하기 단계

  1. 영상 불러오기
    Google Earth Engine 코드 편집기에서 ee.ImageCollection을 이용해 분석할 위성영상을 불러오고 Map.addLayer로 화면에 표시한다.
  2. 학습 샘플 그리기
    코드 편집기 왼쪽 패널 상단 도형 도구(점 아이콘)를 선택 후, 항목별로 관심 영역(ROI)을 클릭해 그린다. 각 ROI에 landcover 속성값(예: 0=도시, 1=식생)을 입력한다.
  3. 밴드·지표 선택
    분류에 쓸 밴드 목록을 bands 변수에 배열로 지정한다. NDVI를 추가할 경우 image.normalizedDifference(['B8','B4']).rename('ndvi')로 계산 후 합친다.
  4. 분류 실행
    ee.Classifier.smileRandomForest(100).train(...)으로 모델을 학습시키고, image.classify(classifier)로 전체 영상에 분류를 적용한 뒤 addLayer로 결과를 시각화한다. 메뉴 이름은 GEE 버전에 따라 다를 수 있으니 공식 문서(developers.google.com/earth-engine)에서 최신 함수명을 확인한다.
  5. 정확도 평가
    validationData.classify(classifier)로 검증 샘플을 분류한 뒤 ee.ConfusionMatrix를 호출한다. 결과 객체에서 .accuracy()와 .kappa() 메서드로 수치를 출력해 확인한다.
  6. 오류 항목 검토
    혼동행렬 출력값에서 대각선 외 수치가 큰 항목을 찾아 해당 픽셀이 영상에서 어느 지역인지 Map.addLayer로 직접 눈으로 확인하고, 학습 샘플을 추가 수집할지 결정한다.

※ 프로그램 버전에 따라 메뉴 이름이 조금씩 다를 수 있습니다. 위 그림은 순서를 정리한 도식입니다.

✍️ 그대로 복사해 쓰는 프롬프트

토지피복 분류 결과를 바탕으로 홍수 위험 보고서 초안의 관련 문단을 작성할 때 쓴다.

당신은 방재 분야 보고서 작성을 돕는 전문 보조자입니다.
아래 조건에 맞는 보고서 문단을 작성해 주세요.

[기관명]에서 작성하는 [대상 지역] 홍수 위험 분석 보고서에 들어갈 토지피복 현황 문단입니다.
분류 결과 요약: [분류 항목별 면적 비율, 예: 도시 42%, 식생 30%, 농지 18%, 수계 10%]
분석 목적: 불투수면 비율 산출 및 유출계수 추정
요구 형식: 300자 내외, 공문서 문체, 수치는 반드시 포함
하지 말아야 할 것: 확인되지 않은 수치를 만들어 내지 말 것, 결과를 과장하지 말 것
작성 후 사람이 확인해야 할 항목: 분류 시점과 현장 상황의 일치 여부, 항목별 면적 단위 오류

토지피복 분류의 혼동행렬 수치를 해석하는 방법을 쉽게 설명받을 때 쓴다.

당신은 GIS 초보자에게 공간분석 개념을 쉽게 설명하는 교육 도우미입니다.
아래 혼동행렬 결과를 보고 다음을 설명해 주세요.

혼동행렬: [행렬 수치를 여기에 붙여 넣으세요]
전체 정확도: [수치]
카파 계수: [수치]

설명 요청 항목:
1. 어떤 항목끼리 가장 많이 혼동됐는지
2. 그 혼동이 재난 분석에서 어떤 문제를 일으킬 수 있는지
3. 개선을 위해 어떤 조치를 취할 수 있는지
형식: 항목별 2~3문장, 중학생도 이해할 수 있는 말로, 수치는 그대로 인용
하지 말아야 할 것: 수치를 임의로 바꾸거나 행렬에 없는 결과를 지어내지 말 것

※ 대괄호 부분을 상황에 맞게 바꿔서 쓰세요. 받은 답은 그대로 쓰지 말고 사실 확인을 거치세요.

🧪 직접 해보기

  • Google Earth Engine 코드 편집기(code.earthengine.google.com)에서 공개된 토지피복 데이터셋(예: ESA WorldCover)을 불러와 특정 지역의 항목별 면적 비율을 직접 계산해 본다.
  • QGIS에서 기 제작된 공개 토지피복 래스터를 불러온 뒤, 래스터 > 래스터 분석 > 래스터 계층 통계로 항목별 픽셀 수를 확인하고, 불투수면 항목의 비율을 계산해 본다.
  • 혼동행렬 계산이 낯설다면, 손으로 2×2 표(도시/비도시 두 항목)를 그리고 임의의 숫자를 채워 전체 정확도와 카파 계수를 직접 계산해 보면 개념이 빠르게 잡힌다.

❓ 자주 묻는 질문

Q. 토지피복 분류와 시맨틱 분할(semantic segmentation)은 같은 건가요?
A. 결과는 비슷하지만 맥락이 다릅니다. 시맨틱 분할은 딥러닝 분야의 용어로, 픽셀마다 항목을 예측하는 신경망 구조를 가리킵니다. 토지피복 분류는 GIS·원격탐사 분야의 용어로, 방법론을 특정하지 않고 목적(땅의 피복 항목 구분)을 가리킵니다. 딥러닝으로 토지피복 분류를 수행하면 두 개념이 겹칩니다.

Q. 카파 계수가 높으면 분류 결과를 그냥 써도 되나요?
A. 높은 카파 계수는 좋은 신호지만 충분조건은 아닙니다. 학습 샘플과 검증 샘플이 같은 지역에서 추출됐다면 실제 현장에서의 성능은 더 낮을 수 있습니다. 또한 카파가 높아도 특정 항목(예: 불투수면과 나지)의 혼동이 집중적으로 발생할 수 있으므로, 혼동행렬의 세부 항목을 함께 확인해야 합니다.

Q. 무료로 쓸 수 있는 토지피복 데이터가 있나요?
A. 공개된 글로벌 토지피복 데이터는 여러 기관에서 제공하고 있습니다. 해상도, 갱신 주기, 항목 체계가 데이터마다 다르므로, 분석 목적에 맞는 항목이 있는지, 원하는 지역과 시점이 포함되는지를 먼저 확인하는 것이 좋습니다. 각 데이터의 이용 조건과 정책은 제공 기관 사이트에서 직접 확인해야 합니다.

위성영상으로 땅의 쓰임을 읽는 토지피복 분류는 단순한 지도 만들기가 아닙니다. 홍수 예측 모형에 넣을 불투수면 비율을 계산하고, 산사태 위험 지역의 산림 상태를 주기적으로 감시하며, 개발로 인한 변화를 시계열로 추적하는 일까지, 재난 대응의 여러 단계에서 실질적인 입력값을 제공합니다. 정확도 평가를 생략하고 분류 지도를 그대로 쓰는 것은, 오차가 어느 방향으로 얼마나 있는지 모른 채 의사결정을 내리는 것과 같습니다. 혼동행렬을 보는 습관을 들이는 것만으로도 분석 결과의 신뢰도를 한 단계 높일 수 있습니다. 다음 편에서는 토지피복 분류 결과를 시간 축으로 이어 붙여 변화 탐지를 수행하는 방법, 즉 "같은 장소의 두 장의 지도로 무엇이 달라졌는지를 자동으로 찾는 방법"을 살펴보겠습니다.

GeoAI 기초 시리즈 11편 · 전체 43편


재난안전과 GeoAI 이야기를 더 보고 싶다면 아래 채널도 함께 보세요.

📌 바로가기

위성영상에 딥러닝을 쓰면 | 분류·탐지·분할의 차이 | GeoAI 기초 10편

위성영상에 딥러닝을 쓰면 | 분류·탐지·분할의 차이 | GeoAI 기초 10편

🎬 1분 브리핑 영상

📌 3줄 요약

  • 영상 분류·객체 탐지·의미론적 분할은 각각 '무엇인가·어디 있나·어디까지인가'에 답한다.
  • 세 기법은 산출물 형태가 다르므로 재난 판독 목적에 맞게 골라야 한다.
  • 목적 없이 정확도만 높은 모델을 쓰면 실무에서 쓸 수 없는 결과가 나온다.

홍수가 지나간 뒤 위성사진을 열어 두고 "이 사진에 딥러닝을 쓰면 침수 면적을 자동으로 뽑을 수 있지 않을까?"라는 생각을 해본 적 있으신가요? 맞습니다. 할 수 있습니다. 그런데 딥러닝으로 위성영상을 분석하는 방법이 한 가지가 아니라는 점이 금방 벽이 됩니다.

영상 분류(Image Classification), 객체 탐지(Object Detection), 의미론적 분할(Semantic Segmentation). 이름은 비슷해 보이지만 각각이 답하는 질문이 다르고, 결과물의 생김새도 전혀 다릅니다. 어떤 걸 써야 할지 모르고 모델을 돌리면, 정확도는 높아도 실제 업무에 붙이기 어려운 결과가 나옵니다. 이번 글에서는 세 기법이 각각 어떤 질문에 답하는지, 재난 판독 상황에서 무엇을 골라야 하는지를 원리부터 차근차근 짚어 보겠습니다.

🖼️ 영상 분류는 어떤 질문에 답하나요?

영상 분류는 사진 한 장(또는 타일 한 조각)을 보고 "이게 뭐야?"라는 질문에 레이블 하나로 답합니다. 예를 들어 위성영상을 256×256 픽셀짜리 조각으로 잘라 낸 뒤, 각 조각에 '침수됨' 또는 '정상'이라는 꼬리표를 붙이는 방식입니다. 산출물은 조각마다 붙는 클래스 이름과 확률 숫자 하나입니다. 공간적으로 보면 조각 전체를 하나로 취급하기 때문에, 침수 영역이 정확히 어디에서 어디까지인지는 알 수 없습니다. 구현 난도가 가장 낮고 학습 데이터도 가장 적게 필요하다는 장점이 있습니다. 재난 판독에서는 "이 타일이 산사태 영향권에 드는가?"처럼 빠른 1차 선별이 필요할 때 유용합니다. 다만 이후에 행정 구역 면적이나 피해 지도를 만들려면 다른 기법이 추가로 필요합니다.

📦 객체 탐지는 영상 분류와 어떻게 다른가요?

객체 탐지는 "이게 뭐야?"에 더해 "어디 있어?"까지 한꺼번에 답합니다. 결과물은 사각형 박스(바운딩 박스)와 그 안에 담긴 클래스 이름, 신뢰도 점수입니다. 위성영상에서 이재민 임시 텐트, 고립된 차량, 무너진 건물 한 채 한 채를 찾아내는 데 적합합니다. 단, 박스는 사각형이기 때문에 범람 경계나 산불 연소 경계처럼 불규칙한 면적을 정밀하게 표현하기는 어렵습니다. 또한 같은 크기로 찍힌 객체끼리는 잘 잡아내지만, 건물이 빽빽이 붙어 있으면 박스끼리 겹쳐 개수 집계가 틀릴 수 있습니다. 재난 현장에서는 피해 건물 수를 신속하게 세야 할 때 이 기법을 선택합니다. 결과 박스를 GIS 소프트웨어에서 불러와 건물 레이어와 공간 조인하면 피해 건물 목록을 자동으로 뽑을 수 있습니다.

🗺️ 의미론적 분할은 어떤 상황에서 써야 하나요?

의미론적 분할은 영상의 모든 픽셀에 클래스 이름을 붙이는 방식입니다. "이 픽셀은 물, 저 픽셀은 도로, 그 픽셀은 건물"처럼요. 결과물은 원본 영상과 크기가 같은 마스크 이미지이고, GIS에서 벡터로 변환하면 침수 면적·산불 연소 면적·산사태 흔적 면적을 제곱미터 단위로 계산할 수 있습니다. 세 기법 중 가장 상세한 공간 정보를 주지만, 그만큼 픽셀 단위 라벨링 데이터가 많이 필요하고 학습 시간도 깁니다. 재난 피해 면적 산출, 대피 우선순위 구역 지도 제작처럼 '경계선이 중요한 업무'에 적합합니다. 홍수 침수 지도나 산불 피해 지도를 공식 보고서에 쓸 때는 이 기법의 결과물이 가장 직접적으로 활용됩니다.

🤔 세 기법 중 무엇을 골라야 할지 어떻게 판단하나요?

목적을 먼저 적어 보는 것이 가장 빠른 판단 방법입니다. "피해 지역인지 아닌지만 알면 된다" → 영상 분류, "피해 건물이 몇 동이고 어디 있는지 알고 싶다" → 객체 탐지, "침수 경계선과 면적이 필요하다" → 의미론적 분할로 연결됩니다. 해봐야 아는 부분이 여기서 생깁니다. 실제로 시험 영상 10~20장을 각 기법으로 돌려 보고, 결과물을 현장 사진이나 피해 보고서와 눈으로 대조해 보세요. 경계선이 실제 침수 경계와 얼마나 맞는지, 건물 박스가 실제 피해 건물을 잡아내는지를 직접 확인하기 전에는 어느 기법이 더 나은지 단정할 수 없습니다. 도구의 버전에 따라 지원 모델 목록이 달라질 수 있으니, 사용하는 라이브러리의 공식 문서에서 최신 모델 목록을 확인하는 것도 잊지 마세요.

🔥 재난 판독 실무에서 세 기법을 어떻게 조합하나요?

실무에서는 한 가지 기법만 쓰는 경우보다 단계별로 조합해 쓰는 경우가 많습니다. 예를 들어 광역 위성영상 전체를 영상 분류로 빠르게 스캔해 피해 가능성이 높은 타일을 걸러낸 뒤, 해당 타일에만 의미론적 분할을 적용해 정밀 경계선을 뽑는 방식입니다. 산불 대응이라면, 연소 경계를 의미론적 분할로 뽑고 그 안에서 잔존 건물을 객체 탐지로 찾아내 대피 지원 우선순위를 정하기도 합니다. 조합 방식은 영상 해상도, 확보할 수 있는 라벨 데이터의 양, 결과를 사용할 부서의 요구 형식에 따라 달라집니다. 한 기법만으로 모든 것을 해결하려 하면 결과물이 현장에서 활용되지 못하는 경우가 많으므로, 최종 산출물 형식(면적 수치인지, 건물 목록인지, 지도 레이어인지)을 먼저 정해 두고 기법을 역순으로 선택하는 것이 실용적입니다.

🖥️ 화면에서 따라하기

따라하기 단계

  1. 모델 선택 확인
    Roboflow Universe(universe.roboflow.com) 접속 > 검색창에 [flood segmentation] 입력 > 결과 목록에서 Task 필터를 Object Detection / Semantic Segmentation으로 바꿔 가며 결과물 차이 확인
  2. 샘플 영상 준비
    공개 홍수 영상(Copernicus EMS 등 공개 포털)에서 GeoTIFF 1장 내려받기
  3. 분류 모델 실행
    Google Colab 새 노트북 열기 > 셀에 아래 코드 붙여넣기 후 런타임 > 모두 실행
  4. ```python
    ```python
  5. # torchvisio
    # torchvision 기반 간단 분류 예시 (GPU 없어도 동작)
  6. from torchvi
    from torchvision import models, transforms
  7. from PIL imp
    from PIL import Image
  8. import torch
    import torch
  9. model = mode
    model = models.resnet18(weights="IMAGENET1K_V1")
  10. model.eval()
    model.eval()
  11. img = Image.
    img = Image.open("flood_tile.jpg").convert("RGB")
  12. transform =
    transform = transforms.Compose([
  13. transforms.R
    transforms.Resize((224, 224)),
  14. transforms.T
    transforms.ToTensor()
  15. ])
    ])
  16. out = model(
    out = model(transform(img).unsqueeze(0))
  17. print("Top-1
    print("Top-1 class index:", out.argmax().item())
  18. ```
    ```
  19. 결과 비교
    같은 영상을 분류(위 코드)·탐지(YOLO 계열 온라인 데모)·분할(Segment Anything 데모) 순으로 돌려 산출물 형태를 나란히 메모장에 적어 비교
  20. 목적 매핑
    메모장에 '내가 필요한 최종 산출물' 한 줄 적기 > 면적·경계선이면 분할, 개수·위치면 탐지, 있다/없다이면 분류로 연결되는지 스스로 확인
  21. 버전 확인
    메뉴·모델 이름은 라이브러리 버전마다 다를 수 있으니 Roboflow·PyTorch 공식 문서의 Changelog 탭에서 현재 버전 기준 목록을 먼저 확인

※ 프로그램 버전에 따라 메뉴 이름이 조금씩 다를 수 있습니다. 위 그림은 순서를 정리한 도식입니다.

✍️ 그대로 복사해 쓰는 프롬프트

재난 판독 과제에서 세 기법 중 어떤 것을 써야 할지 AI에게 조언을 구할 때 사용

나는 [기관명]에서 [대상 재난(예: 홍수·산불·산사태)] 피해 판독을 담당하는 담당자야.
보유한 위성영상은 [영상 종류(예: 광학 10m 해상도 GeoTIFF)]이고,
최종적으로 필요한 산출물은 [원하는 결과(예: 침수 경계선 벡터 레이어 / 피해 건물 수 목록 / 피해 구역 여부 분류)]야.
영상 분류, 객체 탐지, 의미론적 분할 중 어느 기법이 이 목적에 가장 적합한지 이유와 함께 알려줘.
답변 형식: 1) 추천 기법 2) 추천 이유 3) 주의해야 할 한계 4) 라벨 데이터 최소 요구량 추정
확인되지 않은 수치나 특정 제품 성능은 단정하지 말고, 일반론으로 설명해 줘.

세 기법의 차이를 상사나 동료에게 보고용으로 정리할 때 사용

너는 GIS와 인공지능을 처음 접하는 공무원에게 설명하는 전문가야.
영상 분류, 객체 탐지, 의미론적 분할의 차이를 아래 표 형식으로 정리해 줘.
열 항목: 기법 이름 / 답하는 질문 / 산출물 형태 / 재난 판독 활용 예시 / 주요 한계
행은 세 기법 각각 하나씩.
전문용어는 처음 나올 때 괄호 안에 한 줄 설명을 붙여 줘.
[추가 맥락이 있으면 여기에 적기]

※ 대괄호 부분을 상황에 맞게 바꿔서 쓰세요. 받은 답은 그대로 쓰지 말고 사실 확인을 거치세요.

🧪 직접 해보기

  • Roboflow Universe(universe.roboflow.com)에서 'flood'로 검색한 뒤 Task 필터를 세 가지로 바꿔 가며 각 기법의 결과물 화면을 직접 비교해 보세요.
  • Google Colab에서 Segment Anything Model(SAM) 공개 데모 노트북을 열고 홍수 위성 이미지 한 장을 올려 픽셀 단위 분할 결과가 어떻게 나오는지 확인해 보세요.
  • 종이나 메모장에 '내 업무의 최종 산출물'을 한 줄로 적은 뒤, 이 글의 판단 기준에 따라 세 기법 중 하나를 골라 보고 그 이유를 두 문장으로 써 보세요.

❓ 자주 묻는 질문

Q. 의미론적 분할이 가장 정밀하다면 항상 그것만 쓰면 되지 않나요?
A. 의미론적 분할은 픽셀 단위 라벨 데이터가 많이 필요하고 학습·추론 시간도 깁니다. 빠른 1차 선별이나 건물 개수 파악이 목적이라면 오히려 더 단순한 기법이 시간과 비용 면에서 유리합니다.

Q. 객체 탐지 결과의 바운딩 박스를 GIS에서 면적으로 변환할 수 있나요?
A. 박스 자체의 면적을 계산할 수는 있지만, 박스 안에는 배경 픽셀도 포함되어 실제 피해 면적과 차이가 납니다. 정확한 면적이 필요하다면 의미론적 분할 결과를 폴리곤으로 변환해 사용하는 것이 적합합니다.

Q. 세 기법 모두 학습 데이터 없이 쓸 수 있나요?
A. 사전 학습된 모델을 그대로 쓰는 경우에는 별도 학습 데이터 없이도 작동합니다. 다만 재난 위성영상처럼 특수한 도메인에서는 사전 학습 모델의 성능이 기대에 못 미치는 경우가 많아, 도메인에 맞는 데이터로 추가 학습(파인튜닝)을 거치는 것이 일반적입니다.

위성영상에 딥러닝을 적용할 때 가장 먼저 해야 할 일은 모델을 고르는 것이 아니라 최종 산출물을 정하는 것입니다. 침수 면적인지, 피해 건물 수인지, 아니면 단순한 피해 여부인지에 따라 기법이 달라지고, 기법이 달라지면 필요한 학습 데이터의 종류와 양도 달라집니다. 세 기법의 원리를 이해해 두면 현장에서 "이 모델 써보면 어떨까요?"라는 질문에 막히지 않고 "우리 목적에는 어느 기법이 맞는지"로 대화를 이끌 수 있습니다. 다음 편에서는 이 중 실제 재난 판독에 가장 많이 쓰이는 의미론적 분할 모델을 어떻게 학습시키고, 결과 마스크를 GIS 레이어로 변환하는지를 다룰 예정입니다. "마스크 이미지를 폴리곤으로 바꾸려면 어떻게 하나요?"라는 질문, 다음 편에서 바로 풀어 드리겠습니다.

GeoAI 기초 시리즈 10편 · 전체 43편


재난안전과 GeoAI 이야기를 더 보고 싶다면 아래 채널도 함께 보세요.

📌 바로가기

2026-09-24

공간 AI의 학습 데이터는 어떻게 만드나 | 라벨링과 품질 | GeoAI 기초 9편

📌 3줄 요약

  • 위성·드론 영상 라벨링에는 점·폴리곤·마스크 세 방식이 있고 목적에 따라 선택한다.
  • 클래스 불균형과 특정 지역 편향은 모델 성능을 조용히 무너뜨리는 주요 원인이다.
  • 좋은 학습 데이터는 양보다 일관성과 다양성, 그리고 명확한 라벨 기준에서 나온다.

홍수 피해 건물을 자동으로 탐지하는 AI 모델을 만들었는데, 실제 재난 현장에서 돌려보니 엉뚱한 곳을 피해 건물로 잡아내거나 명백한 침수 지역을 그냥 지나치는 일이 생깁니다. 알고리즘 문제일까요? 꼭 그렇지는 않습니다. 모델을 훈련할 때 쓴 데이터 자체에 문제가 있었을 가능성이 높습니다.

공간 AI 모델은 사람이 직접 정답을 표시해 준 영상, 즉 라벨링된 데이터를 보고 패턴을 익힙니다. 라벨이 부정확하거나, 특정 상황만 잔뜩 포함되어 있거나, 한 지역 데이터만 쓰였다면 모델은 그 편향을 그대로 배웁니다. 이번 글에서는 위성·드론 영상에 라벨을 붙이는 방법, 데이터가 가질 수 있는 구조적 문제, 그리고 실무에서 쓸 만한 데이터셋이 갖춰야 할 조건을 하나씩 짚어 보겠습니다.

🗺️ 라벨링 방식은 왜 세 가지나 되나요?

라벨링이란 AI 모델이 '무엇이 무엇인지' 배울 수 있도록 영상 위에 정답 표시를 남기는 작업입니다. 위성·드론 영상에서는 크게 점(Point), 폴리곤(Polygon), 픽셀 마스크(Pixel Mask) 세 가지 방식을 씁니다.

점 라벨링은 건물 중심이나 나무 위치처럼 '이 근처에 무언가 있다'는 위치 정보만 기록합니다. 빠르게 작업할 수 있지만 크기나 경계는 알 수 없습니다. 폴리곤 라벨링은 건물 외곽선을 직접 따라 그려 면적과 형태 정보를 남깁니다. 픽셀 마스크(시맨틱 세그멘테이션용 라벨로, 영상의 픽셀 하나하나에 클래스 번호를 부여하는 방식)는 가장 정밀하지만 작업 시간도 가장 많이 걸립니다. 산사태 피해 범위나 홍수 침수 면적처럼 경계가 불규칙한 대상은 픽셀 마스크로 라벨링해야 모델이 실제 형태를 제대로 학습합니다.

🏗️ 폴리곤을 그릴 때 어디까지 따라야 올바른 라벨인가요?

라벨링 도구(QGIS, CVAT, Label Studio 등)를 열면 영상 위에 직접 폴리곤을 그릴 수 있습니다. 문제는 '얼마나 꼼꼼하게 따야 하는가'입니다. 건물 라벨이라면 처마 끝까지 포함할지, 그림자를 제외할지처럼 세부 기준이 없으면 작업자마다 결과가 달라집니다. 이것이 바로 '해봐야 아는 것'입니다. 같은 영상을 두 사람에게 라벨링시킨 뒤 두 결과물을 겹쳐 보면 일치율(IoU, Intersection over Union — 두 영역이 겹치는 넓이를 합친 넓이로 나눈 값)을 수치로 확인할 수 있습니다. IoU가 0.7에 못 미친다면 라벨 기준 문서가 더 구체적이어야 한다는 신호입니다. 재난 대응에서는 같은 건물을 '피해'로 볼지 '심각 피해'로 볼지 기준이 흔들리면 모델이 두 클래스를 구분하지 못하게 됩니다.

⚖️ 클래스 불균형이 모델을 어떻게 망가뜨리나요?

재난 영상에는 피해를 입은 건물보다 정상 건물이 압도적으로 많습니다. 예를 들어 피해 건물이 전체의 5%뿐이라면, 모델이 모든 건물을 '정상'으로 분류해도 정확도는 95%가 나옵니다. 숫자만 보면 훌륭해 보이지만 실제로는 피해 건물을 하나도 탐지하지 못한 것입니다.

이를 클래스 불균형 문제라고 합니다. 해결 방법은 여러 가지입니다. 소수 클래스 샘플을 인위적으로 늘리는 오버샘플링, 손실 함수에 가중치를 달리 주는 방식(Focal Loss 등), 또는 피해 사례를 더 많이 수집하는 원천적 접근이 있습니다. 홍수·산불 피해 탐지 모델을 만들 때 재현율(Recall — 실제 피해 중 모델이 맞춘 비율)을 정밀도(Precision)만큼 반드시 점검해야 하는 이유가 여기에 있습니다.

🌏 지역 편향이란 무엇이고 왜 생기나요?

학습 데이터가 특정 나라나 기후대의 영상에만 쏠려 있으면 모델은 그 지역의 시각적 특성에 최적화됩니다. 예를 들어 유럽 도시의 건물 영상으로만 학습한 모델은 한국의 붉은 지붕 단독주택이나 동남아시아의 판자촌을 제대로 분류하지 못할 수 있습니다. 이것이 지역 편향입니다.

계절과 식생도 같은 문제를 만듭니다. 여름 녹음이 우거진 영상으로만 학습했다면, 겨울 낙엽 상태의 같은 지역에서 모델 성능이 크게 떨어집니다. 국내 재난 대응 모델을 만들 때 해외 공개 데이터셋을 그대로 쓰면 안 되는 핵심 이유가 여기 있습니다. 국내 다양한 지형과 계절을 반영한 데이터를 별도로 수집하거나 파인튜닝(기존 모델을 새 데이터로 추가 학습하는 과정)을 거쳐야 합니다.

✅ 좋은 학습 데이터셋은 어떤 조건을 갖춰야 하나요?

좋은 데이터셋은 세 가지 조건을 충족합니다. 첫째, 라벨 기준이 문서화되어 있어야 합니다. '침수 건물'의 정의, 라벨 경계 처리 방법, 애매한 케이스 판단 예시가 기록으로 남아 있어야 다른 사람도 일관되게 작업할 수 있습니다. 둘째, 클래스와 지역·계절이 고루 분포해야 합니다. 숫자만 많은 것은 의미가 없고, 모델이 마주칠 실제 환경을 다양하게 포함해야 합니다. 셋째, 검수 이력이 있어야 합니다. 라벨링 담당자 외에 검수자가 따로 있고, 수정 내역이 버전으로 관리되면 신뢰도가 높아집니다. 재난 분야에서는 현장 전문가(소방, 토목, 기상 등)와 라벨러가 협력해 기준을 잡는 것이 데이터 품질을 높이는 가장 현실적인 방법입니다.

🖥️ 화면에서 따라하기

  1. QGIS 설치 확인
    QGIS 공식 사이트(qgis.org)에서 버전에 맞는 설치 파일을 받아 설치한다. 메뉴 이름은 버전마다 다를 수 있으므로 공식 문서를 함께 열어 둔다.
  2. 영상 불러오기
    레이어 > 레이어 추가 > 래스터 레이어 를 클릭해 드론·위성 영상 파일(GeoTIFF 등)을 선택하고 추가 를 누른다.
  3. 라벨 레이어 생성
    레이어 > 레이어 생성 > 새 GeoPackage 레이어 에서 도형 유형을 폴리곤 으로 선택, 클래스명 필드(텍스트)를 추가하고 확인 을 누른다.
  4. 폴리곤 그리기
    편집 > 편집 모드 켜기 후 디지타이징 도구모음에서 폴리곤 피처 추가 를 클릭, 건물 외곽을 클릭해 따라 그린 뒤 오른쪽 클릭 > 완료 로 저장한다.
  5. 라벨 일치율 확인
    두 사람이 동일 영역을 각각 라벨링한 뒤, 벡터 > 지오프로세싱 도구 > 교차(Intersection) 로 겹치는 면적을 계산해 IoU를 수동으로 확인한다.
  6. 저장 및 내보내기
    레이어 오른쪽 클릭 > 내보내기 > 피처를 다른 이름으로 저장 에서 형식을 GeoJSON 또는 Shapefile 로 선택하고 내보내기 를 완료한다.

※ 프로그램 버전에 따라 메뉴 이름이 조금씩 다를 수 있습니다.

✍️ 그대로 복사해 쓰는 프롬프트

위성·드론 영상 라벨링 기준 문서 초안을 빠르게 만들 때

당신은 공간정보 데이터 품질 전문가입니다.
아래 조건에 맞는 위성·드론 영상 라벨링 기준 문서 초안을 작성해 주세요.

[대상 재난 유형]: (예: 홍수 침수 건물 탐지)
[영상 해상도 및 종류]: (예: 해상도 0.5m 광학 위성영상)
[라벨링 방식]: (예: 폴리곤 라벨링)
[클래스 목록]: (예: 정상 건물, 부분 침수, 완전 침수, 불명확)

문서에는 다음 항목을 반드시 포함하세요.
1. 각 클래스의 정의와 판별 기준(시각적 특징 포함)
2. 경계가 애매할 때의 처리 원칙(예: 건물 처마, 그림자, 식생 겹침)
3. 작업자 간 일치율(IoU) 목표 수치와 검수 절차
4. 자주 발생하는 오류 유형 3가지와 예방 지침

확인되지 않은 수치나 특정 도구의 현재 기능을 단정하지 마세요.
결과는 실무자가 바로 편집할 수 있도록 표 형식과 번호 목록을 섞어 작성하세요.
생성된 문서는 현장 전문가와 함께 반드시 검토하고 수정해야 합니다.

데이터셋의 클래스 불균형 현황을 파악하고 대응 방안을 정리할 때

당신은 머신러닝 데이터 품질을 검토하는 전문가입니다.
아래 데이터셋 정보를 바탕으로 클래스 불균형 문제와 대응 방안을 분석해 주세요.

[클래스별 샘플 수]: (예: 정상 건물 8,000개 / 피해 건물 400개)
[학습 목적]: (예: 산사태 피해 건물 탐지)
[사용 예정 모델 유형]: (예: 이미지 세그멘테이션 모델)

분석에는 다음을 포함하세요.
1. 불균형 비율 계산과 위험 수준 판단
2. 권장 대응 방법 2~3가지와 각각의 장단점
3. 모델 평가 시 정밀도(Precision), 재현율(Recall), F1 중 우선해야 할 지표와 이유
4. 이 데이터셋으로 학습할 때 주의해야 할 점

특정 라이브러리 버전이나 현재 성능을 단정하는 표현은 쓰지 마세요.
결과는 비전공자 실무자도 이해할 수 있도록 쉬운 말로 설명하고, 생성 결과는 반드시 담당자가 검토 후 적용하세요.

※ 대괄호 부분을 상황에 맞게 바꿔서 쓰세요. 받은 답은 그대로 쓰지 말고 사실 확인을 거치세요.

🧪 직접 해보기

  • QGIS에 공개 드론 영상(국토지리정보원 등에서 제공하는 공개 정사영상)을 불러온 뒤, 건물 하나를 직접 폴리곤으로 따라 그려 라벨링이 얼마나 주관적인지 체감해 본다.
  • 같은 영상 구역을 동료나 지인과 각각 독립적으로 라벨링한 뒤 두 결과물을 QGIS에서 겹쳐 보고, 어느 부분에서 경계가 다르게 나왔는지 확인해 본다.
  • 공개된 위성영상 라벨링 데이터셋(예: 재난 대응 관련 국제 공모전에서 공개된 데이터셋)을 내려받아 클래스별 샘플 수를 세어 보고, 불균형 여부를 직접 판단해 본다.

❓ 자주 묻는 질문

Q. 라벨링 작업을 AI가 자동으로 해줄 수는 없나요?
A. 반자동 라벨링 도구를 활용하면 초안을 빠르게 만들 수 있습니다. 하지만 재난 영상처럼 정확도가 중요한 경우, 자동 생성된 라벨을 사람이 반드시 검수하고 수정해야 합니다. 자동화는 작업 속도를 높이는 보조 수단이지, 품질을 보장하지는 않습니다.

Q. 라벨링 작업자는 GIS 전문가여야 하나요?
A. 반드시 그렇지는 않습니다. 도구 사용법은 비교적 짧은 교육으로 익힐 수 있지만, 어떤 대상을 어떤 기준으로 분류할지 판단하는 데는 재난 분야 현장 지식이 필요합니다. 라벨링 기준 문서를 만들 때 현장 전문가가 참여하는 것이 중요한 이유입니다.

Q. 오픈소스 라벨링 도구로는 무엇이 있나요?
A. CVAT, Label Studio, QGIS의 디지타이징 기능 등이 널리 쓰입니다. 각 도구의 기능과 지원 형식은 버전마다 다르고 지속적으로 변하므로, 사용 전에 공식 문서에서 최신 정보를 확인하는 것이 좋습니다.

공간 AI의 성능은 결국 학습 데이터의 품질에서 시작됩니다. 아무리 정교한 모델 구조를 갖춰도, 라벨이 제각각이거나 특정 지역·상황에 편향된 데이터로 학습했다면 실제 재난 현장에서 믿고 쓰기 어렵습니다. 라벨링 기준 문서를 만들고, 두 작업자의 결과를 비교하고, 클래스별 샘플 수를 세어 보는 일이 번거로워 보여도 이 과정이 모델의 신뢰도를 결정합니다. 데이터가 마련되었다면 이제 실제로 모델을 어떻게 학습시키는지, 그 구체적인 흐름이 궁금해지지 않으시나요?

GeoAI 기초 시리즈 9편 · 전체 43편


재난안전과 GeoAI 이야기를 더 보고 싶다면 아래 채널도 함께 보세요.

📌 바로가기

Google Earth Engine이란? 클라우드에서 위성영상 분석 | GeoAI 기초 8편

Google Earth Engine이란? 클라우드에서 위성영상 분석 | GeoAI 기초 8편

🎬 1분 브리핑 영상

📌 3줄 요약

  • Google Earth Engine은 위성영상을 클라우드에서 직접 분석하는 플랫폼이다.
  • 컬렉션·필터·리듀서 세 가지 사고 틀로 대부분의 분석을 설계할 수 있다.
  • 대규모 시계열 분석과 재난 현장의 신속한 변화 탐지에 특히 유리하다.

홍수가 발생했을 때 침수 범위를 확인하고 싶다고 해봅시다. 해당 지역의 위성영상을 구해서 내 컴퓨터에 내려받고, 소프트웨어를 열고, 처리를 기다리는 데만 수 시간이 걸릴 수 있습니다. 영상 한 장의 용량이 수십 기가바이트에 달하는 경우도 있으니까요.

Google Earth Engine(이하 GEE)은 이 흐름을 뒤집습니다. 영상을 내 컴퓨터로 가져오는 대신, 내가 분석 명령을 영상이 있는 서버로 보냅니다. 구글의 서버에는 수십 년치 위성영상이 이미 저장되어 있고, 분석은 그 자리에서 실행됩니다. 결과만 화면에 돌아오는 구조이기 때문에 로컬 저장 공간이나 처리 성능이 크게 중요하지 않습니다. 재난 상황처럼 시간이 촉박한 현장에서 이 구조가 어떤 의미인지, 차근차근 살펴보겠습니다.

🖥️ GEE는 일반 GIS 소프트웨어와 어떻게 다른가요?

QGIS나 ArcGIS 같은 도구는 데이터를 내 컴퓨터에 내려받아 처리하는 방식입니다. 반면 GEE는 브라우저에서 code.earthengine.google.com에 접속하면 편집기 화면이 바로 열리고, 코드를 실행하면 연산이 구글 서버에서 돌아갑니다. 즉, 수백 장의 Landsat 영상을 다루더라도 내 하드디스크는 거의 비어 있는 상태로 분석이 가능합니다. 한 가지 주의할 점은 인터페이스나 메뉴 이름이 업데이트에 따라 조금씩 바뀔 수 있으니, 공식 문서(developers.google.com/earth-engine)를 함께 참고하는 것이 좋습니다. 재난 대응 기관에서 현장 피해 면적을 빠르게 산출해야 할 때, 별도의 데이터 다운로드 단계 없이 분석을 시작할 수 있다는 점이 실무에서 큰 장점으로 꼽힙니다.

📦 컬렉션·필터·리듀서, 이 세 가지가 왜 중요한가요?

GEE를 처음 접하면 낯선 용어 세 개가 반복해서 등장합니다. 컬렉션(Collection)은 위성영상 여러 장의 묶음입니다. 예를 들어 Sentinel-2 영상 전체가 하나의 컬렉션입니다. 필터(Filter)는 그 묶음에서 필요한 것만 추려내는 체입니다. 특정 날짜 범위, 특정 지역, 구름 비율 이하 같은 조건을 걸 수 있습니다. 리듀서(Reducer)는 걸러진 영상들을 하나의 값이나 하나의 영상으로 요약하는 계산입니다. 여러 날짜의 영상을 중앙값으로 합치거나 최솟값·최댓값을 뽑아내는 작업이 여기에 해당합니다. 이 세 단계의 사고 틀을 익히면 "침수 전후 NDWI 변화를 한 달치 영상에서 뽑아보자"라는 요구를 코드로 옮기는 흐름이 자연스럽게 잡힙니다.

🔍 GEE 코드는 어떻게 생겼나요?

GEE는 JavaScript 기반 편집기와 Python API(geemap 라이브러리 등) 두 가지 방식으로 쓸 수 있습니다. 아래는 JavaScript 편집기에서 한국 지역의 Sentinel-2 영상을 불러와 구름이 적은 영상만 추려 중앙값 합성을 만드는 가장 기본적인 뼈대입니다.

var collection = ee.ImageCollection('COPERNICUS/S2_SR_HARMONIZED')
  .filterDate('2024-07-01', '2024-07-31')
  .filterBounds(ee.Geometry.Point([127.5, 37.5]))
  .filter(ee.Filter.lt('CLOUDY_PIXEL_PERCENTAGE', 20));

var composite = collection.median();

Map.centerObject(composite, 9);
Map.addLayer(composite, {bands: ['B4', 'B3', 'B2'], min: 0, max: 3000}, '7월 중앙값');

코드 중 filterDate와 filterBounds가 필터, median()이 리듀서입니다. 편집기 상단의 Run 버튼을 누르면 오른쪽 지도 패널에 결과가 표시됩니다. 산불 피해 지역의 피해 전·후 영상을 이 구조로 비교하면 식생 손실 범위를 빠르게 시각화할 수 있습니다.

🌊 GEE가 특히 유리한 작업은 무엇인가요?

GEE가 빛을 발하는 분야는 시계열 분석과 대면적 처리입니다. 수십 년치 영상에서 연도별 NDVI 변화를 추적하거나, 나라 전체 면적의 토지피복 변화를 계산할 때 로컬 환경에서는 며칠이 걸릴 작업이 훨씬 짧은 시간 안에 끝납니다. 반면 아주 정밀한 지역 단위 분석, 또는 GEE가 제공하지 않는 독자적인 영상 데이터를 다뤄야 하는 경우에는 QGIS나 파이썬 환경이 더 적합할 수 있습니다. 직접 해봐야 아는 것이 있습니다. 자신이 다루려는 지역과 기간의 영상이 GEE 카탈로그에 포함되어 있는지 확인해야 합니다. 편집기에서 왼쪽 패널의 Search places and datasets 창에 데이터셋 이름을 입력하고, 결과 카드의 IMPORT 버튼을 누르면 해당 컬렉션의 시작 날짜와 공간 범위를 직접 확인할 수 있습니다. 홍수 피해 현황을 분석하려는 기관이라면 SAR 기반의 Sentinel-1 컬렉션이 카탈로그에 있는지, 원하는 날짜까지 포함되는지 이 방법으로 먼저 확인해야 합니다.

🚨 GEE를 쓸 때 놓치기 쉬운 주의점은 무엇인가요?

GEE는 연산을 즉시 실행하지 않고 명령을 쌓아두는 방식(지연 실행, Lazy Evaluation)으로 동작합니다. 코드를 작성하는 순간에는 실제 계산이 일어나지 않고, Map.addLayer나 Export 같은 출력 명령이 실행될 때 비로소 연산이 시작됩니다. 이 점을 모르면 중간 결과를 출력해 보려다 당황하는 경우가 생깁니다. 또한 분석 결과를 파일로 내려받으려면 편집기 상단 Tasks 탭에서 Export.image.toDrive 등의 명령을 확인하고 Run 버튼을 눌러야 내보내기가 시작됩니다. 용량이 크면 구글 드라이브로 분할 저장되기도 합니다. 재난 현장에서 침수 경계 폴리곤을 뽑아 GIS 파일로 공유해야 하는 상황이라면, Export 단계에 걸리는 시간까지 업무 흐름에 미리 포함시켜 두는 것이 좋습니다.

🖥️ 화면에서 따라하기

따라하기 단계

  1. GEE 접속
    브라우저에서 code.earthengine.google.com 에 접속, 구글 계정으로 로그인
  2. 데이터셋 확인
    왼쪽 패널 Search places and datasets 창에 'Sentinel-2' 입력 후 결과 카드 클릭, 공간·시간 범위 확인
  3. 컬렉션 불러오기
    데이터셋 카드의 IMPORT 버튼 클릭, 편집기 상단 Imports 영역에 변수명으로 추가됨
  4. 필터·리듀서 작성
    편집기에 filterDate·filterBounds·filter(구름 조건)·median() 코드 입력 후 Run 클릭
  5. 결과 확인
    오른쪽 지도 패널에서 Layers 토글로 레이어 켜고 끄며 영상 확인, 색상 범위는 레이어 이름 옆 톱니바퀴 아이콘으로 조정
  6. 결과 내보내기
    편집기 상단 Tasks 탭 클릭 후 Export 항목 옆 Run 버튼 눌러 구글 드라이브로 저장 시작

※ 프로그램 버전에 따라 메뉴 이름이 조금씩 다를 수 있습니다. 위 그림은 순서를 정리한 도식입니다.

✍️ 그대로 복사해 쓰는 프롬프트

GEE 초보자가 특정 재난 유형에 맞는 분석 코드 뼈대를 빠르게 얻기 위한 프롬프트

당신은 Google Earth Engine JavaScript API에 능숙한 공간정보 분석 전문가입니다.
아래 조건에 맞는 GEE 코드 뼈대를 작성해 주세요.
재난 유형: [홍수 / 산불 / 산사태 중 하나]
분석 목적: 피해 전후 영상을 비교해 변화 면적을 추출한다
대상 지역: [위도, 경도 또는 지역명]
분석 기간: 피해 전 [날짜 범위], 피해 후 [날짜 범위]
사용할 위성 데이터: [Sentinel-1 SAR / Sentinel-2 광학 중 하나]
요구 형식: 컬렉션 선언 → 필터 → 리듀서 → 지도 출력 → Tasks 탭 Export 순서로 작성
각 줄에 한국어 주석으로 역할을 설명해 주세요.
확인이 필요한 항목을 코드 아래에 번호 목록으로 따로 적어 주세요.
존재하지 않는 밴드 이름이나 데이터셋 ID는 쓰지 마세요.

※ 대괄호 부분을 상황에 맞게 바꿔서 쓰세요. 받은 답은 그대로 쓰지 말고 사실 확인을 거치세요.

🧪 직접 해보기

  • code.earthengine.google.com 편집기에서 Search places and datasets에 'Sentinel-2'를 입력해 카탈로그에 포함된 기간과 지역을 직접 확인해 본다.
  • 위의 코드 예시를 편집기에 붙여 넣고 Run을 눌러, 지도 패널에 7월 한반도 중앙값 합성 영상이 표시되는지 확인해 본다.
  • filterDate의 날짜 범위를 산불이 발생한 시기 전후로 바꿔보고, median() 대신 min()으로 바꿨을 때 결과가 어떻게 달라지는지 비교해 본다.

❓ 자주 묻는 질문

Q. GEE를 쓰려면 코딩을 잘해야 하나요?
A. 기본적인 분석은 컬렉션·필터·리듀서 패턴을 이해하면 짧은 코드로 시작할 수 있습니다. JavaScript를 전혀 모르더라도 공식 튜토리얼과 예제 코드를 조금씩 수정하는 방식으로 입문할 수 있습니다. Python 환경이 더 익숙하다면 geemap 같은 라이브러리를 통해 Python 문법으로도 GEE를 사용할 수 있습니다.

Q. GEE에서 분석한 결과를 QGIS에서 열 수 있나요?
A. Tasks 탭에서 GeoTIFF 형식으로 내보내기를 실행하면 구글 드라이브에 파일이 저장되고, 그 파일을 QGIS에서 레이어 > 레이어 추가 > 래스터 레이어로 불러올 수 있습니다. 벡터 결과물은 Shapefile 또는 GeoJSON 형식으로 내보내는 것이 일반적입니다.

Q. GEE는 누구나 무료로 쓸 수 있나요?
A. 구글은 연구·교육·비영리 목적의 사용에 대해 별도의 프로그램을 운영하고 있으나, 구체적인 이용 조건과 정책은 공식 사이트에서 직접 확인해야 합니다. 상업적 사용이나 대규모 처리가 필요한 경우에는 별도의 요금제가 적용될 수 있습니다.

Google Earth Engine은 위성영상을 다루는 진입 장벽을 크게 낮춰 준 도구입니다. 영상을 내려받는 시간과 저장 공간 걱정 없이 컬렉션·필터·리듀서 세 가지 사고 틀만 익히면, 홍수 침수 범위 추적부터 산불 피해 면적 산출까지 재난 분석의 상당 부분을 브라우저 하나로 해결할 수 있습니다. 물론 GEE가 모든 상황에 최선인 것은 아닙니다. 도구에 따라 다른 장단점을 이해하고 적재적소에 쓰는 것이 실무 역량의 핵심입니다. 다음 편에서는 GEE에서 뽑아낸 영상을 인공지능 모델과 연결하는 방법, 즉 위성 데이터를 학습에 활용하는 첫 단계를 살펴볼 예정입니다. 과연 위성영상을 AI 모델에 입력하려면 어떤 전처리가 필요할까요?

GeoAI 기초 시리즈 8편 · 전체 43편


재난안전과 GeoAI 이야기를 더 보고 싶다면 아래 채널도 함께 보세요.

📌 바로가기

GeoAI 위성·드론 영상 분석, 재난대응 산업이 뜬다 | 재난안전과 GeoAI

GeoAI 위성·드론 영상 분석 기술이 재난대응 산업의 중심으로 떠오르고 있다. 누리호 5차 발사, 위성·드론 영상 분석 스타트업, ArcGIS 경사지 위험 분석 서비스까지 오늘의 관련 소식을 정리했다. 📌 3줄 요약 아크넥사는 위성·드론 영상을...