
30편에서 지형습윤지수(TWI)로 두 유역의 "젖을 만한 자리"를 비교했다. 같은 재료로 반대쪽 질문도 던질 수 있다. 물이 모이는 곳이 아니라, 모인 물이 경사를 타고 내려가며 바닥을 깎을 힘이 큰 곳은 어디인가. 사방이나 배수로 설계 전에 침식 위험 구간을 먼저 훑을 때 쓰는 지표가 하천강도지수(Stream Power Index, SPI)다.
식은 SPI = SCA × tan β다. SCA는 30편에서 만든 D-무한대 비집수면적(m²/m), β는 경사다. TWI가 SCA를 tan β로 나눈 값의 로그라면, SPI는 곱한 값이다. 위에서 받는 물이 많고 경사까지 급하면 커진다. 이번 회차는 30편 결과를 그대로 받아 Whitebox StreamPowerIndex를 돌리고, 구역통계로 두 유역을 비교했다. 그런데 비교 결과가 어떤 요약값을 보느냐에 따라 뒤집혔다. 이번 글의 대부분은 그 이야기다.
자료
30편 입력과 출력을 새 입력 폴더(WB31_Input_20261120)로 복사해 썼다. 복사본 해시는 원본과 같다.
| 입력 | 원래 출처 | 내용 |
|---|---|---|
| wb31_input_sca_dinf.tif | 30편 DInf Flow Accumulation | 18편 함몰지 보정 DEM(최대 비용 0.03)에서 만든 D-무한대 비집수면적. 1 m 셀, NAD83 UTM 13N EPSG:26913, 1500×1500 셀 |
| wb31_input_slope_deg.tif | 30편 Slope | 같은 보정 DEM의 경사, 도 단위. 0.020°~88.65°, 0°인 셀 없음 |
| wb31_input_basins_merged.shp | 26편 병합 폴리곤 | VALUE 1 = 중간유역(A−B) 1,218,780 m², VALUE 2 = B 유역 211,372 m² |
| wb31_input_streams_cap0p03.tif | 18편 하천 | 집수면적 1 ha 기준 하천(지도 확인과 하천 셀 통계용) |
SCA와 경사를 새로 만들지 않은 이유는 단순하다. 30편 TWI와 이번 SPI를 나란히 놓고 보려면 두 지수가 정확히 같은 SCA, 같은 경사에서 나와야 한다. 하나라도 다시 계산하면 둘의 차이가 지수 때문인지 입력 때문인지 가릴 수 없다.
1단계: StreamPowerIndex
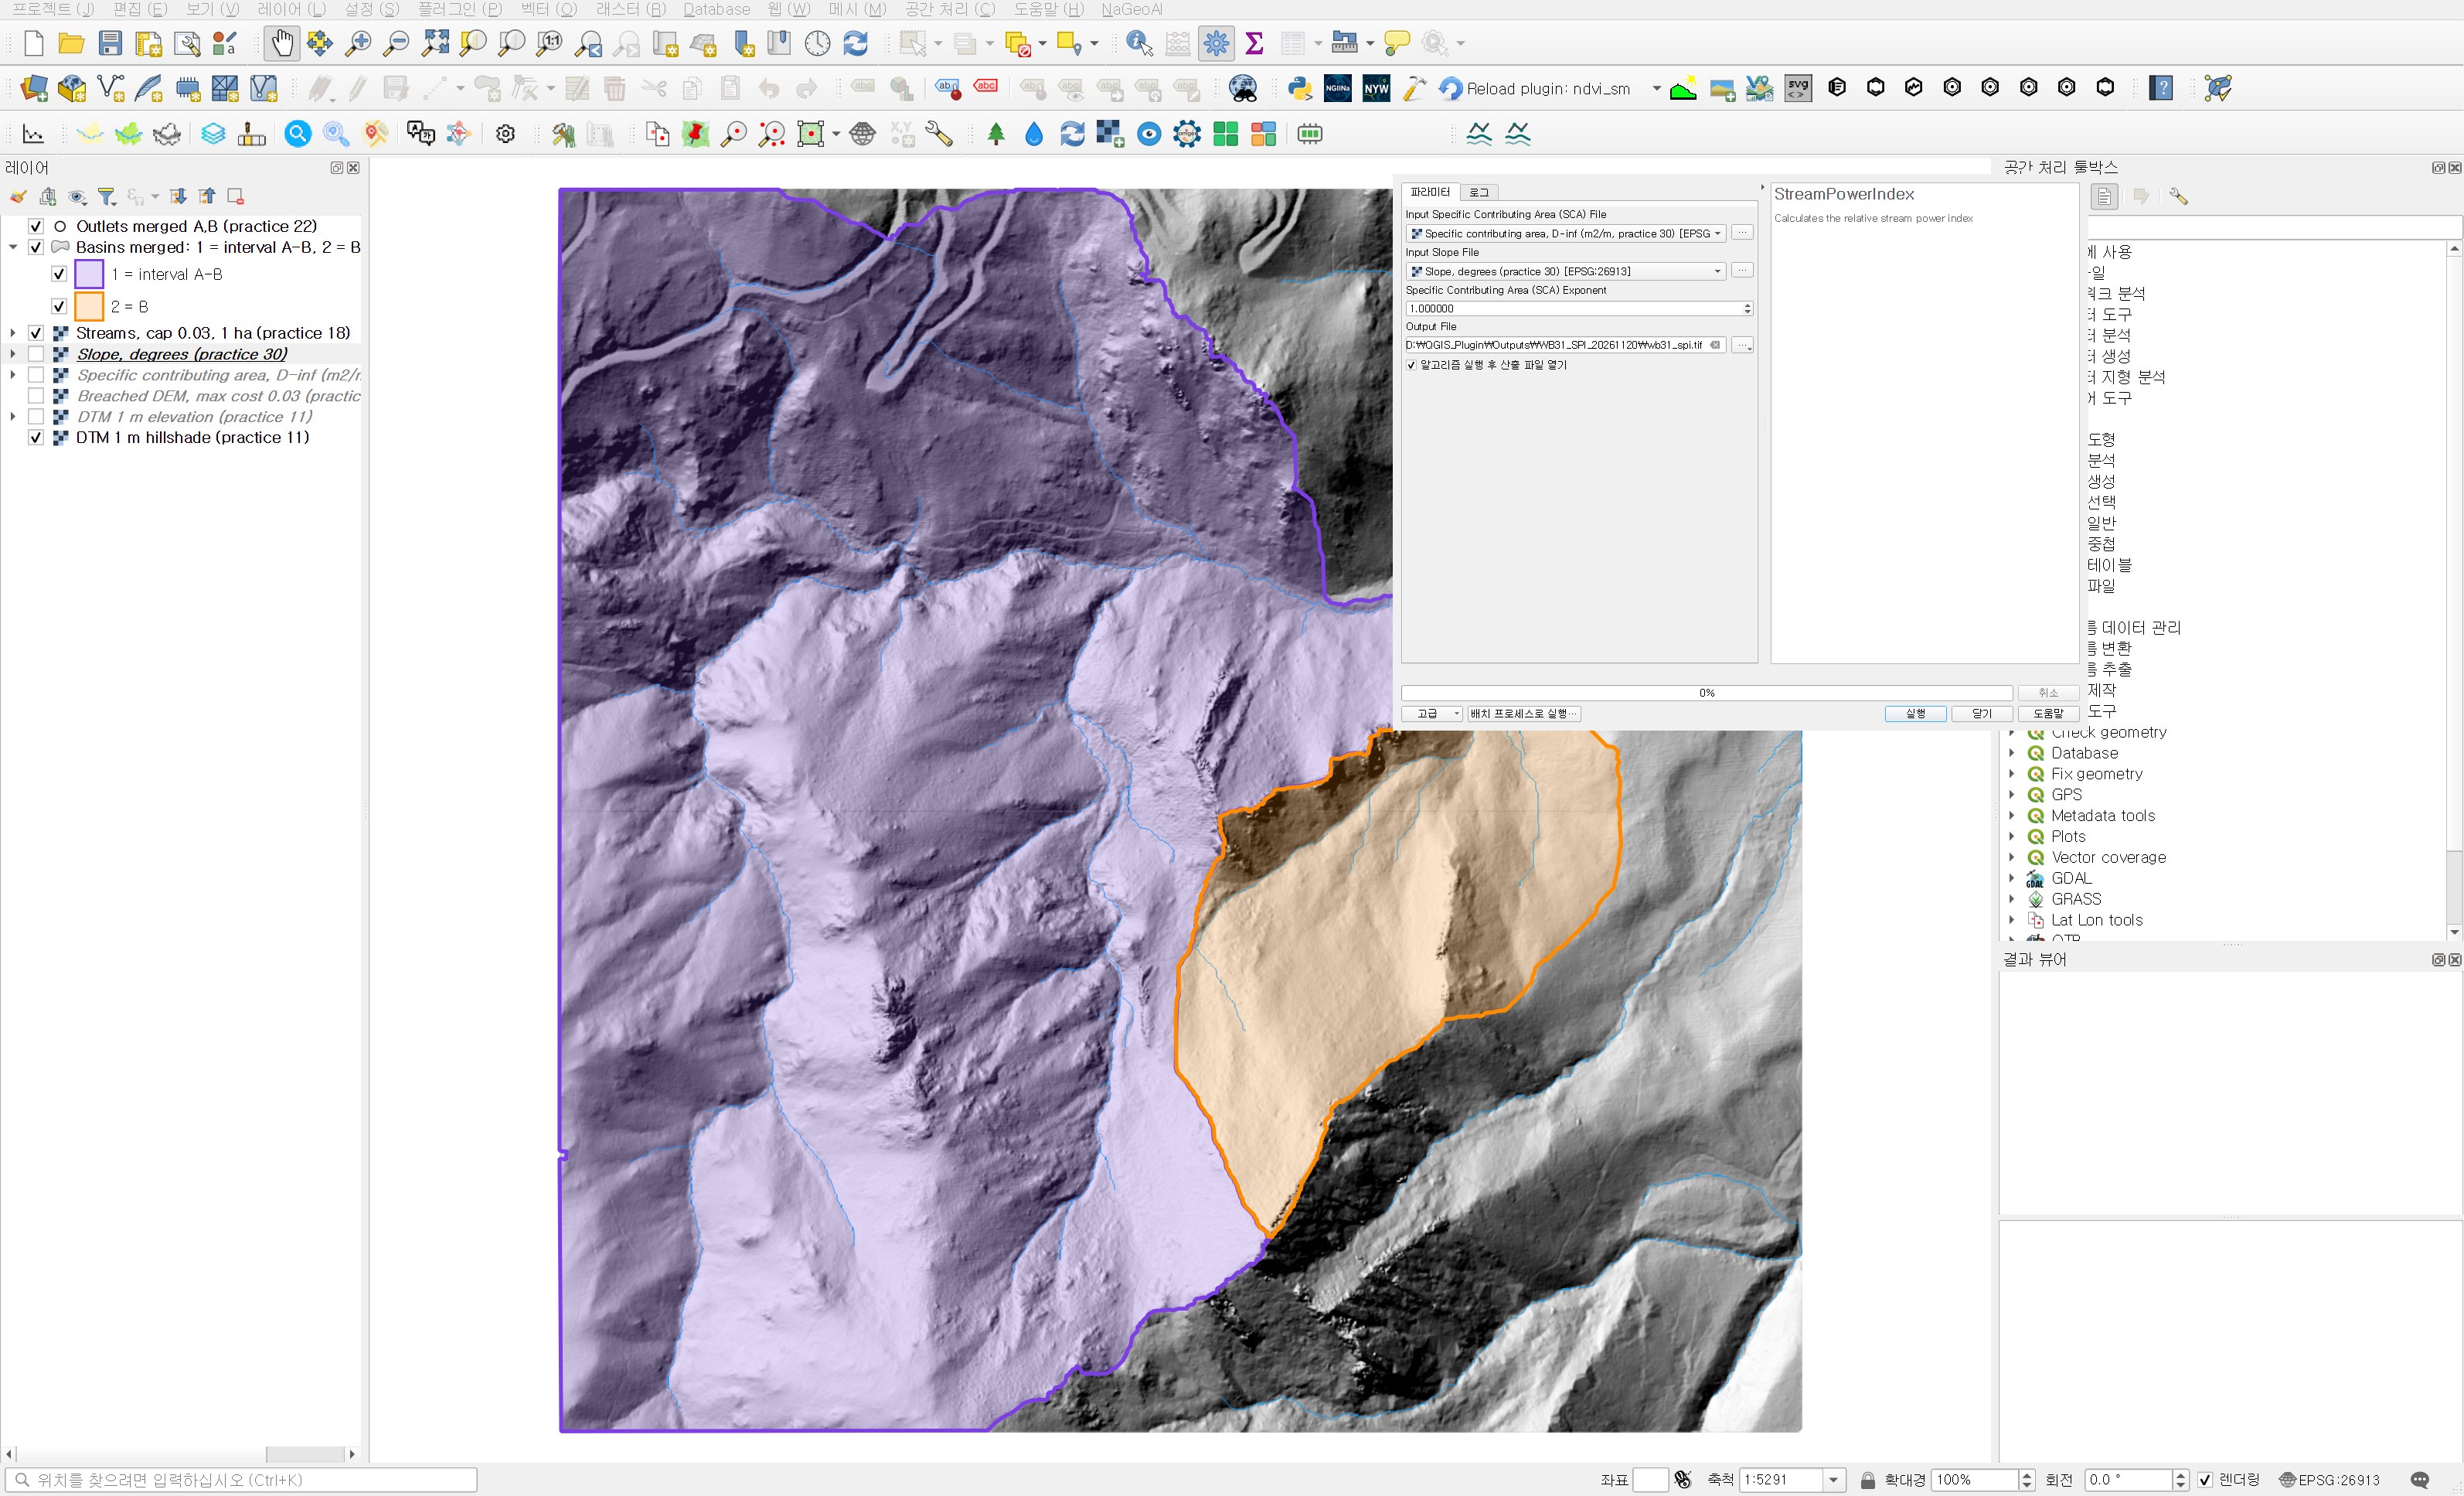
공간 처리 툴박스 → WhiteboxTools → Geomorphometric Analysis → StreamPowerIndex를 연다. 입력란은 셋이다.
| 입력란 | 값 | 이유 |
|---|---|---|
| Input Specific Contributing Area (SCA) File | Specific contributing area, D-inf (m2/m, practice 30) | Log-transform을 끄고 만든 SCA여야 한다. 로그를 씌운 SCA를 넣으면 곱셈이 의미를 잃는다. |
| Input Slope File | Slope, degrees (practice 30) | 도 단위 경사. 아래 독립 계산에서 도 단위로 tan을 취한 값과 맞았다. |
| Specific Contributing Area (SCA) Exponent | 1.0(기본값) | SPI = SCA^p × tan β의 p. 기본 형태 그대로 두었다. 집수면적의 영향을 줄이거나 키우는 연구용 조정이라, 같은 값을 써야 다른 결과와 비교가 된다. |
| Output File | wb31_spi.tif |
결과는 0.00044부터 1,719,393까지 열 자리 가까이 퍼진다. 중앙값은 14.1인데 99백분위가 1,469, 최댓값이 170만이다. SCA의 긴 꼬리를 그대로 물려받은 분포라서 선형으로 칠하면 하천 몇 줄만 보이고 나머지는 한 색이 된다. 0.1, 1, 10, 100, 1,000, 10,000을 경계로 한 단계 색으로 칠했다. QGIS 불연속 색 띠는 범례 값이 구간의 위쪽 끝이라, 예를 들어 남색은 1,000 초과 셀이다.
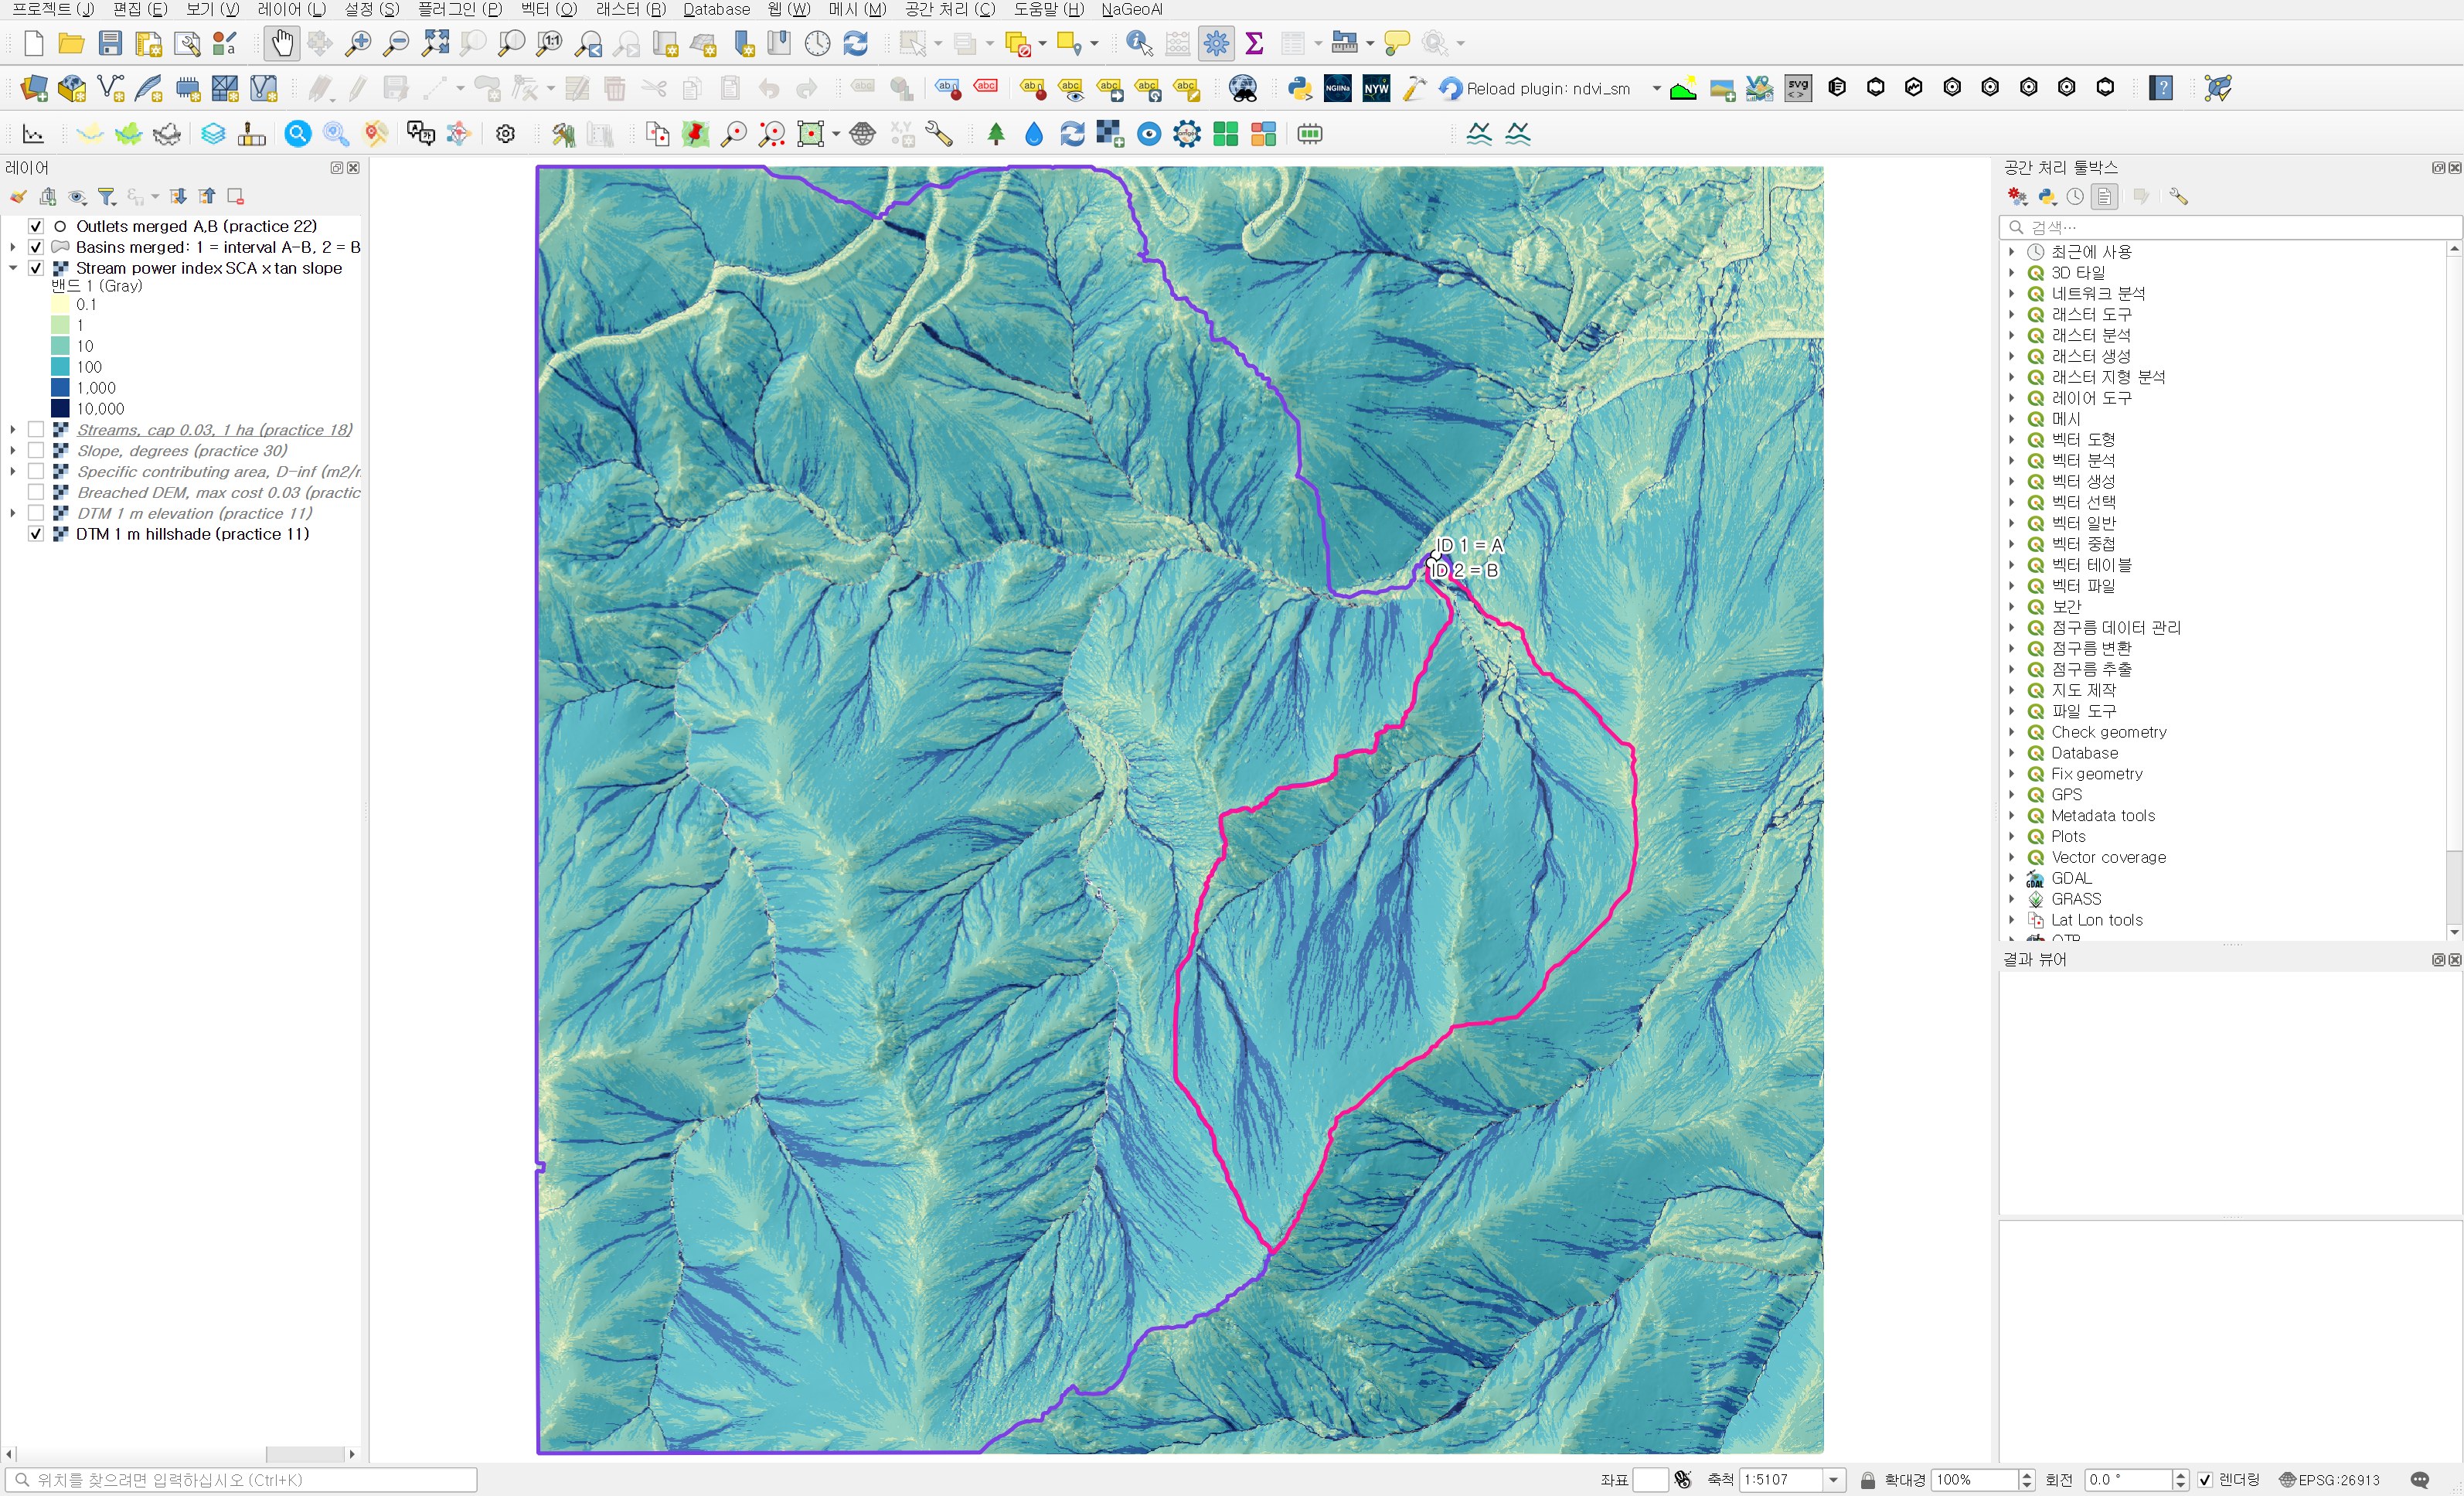
TWI 지도(30편 그림 4)와 겹쳐 보면 골짜기 줄기 모양은 비슷한데 성격이 다르다. TWI는 경사가 완만한 골짜기 바닥에서 더 커지고, SPI는 같은 줄기라도 경사가 급한 상류 구간에서 더 커진다. 유출구 쪽을 확대해 18편 하천(빨강)을 겹쳤다.
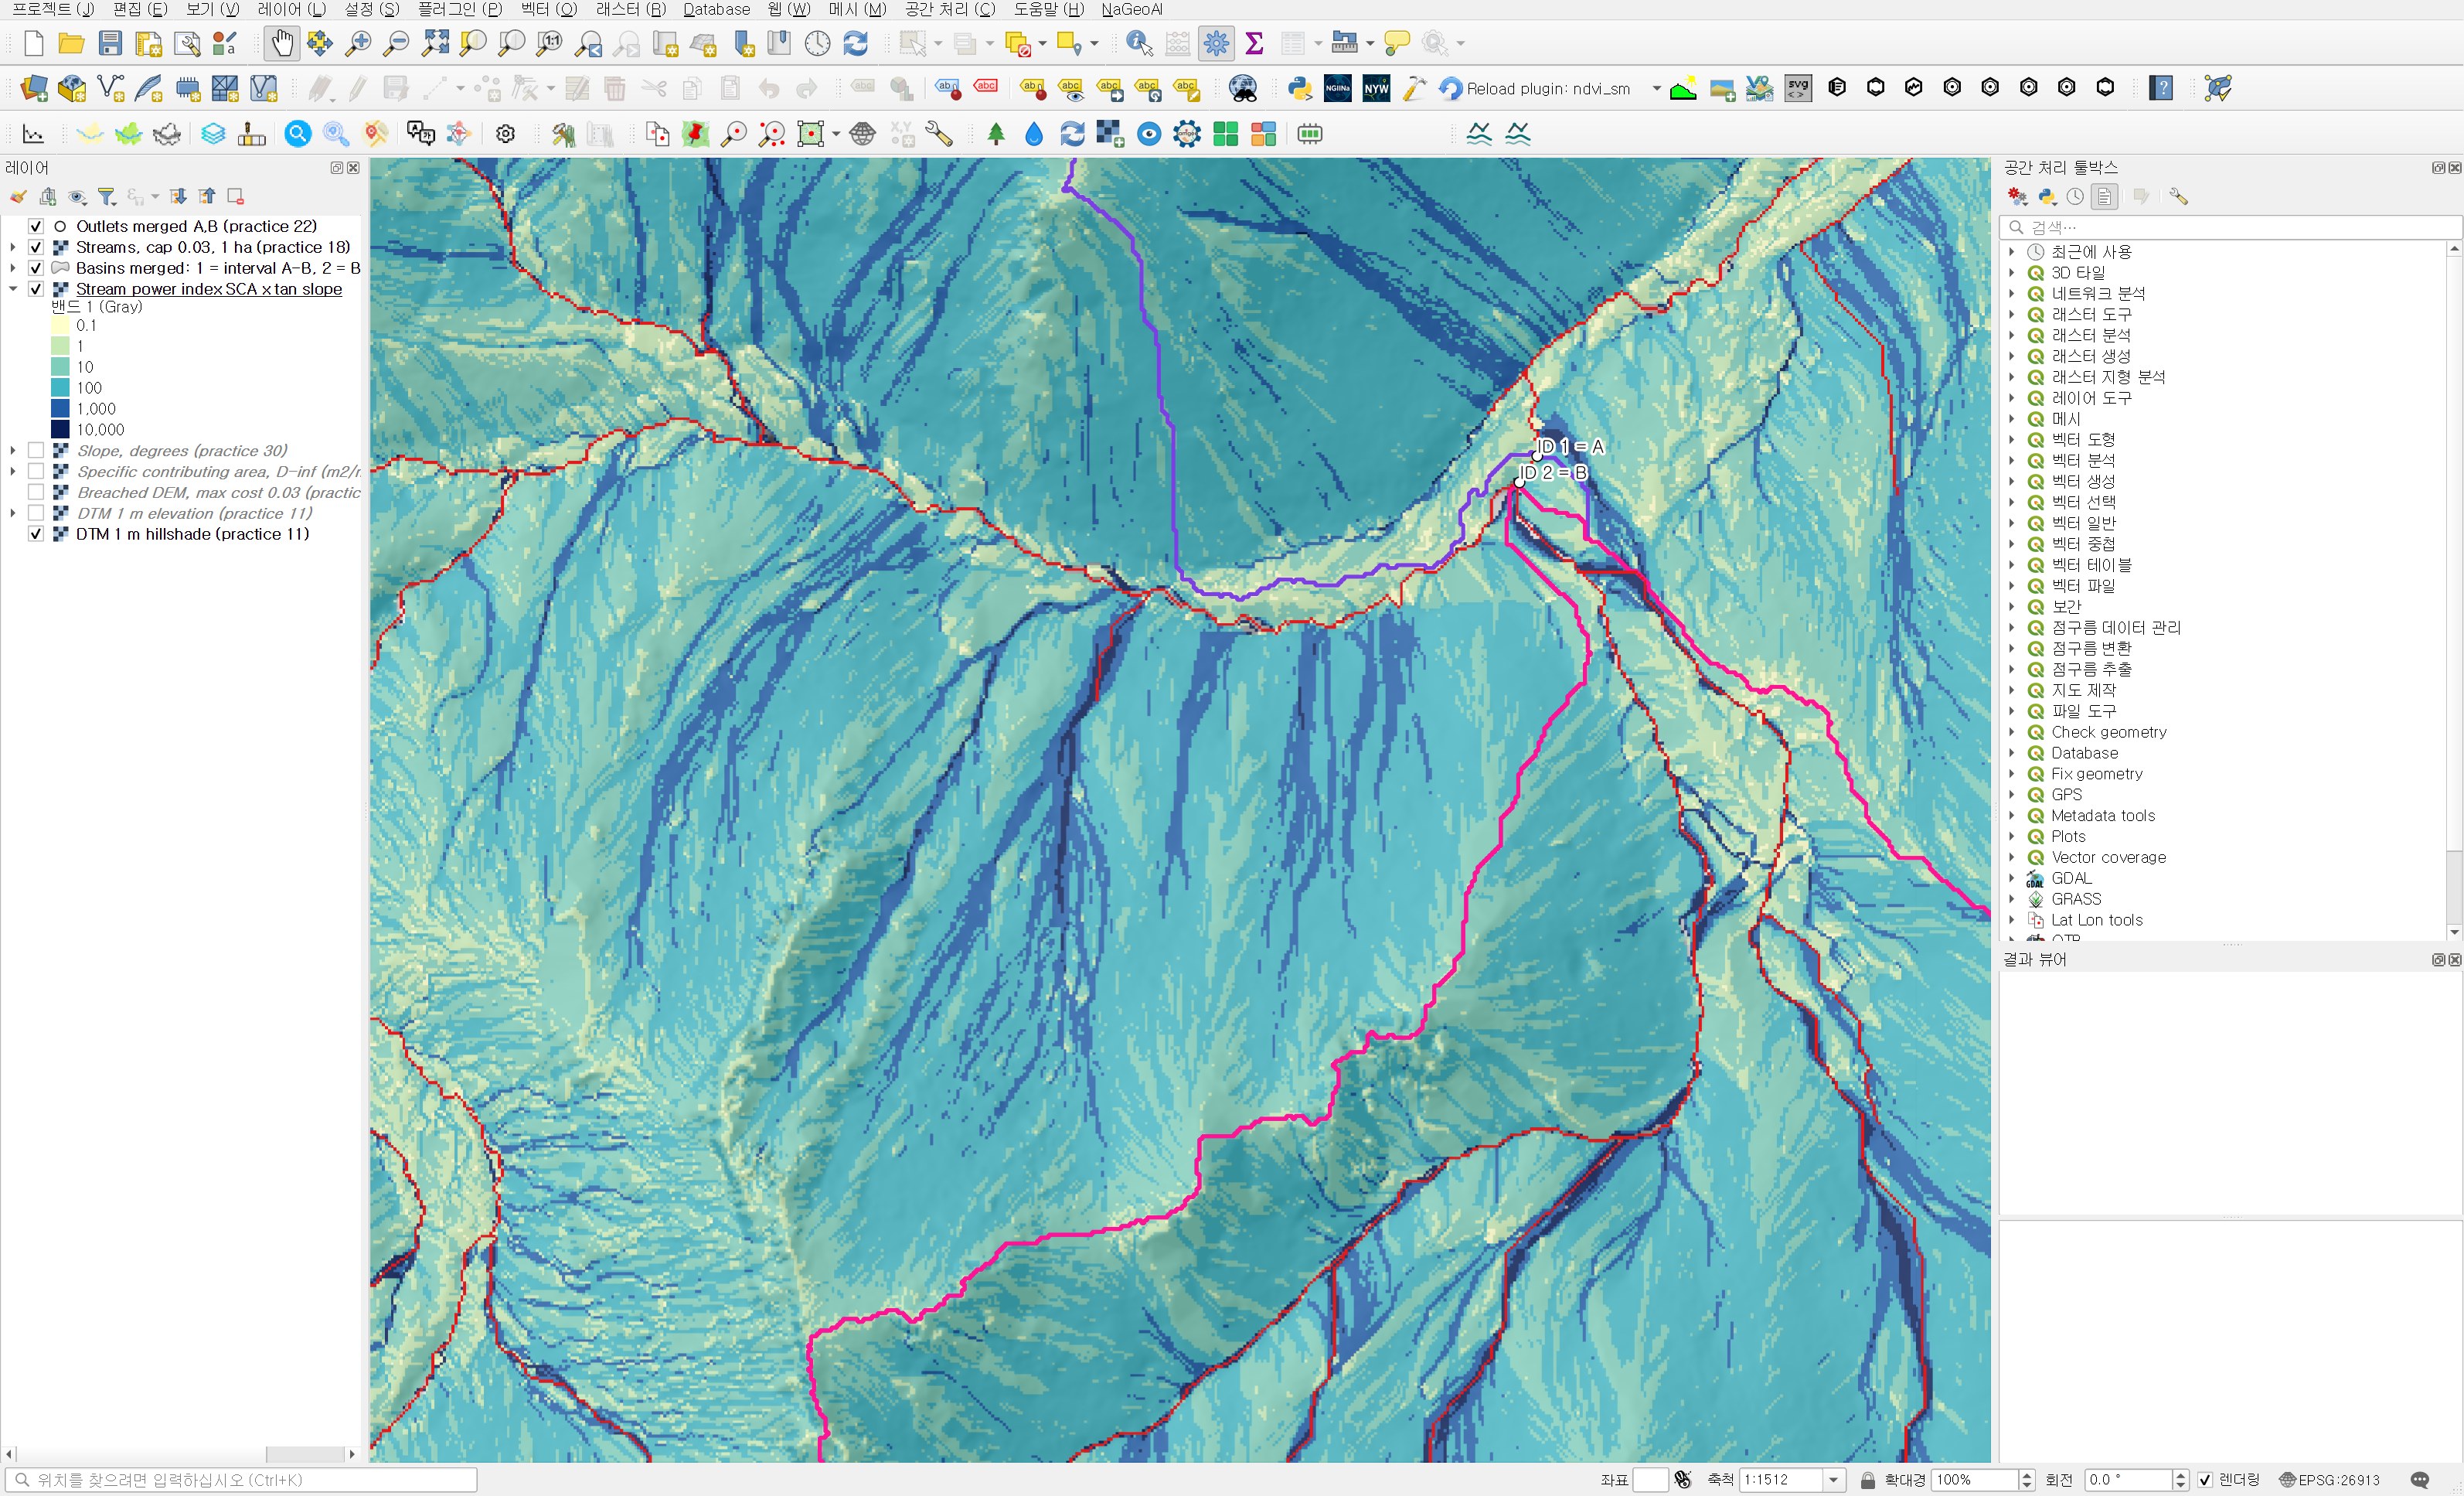
눈여겨볼 곳은 빨간 선이 없는 사면이다. 하천 기준(1 ha)에 못 미치는 사면 골에도 남색(1,000 초과)과 파랑(100 초과) 줄기가 길게 내려온다. 집수면적은 작아도 경사가 급하면 곱이 커져서, 하천 셀과 같은 색 단계에 들어간다. 하천 추출만 보고 "여기는 물길이 아니니 괜찮다"고 넘기기 쉬운 자리가 바로 이런 사면 골이다.
2단계: 유역별 구역통계
공간 처리 툴박스 → 래스터 분석 → 구역통계(Zonal statistics)에 26편 병합 폴리곤과 SPI를 넣었다. 접두어는 spi_, 통계는 30편과 같이 개수, 평균, 중앙값, 표준편차, 최소, 최대다. 출력은 wb31_basin_spi_stats.shp.
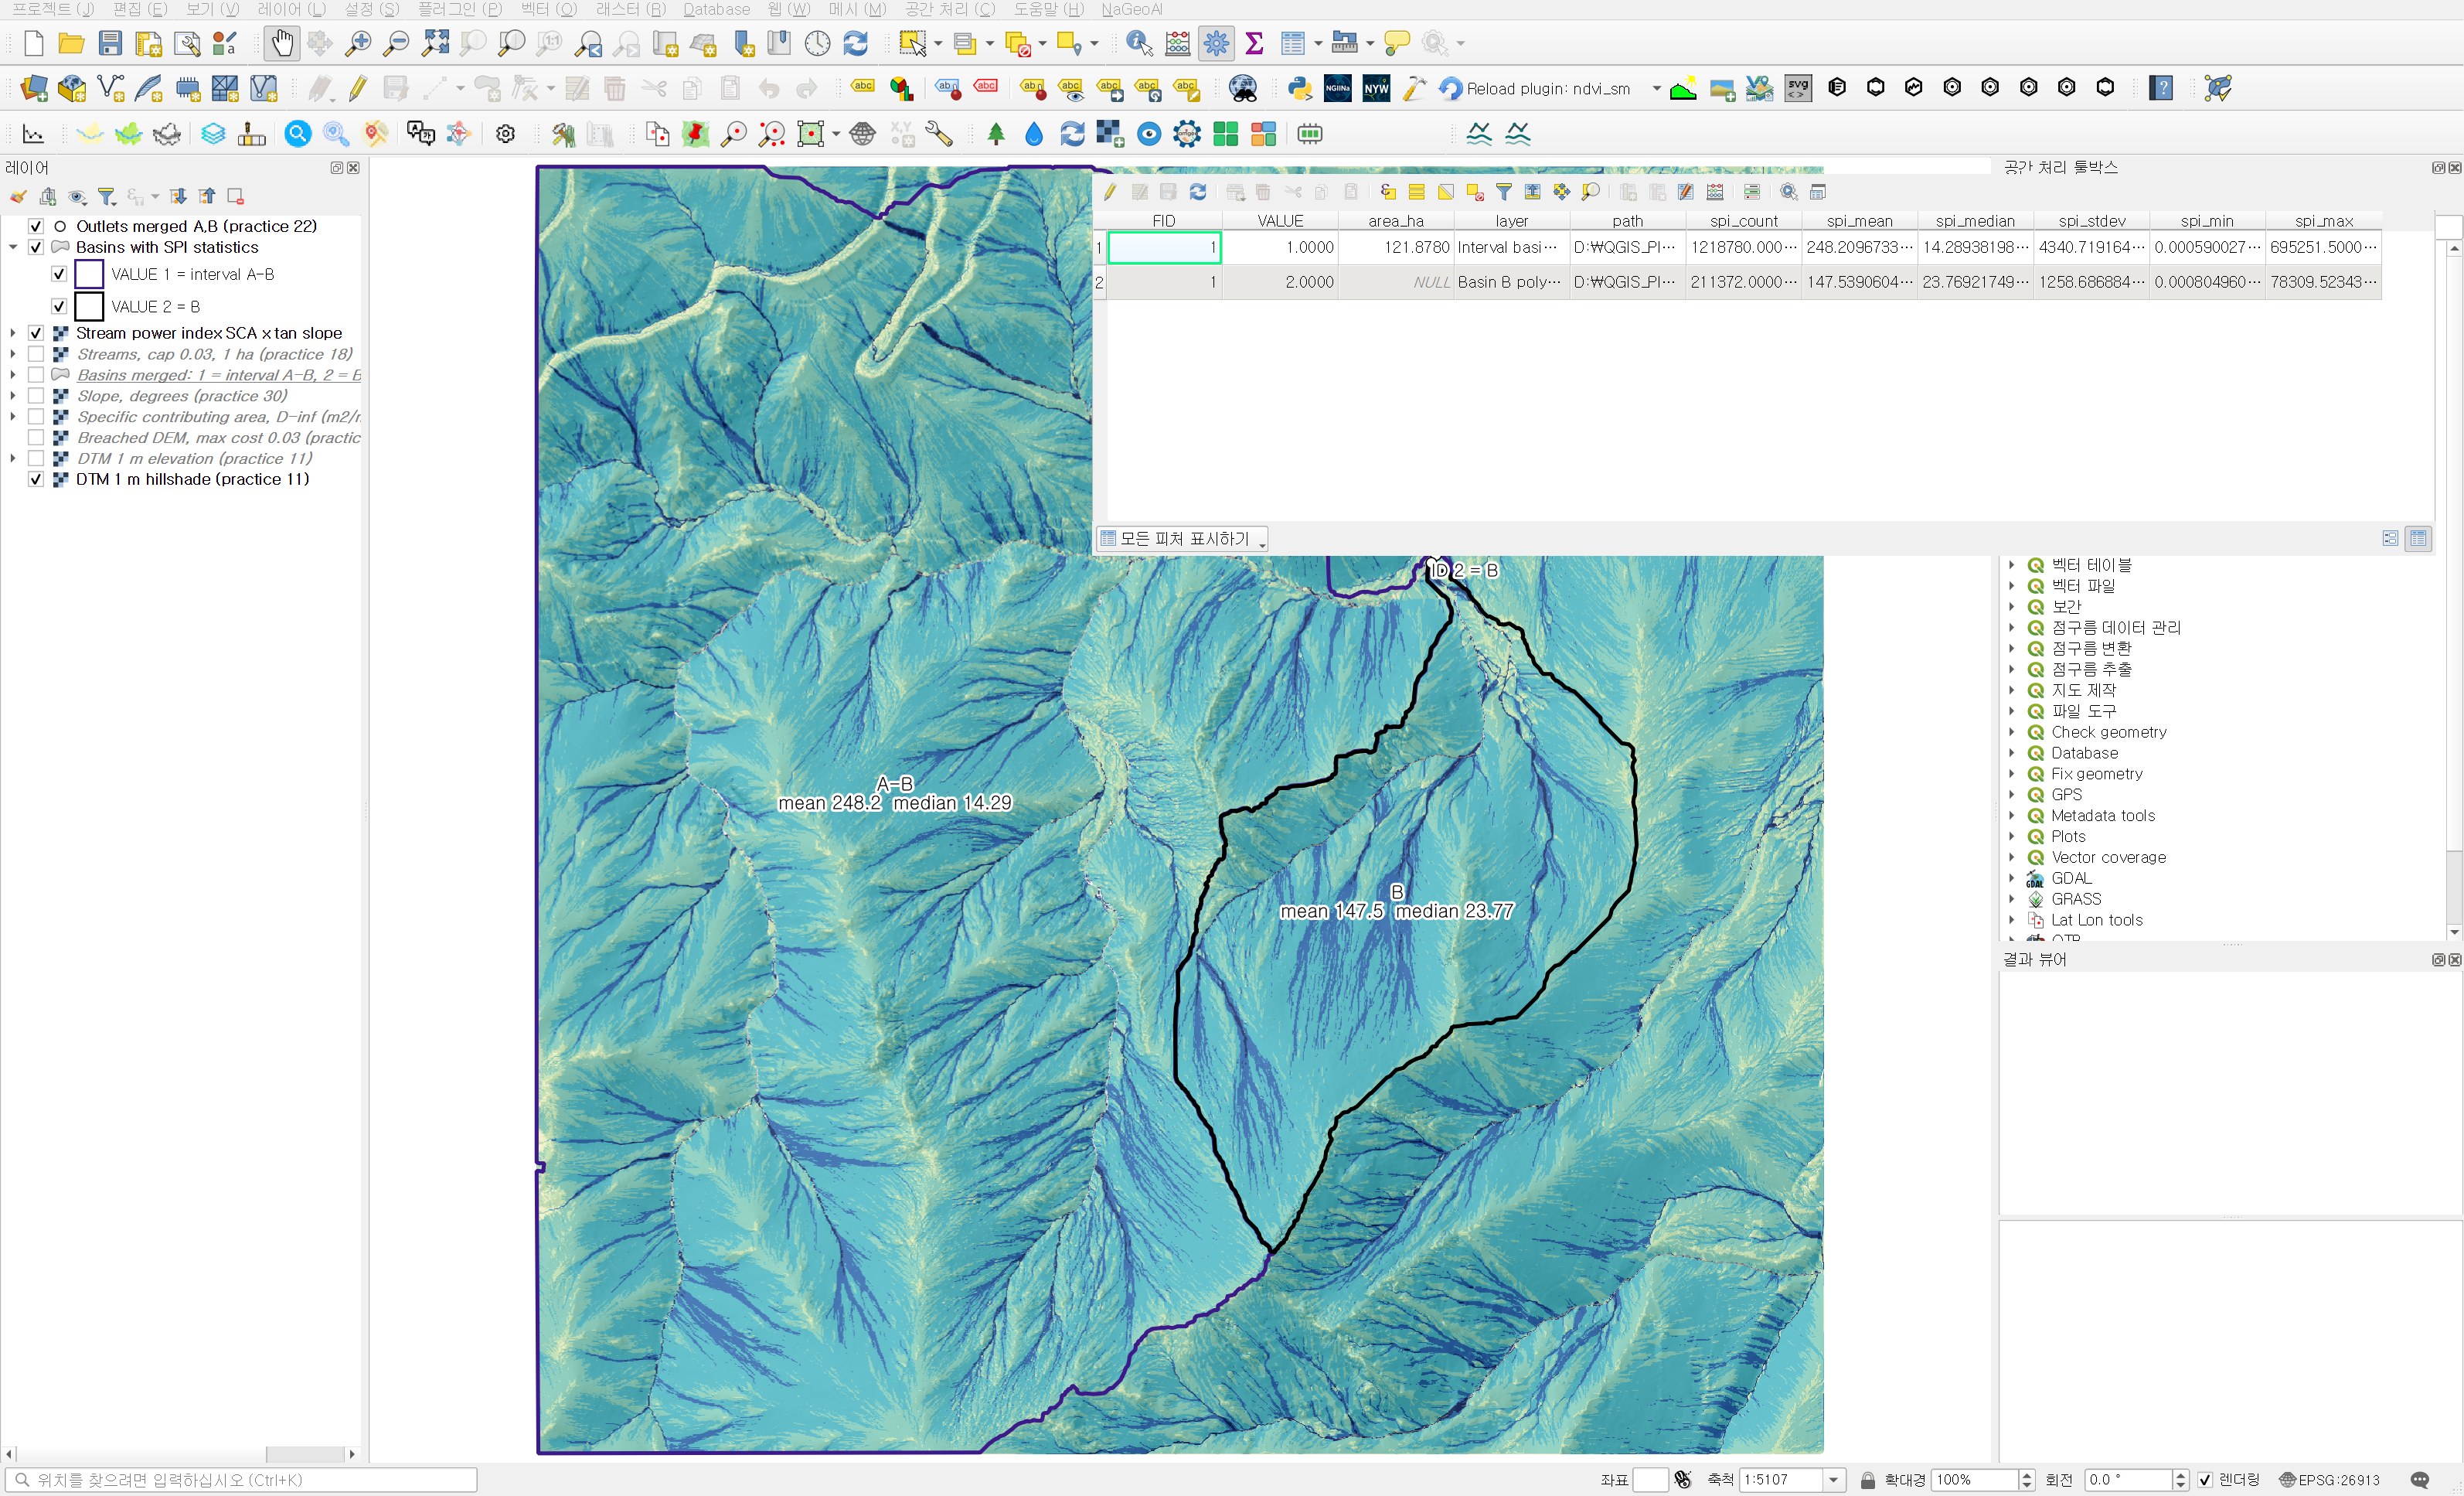
| 항목 | 중간유역 A−B | 유역 B |
|---|---|---|
| 셀 수(m²) | 1,218,780 | 211,372 |
| 평균 | 248.2 | 147.5 |
| 중앙값 | 14.29 | 23.77 |
| 표준편차 | 4,340.7 | 1,258.7 |
| 최댓값 | 695,251.5 | 78,309.5 |
| 10 / 90백분위 | 2.24 / 89.97 | 3.50 / 134.08 |
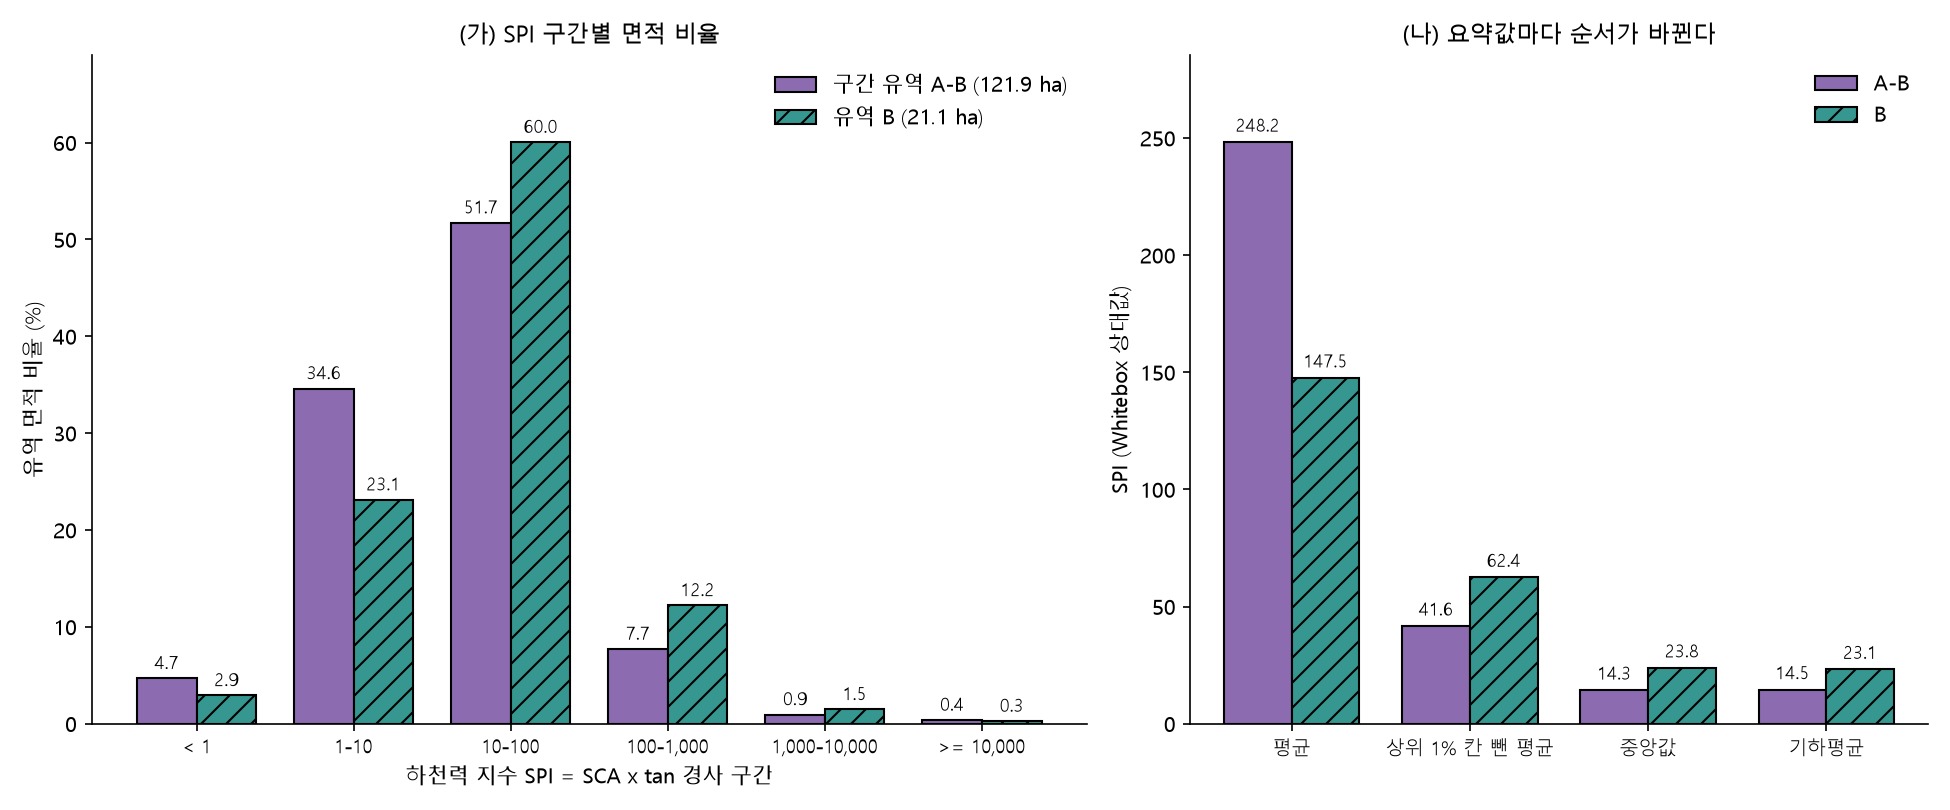
평균만 보면 중간유역이 B보다 1.7배 크다. 중앙값은 반대로 B가 1.7배 크다. 표준편차가 평균의 17배(A−B), 8.5배(B)다. 이 정도로 치우친 분포에서는 평균 하나로 유역을 대표하면 안 된다는 신호다.
평균이 뒤집힌 이유
값을 큰 순서로 세워 상위 1% 셀만 따로 떼어 봤다.
| 항목 | 중간유역 A−B | 유역 B |
|---|---|---|
| 상위 1% 셀 수 | 12,188 | 2,114 |
| 상위 1% 셀이 SPI 합계에서 차지하는 비율 | 83.4% | 58.1% |
| 상위 1% 셀을 뺀 평균 | 41.6 | 62.4 |
| 기하평균 | 14.49 | 23.14 |
| 하천 셀(1 ha 기준) 수 / 중앙값 | 6,390 / 11,493 | 1,371 / 4,895 |
| 하천 밖 셀 중앙값 | 14.17 | 23.52 |
중간유역은 셀 1%가 SPI 합계의 83%를 차지한다. 그 셀들을 빼면 평균이 248에서 41.6으로 떨어지고 B(62.4)보다 작아진다. 중간유역 안에는 A 본류가 지나가고, 본류 셀은 위쪽 집수면적이 수십만 m²라 SPI가 수만에서 수십만이 된다. 최댓값 695,252가 그 본류 셀 쪽으로 보인다. 하천 셀 중앙값도 중간유역이 11,493으로 B(4,895)의 두 배가 넘는다. 즉 평균의 차이는 "본류를 품고 있느냐"의 차이였고, 사면 전체의 성격은 아니었다.
하천 밖 셀만 보면 B가 23.5, 중간유역이 14.2다. 그림 5의 구간 비율에서도 B는 100~1,000 구간이 12.2%로 중간유역(7.7%)보다 많고, 1~10 구간은 23.1%로 중간유역(34.6%)보다 적다. 사면 셀 대부분이 한 단계 위로 올라가 있는 셈이다.
TWI와 같은 재료, 다른 부호
기하평균은 ln SPI의 평균을 되돌린 값이라 성분으로 쪼갤 수 있다. ln SPI = ln SCA + ln tan β이므로 두 유역의 차이는 다음과 같다.
- ln SCA 평균: B 3.7625, 중간유역 3.2619, 차이 +0.500
- ln tan β 평균: B −0.6208, 중간유역 −0.5885, 차이 −0.032
- 합 0.468, 즉 기하평균 비 23.14 / 14.49 = 1.60배
30편 TWI에서는 같은 두 성분이 0.500 + 0.032 = 0.533으로 더해졌다. TWI는 tan β를 나누니 B의 경사가 조금 완만한 것이 TWI를 올렸고, SPI는 곱하니 같은 차이가 SPI를 조금 깎는다. 다만 경사 항은 0.03 수준이고 차이 대부분은 ln SCA 0.5에서 나온다. B 사면이 셀마다 위쪽에서 받는 면적이 평균적으로 e^0.5 ≈ 1.65배 많기 때문에, B는 TWI도 높고 SPI도 높다. 같은 사면이 더 젖고 더 깎일 수 있다는 말이 모순처럼 들리지만, 둘 다 "물이 많이 지나간다"는 같은 사실을 다른 각도에서 본 것이다.
현장 판단으로 옮기면 이렇다. 본류 하나를 관리하는 문제라면 중간유역이 우선이다. 사면 골 여러 줄에서 생기는 세굴이나 토사 유출을 걱정한다면 B 쪽 사면을 먼저 봐야 한다. 이건 지형 지수만으로 한 해석이고, 실제 침식량이나 토양 조건으로 확인한 것은 아니다.
독립 계산으로 확인
- numpy로 SCA × tan(경사°)를 다시 계산해 Whitebox 출력과 비교했다. 유효 2,248,166개 셀에서 상대 차이 최대 6.0×10⁻⁸, 10⁻⁵을 넘는 셀 0개다. 지수 1.0과 도 단위 경사가 의도대로 들어갔다.
- 출력 SPI는 EPSG:26913, 1500×1500, float32, NoData −32768 1,834개 셀로 입력 SCA·경사·DEM과 격자가 같고 NoData 셀 수도 DEM과 같다.
- 구역통계 여섯 항목을 셀 중심으로 래스터화한 유역 마스크로 다시 계산하면 두 유역 모두 차이가 10⁻¹² 이하다.
실무에서 챙길 것
- SPI는 꼬리가 극단적으로 긴 지표다. 유역 비교에 평균 하나만 쓰면 본류 몇 줄이 결과를 정해 버린다. 중앙값, 기하평균, 상위 몇 %의 비중을 같이 낸다.
- 지도는 대수 간격 단계 색으로 칠한다. 선형 색 띠로는 하천 몇 셀만 보인다.
- SPI는 상대 지수다. 값 크기는 DEM 공간해상도, 흐름 알고리즘(D8인지 D-무한대인지), SCA 지수 p에 따라 달라진다. 다른 지역과 비교할 때는 같은 공간해상도와 같은 설정으로 다시 만든다.
- 하천 추출 기준 아래에 있는 사면 골을 따로 본다. 그림 3처럼 하천선이 없는 자리에서도 SPI가 1,000을 넘는 줄기가 나온다.
- 1 m 라이다 DEM에서는 도로 측구, 절토 비탈 같은 인공 지형이 SPI를 크게 만들 수 있다. 높은 값이 나온 셀은 항공사진이나 현장으로 한 번 확인한다.
다음 회차
SPI는 침식 "힘"의 상대 크기만 본다. 같은 SCA와 경사로 Whitebox SedimentTransportIndex를 쓰면 토양유실 식(RUSLE)의 경사장 인자(LS)에 해당하는 값을 만들 수 있다. 다음 회차에서는 이번 SPI와 LS 계열 지수가 두 유역을 같은 순서로 보는지 비교해 보려고 한다.
작업 메모
이번 회차는 QGIS 시작 스크립트로 같은 대화상자에 값을 넣어 실행했고, 화면은 그때 캡처한 것이다. 원본 프로젝트는 그대로 두고 복사본(QGIS_Play_NaGeoAI_20261120_31_spi.qgz)에서 작업했다. 자료 출처는 USGS 3DEP(The National Map) 타일 13SDE474426이고, 원본 DTM은 재배포하지 않는다. 그림 5, 백분위, 상위 1% 비중, 기하평균과 성분 분해, 하천 셀 통계, 독립 계산은 출력 파일을 다시 읽는 별도 스크립트로 만든 것이다. QGIS 3.44.15, WhiteboxTools v2.2.0(wbt_for_qgis 플러그인). SHA-256 앞 12자리:
- 입력 비집수면적 371c0096063a
- 입력 경사 0971ac9f4ce6
- 하천강도지수 17a50232deb2
- 구역통계 .shp / .dbf 235891ed214a / eb9cdcb01867


댓글 없음:
댓글 쓰기