
26편에서 중간유역(A−B)과 B 유역의 표고 통계를 뽑았더니 평균은 중간유역이 약 76 m 높았고, B는 중앙값이 평균보다 14 m가량 낮았다. 평균 두 개만으로는 "어느 표고에 땅이 얼마나 있는가"를 말할 수 없다. 홍수 도달 시간이나 적설, 식생대를 따질 때 필요한 건 그 분포다. 그래서 이번에는 DTM을 50 m 간격 표고 구간으로 나누고, 유역마다 구간별 셀 수를 세어 표고-면적 분포를 나란히 놓아 봤다.
도구는 QGIS 기본 처리 알고리즘 두 개로 끝난다. 테이블로 재분류(Reclassify by table)로 표고를 구간 코드로 바꾸고, 구역히스토그램(Zonal histogram)으로 폴리곤 안의 코드별 셀 수를 센다. 1 m DTM이라 셀 하나가 1 m²이니 셀 수가 곧 면적이다.
자료
11편 1 m DTM(USGS 3DEP 타일 13SDE474426, NAD83 UTM 13N EPSG:26913, 지면점으로 만든 DTM)과 26편에서 만든 병합 폴리곤을 새 입력 폴더로 복사해 썼다. 복사본 해시는 원본과 같다.
| 입력 | 원래 출처 | 내용 |
|---|---|---|
| wb27_input_dtm1m.tif | 11편 DTM | 1500×1500 셀, 1 m, float32, NoData −32768(1,834개 셀), 표고 1,712.96~2,284.53 m |
| wb27_input_basins_merged.shp | 26편 wb26_basins_merged | VALUE 1 = 중간유역 1,218,780 m², VALUE 2 = B 유역 211,372 m² |
표고를 50 m 구간 코드로 재분류
DTM의 최저·최고가 1,712.96 m와 2,284.53 m라서 1,700 m부터 2,300 m까지 50 m씩 12개 구간을 잡았다. 구간 코드는 1, 2, 3 같은 일련번호 대신 구간의 아래 경곗값(1700, 1750, …, 2250)으로 넣었다. 그러면 나중에 히스토그램 필드 이름이 h_1900처럼 표고 자체가 되어 표를 읽을 때 번호표를 따로 볼 필요가 없다.
공간 처리 툴박스 → 래스터 분석 → 테이블로 재분류(Reclassify by table)를 열고 아래처럼 넣었다.
| 입력란 | 값 | 이유 |
|---|---|---|
| 래스터 레이어 | DTM 1 m elevation (practice 11) | 표고 원값 |
| 밴드 번호 | 밴드 1 | |
| 재분류 테이블 | 12행 × 3열: 최소 1700 / 최대 1750 / 값 1700, … , 최소 2250 / 최대 2300 / 값 2250 | 50 m 간격, 값은 아래 경곗값 |
| NODATA 값 산출 | −9999 | 정수형 출력에 맞춘 NoData |
| 범위 경계 | 최소 <= 값 < 최대 | 정확히 2,000 m인 셀을 2000~2050 구간에 넣기 위해 |
| Use NoData when no range matches value | 체크 | 표 밖의 값이 원래 값 그대로 남지 않도록 |
| 산출 데이터 유형 | Int16 | 코드가 2250까지라 Int16으로 충분하고 파일이 작다 |
| 재분류된 래스터 | wb27_dtm_bands50m.tif |
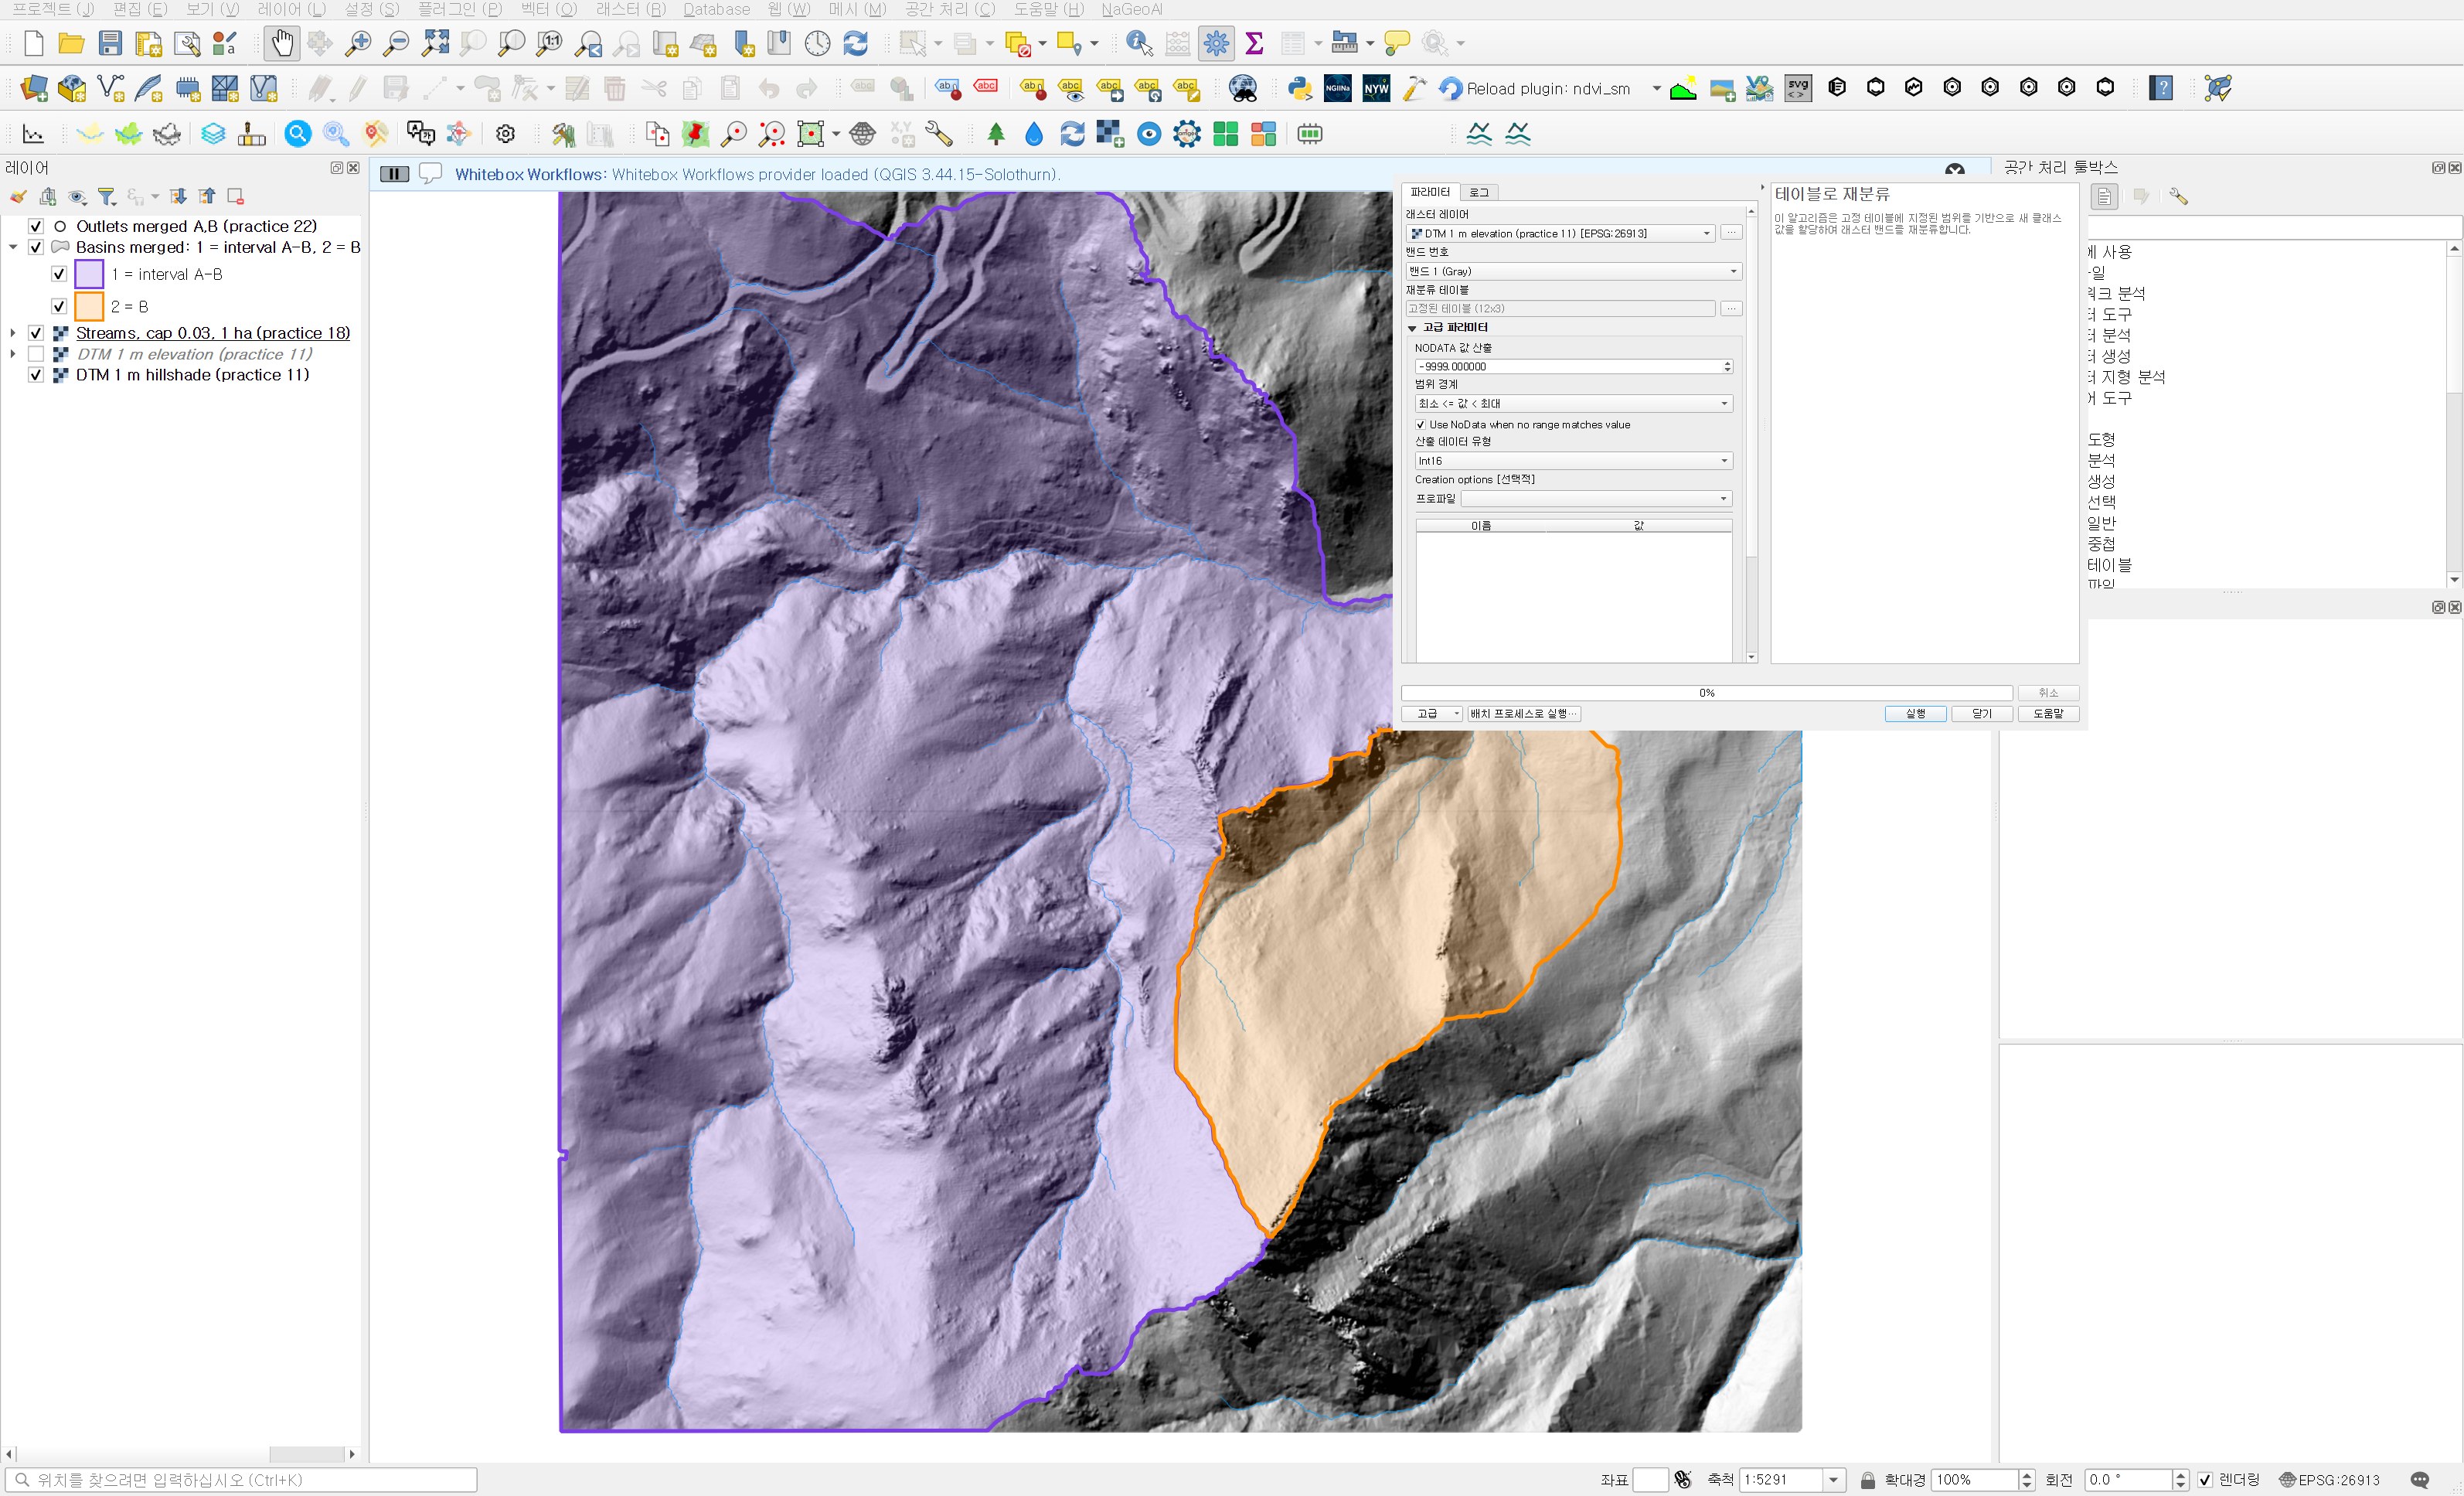
범위 경계는 기본값이 "최소 < 값 <= 최대"다. 기본값으로 두면 정확히 2,000.0 m인 셀이 1950~2000 구간에 들어간다. 연속 실수 표고에서 정확히 경곗값인 셀은 드물지만, 구간 이름을 "2000~2050 m"라고 부를 거라면 아래 경계를 포함하는 쪽이 이름과 맞는다. 결과는 0.13초 만에 나왔다.
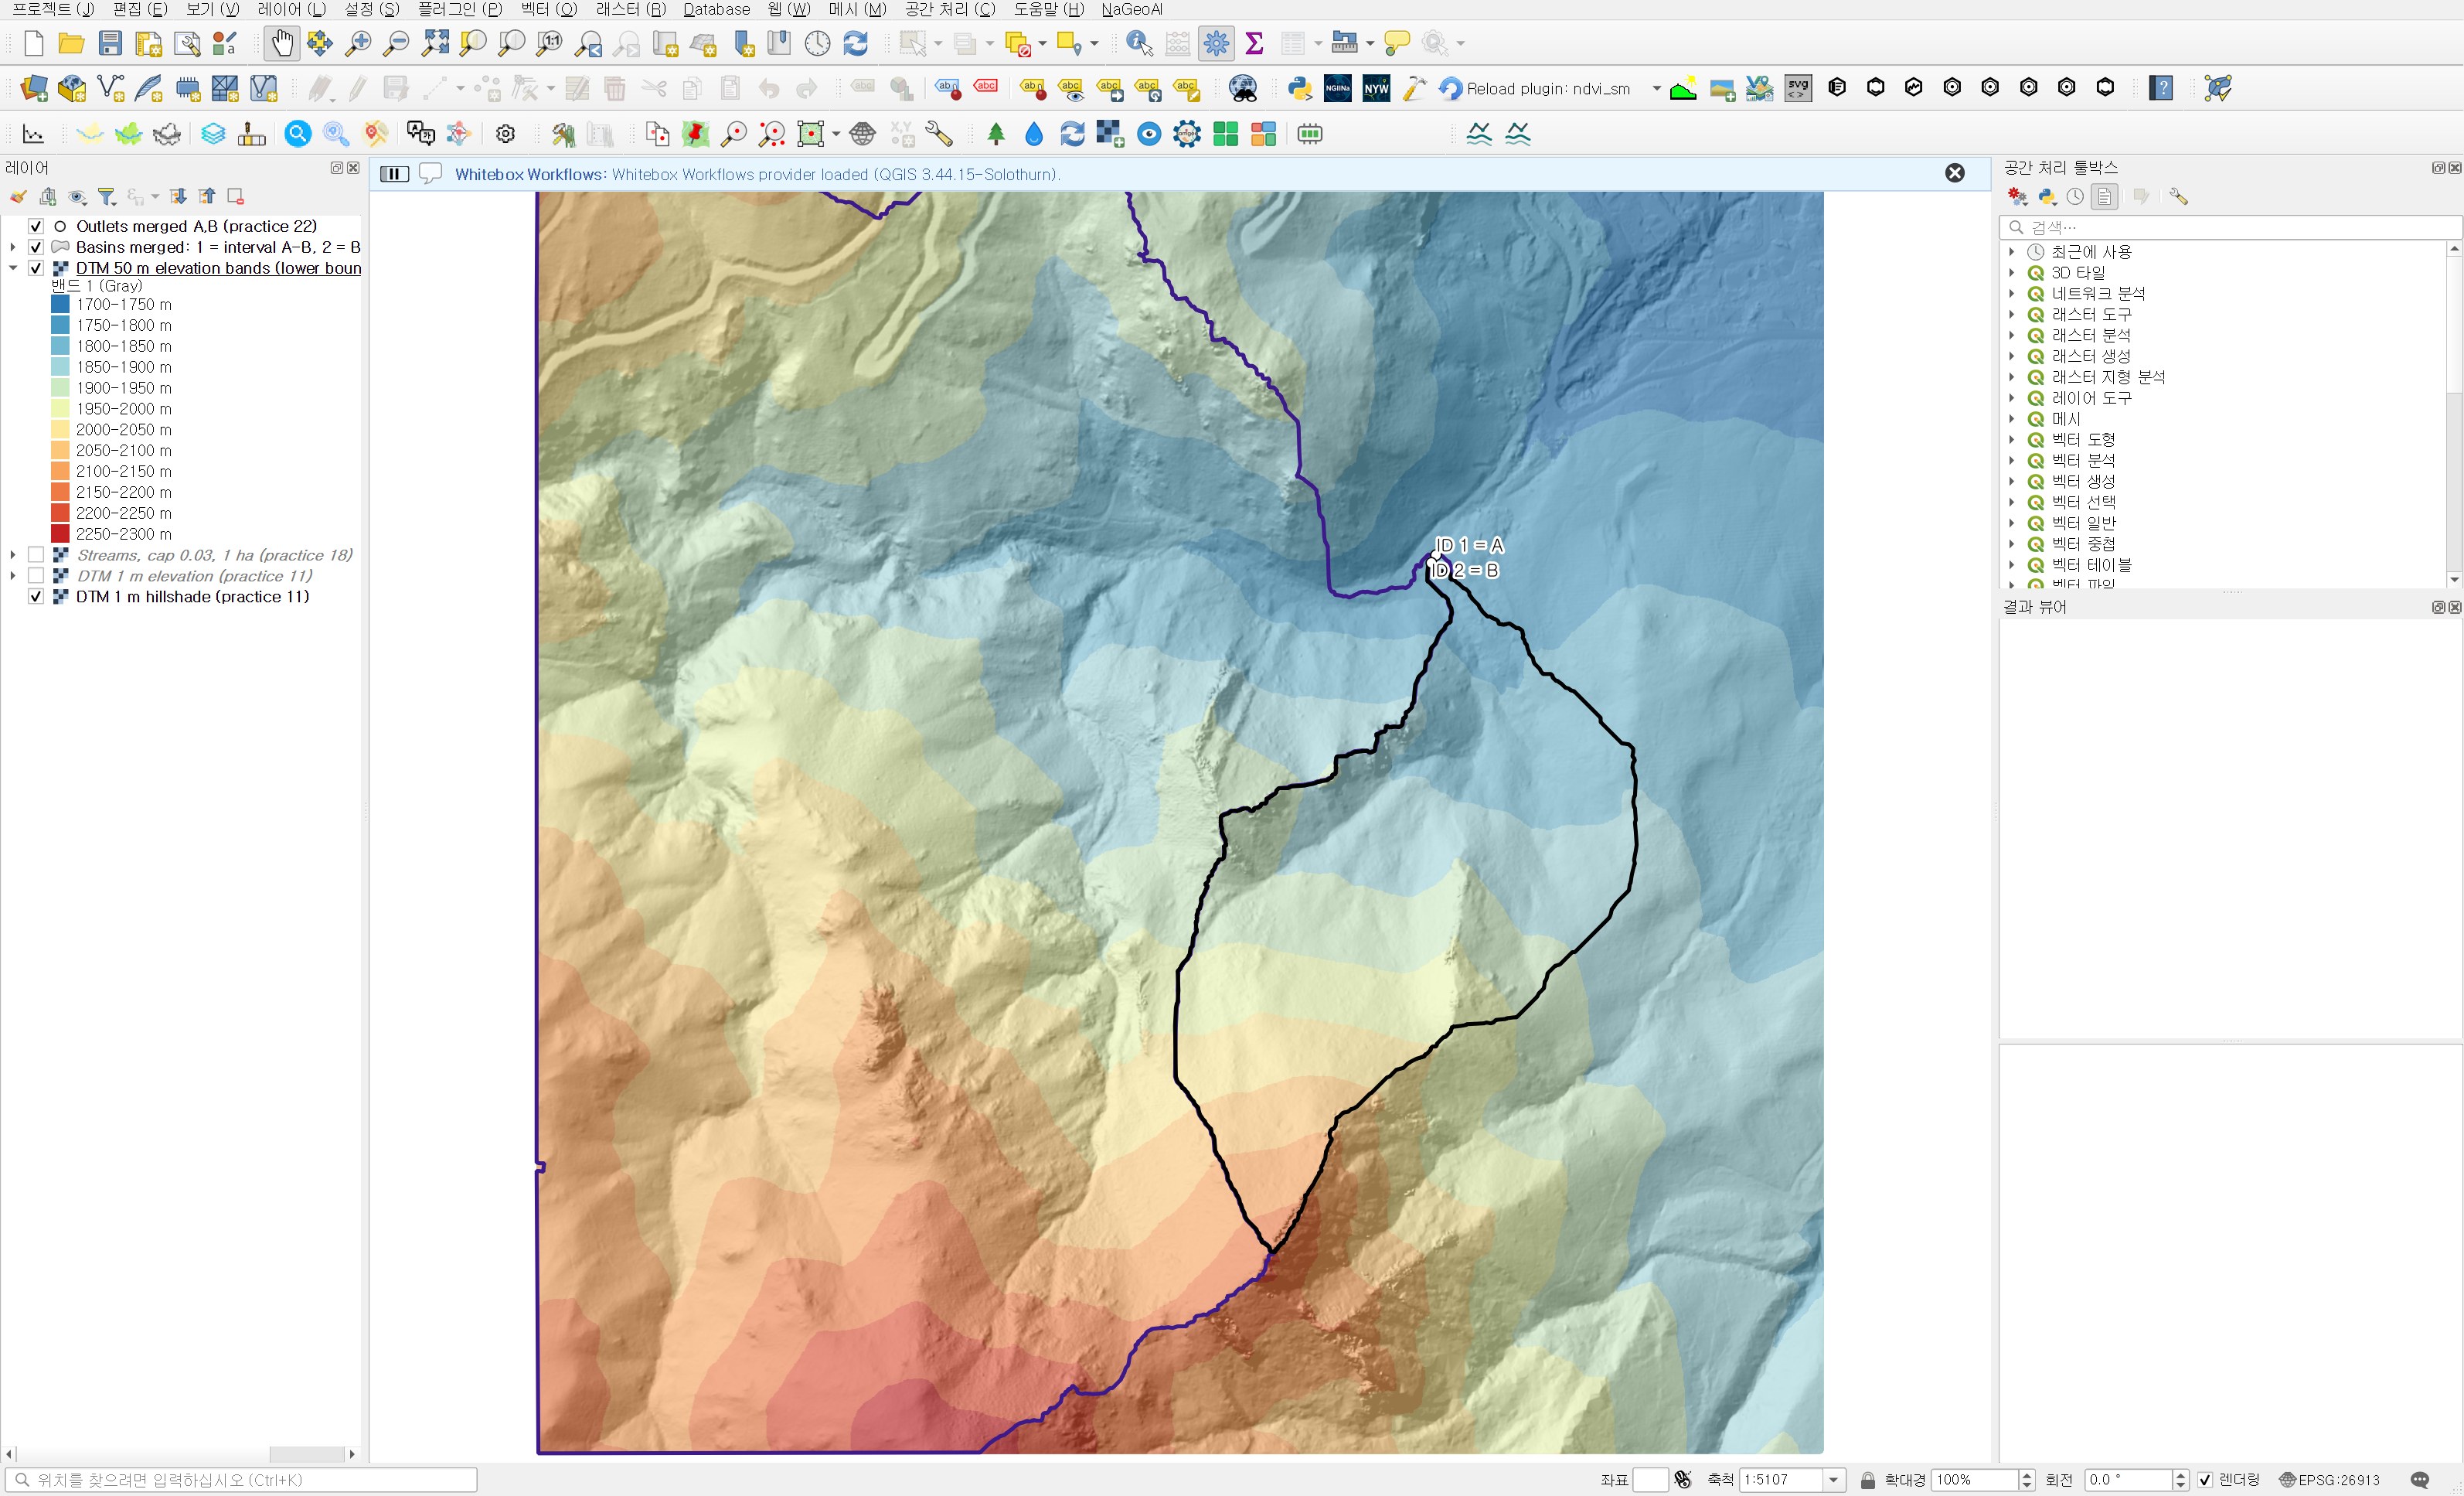
지도로 보면 B 유역은 대부분 파란색과 연두색 구간에 걸쳐 있고 남쪽 끝만 주황색에 닿는다. 중간유역은 유출구 근처 파란색에서 남서쪽 빨간색 능선까지 색이 거의 다 들어 있다. 숫자로 확인할 차례다.
구역히스토그램으로 유역별 셀 수 세기
공간 처리 툴박스 → 래스터 분석 → 구역히스토그램(Zonal histogram)은 폴리곤마다 래스터의 고유값별 셀 수를 필드로 붙여 준다. 26편의 구역통계가 평균·최대 같은 요약값을 준다면, 이 도구는 값별 개수 표를 준다. 범주형 래스터(토지피복, 이번처럼 구간 코드)에 맞는 도구다.
| 입력란 | 값 | 이유 |
|---|---|---|
| 래스터 레이어 | DTM 50 m elevation bands (lower bound) | 방금 만든 구간 코드 |
| 밴드 번호 | 밴드 1 | |
| 구역을 담고 있는 벡터 레이어 | Basins merged: 1 = interval A-B, 2 = B (practice 26) | 두 유역이 한 레이어에 있어 결과도 한 표로 나온다 |
| 산출 열 접두어 | h_ | shp 필드명 10자 제한 안에 h_2250까지 들어간다 |
| 산출 구역 | wb27_basin_band_histogram.shp |
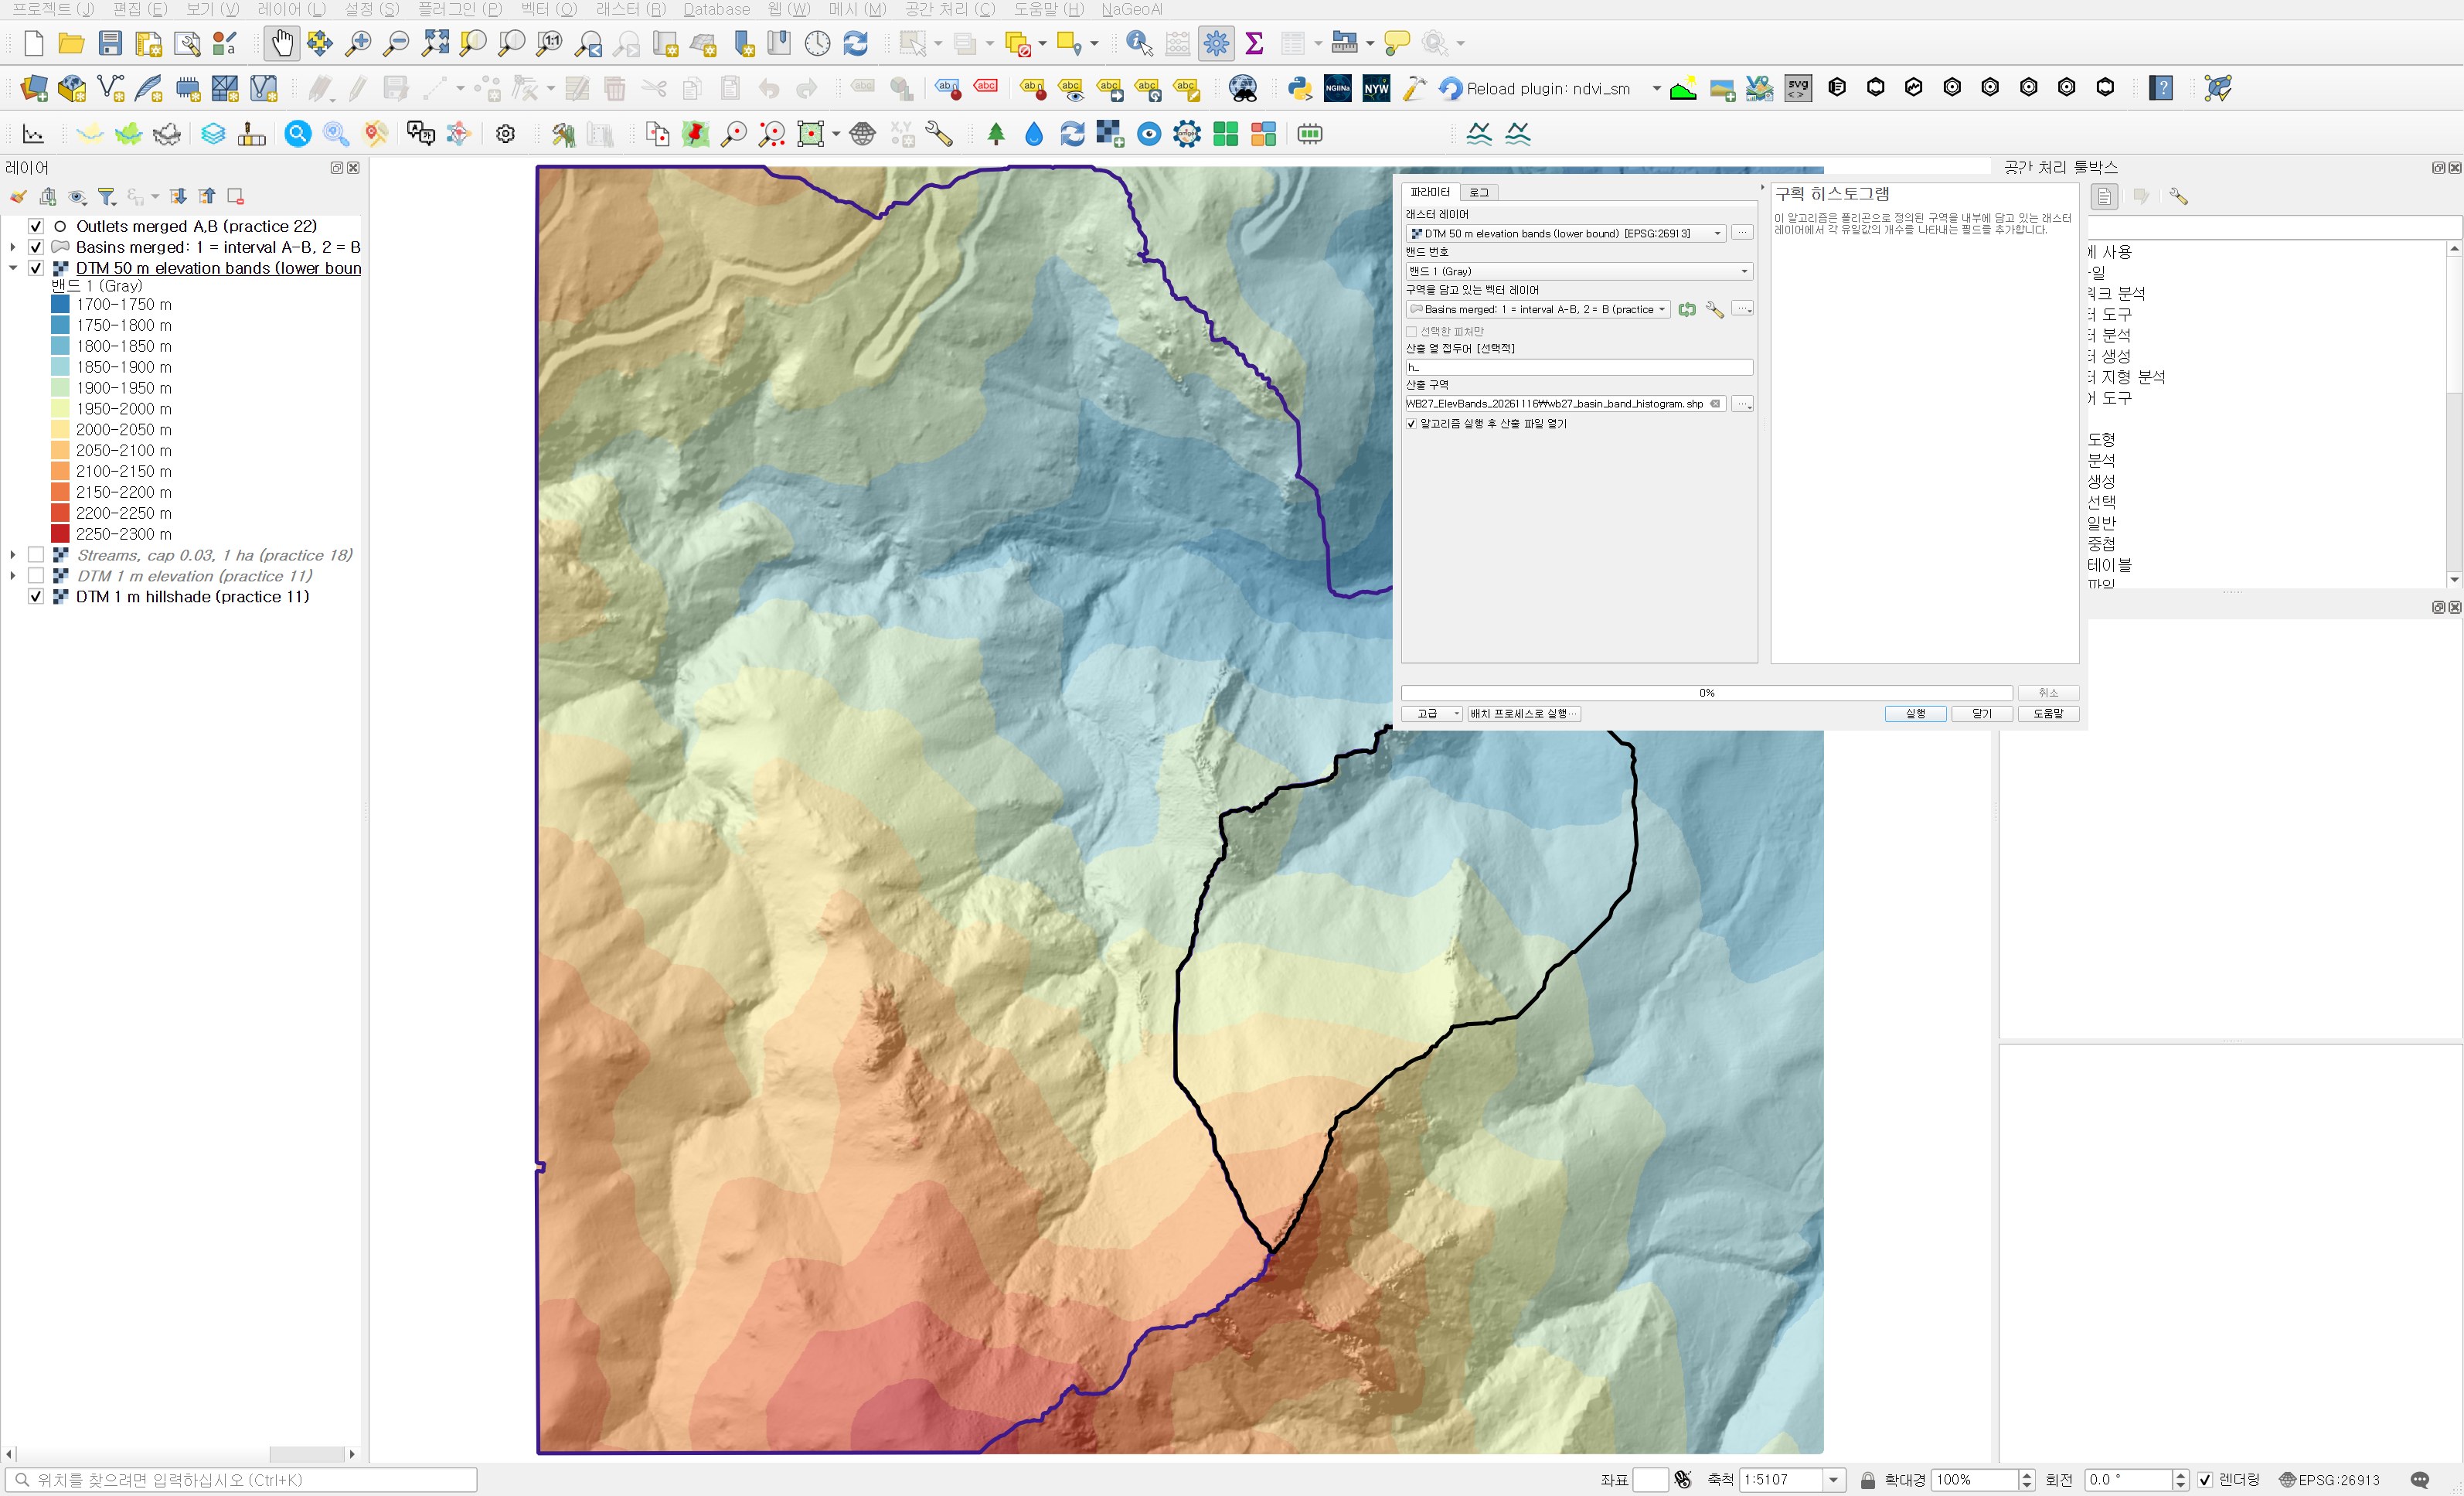
실행은 0.28초였다. 속성 표를 열면 h_1750부터 h_2250까지 11개 필드가 붙어 있다. 1700~1750 구간은 DTM 전체에 89,224개 셀이 있지만 두 유역 안에는 한 셀도 없어서 필드가 생기지 않았다. 두 유역의 최저 표고가 1,764.89 m, 1,765.33 m였으니 맞는 결과다.
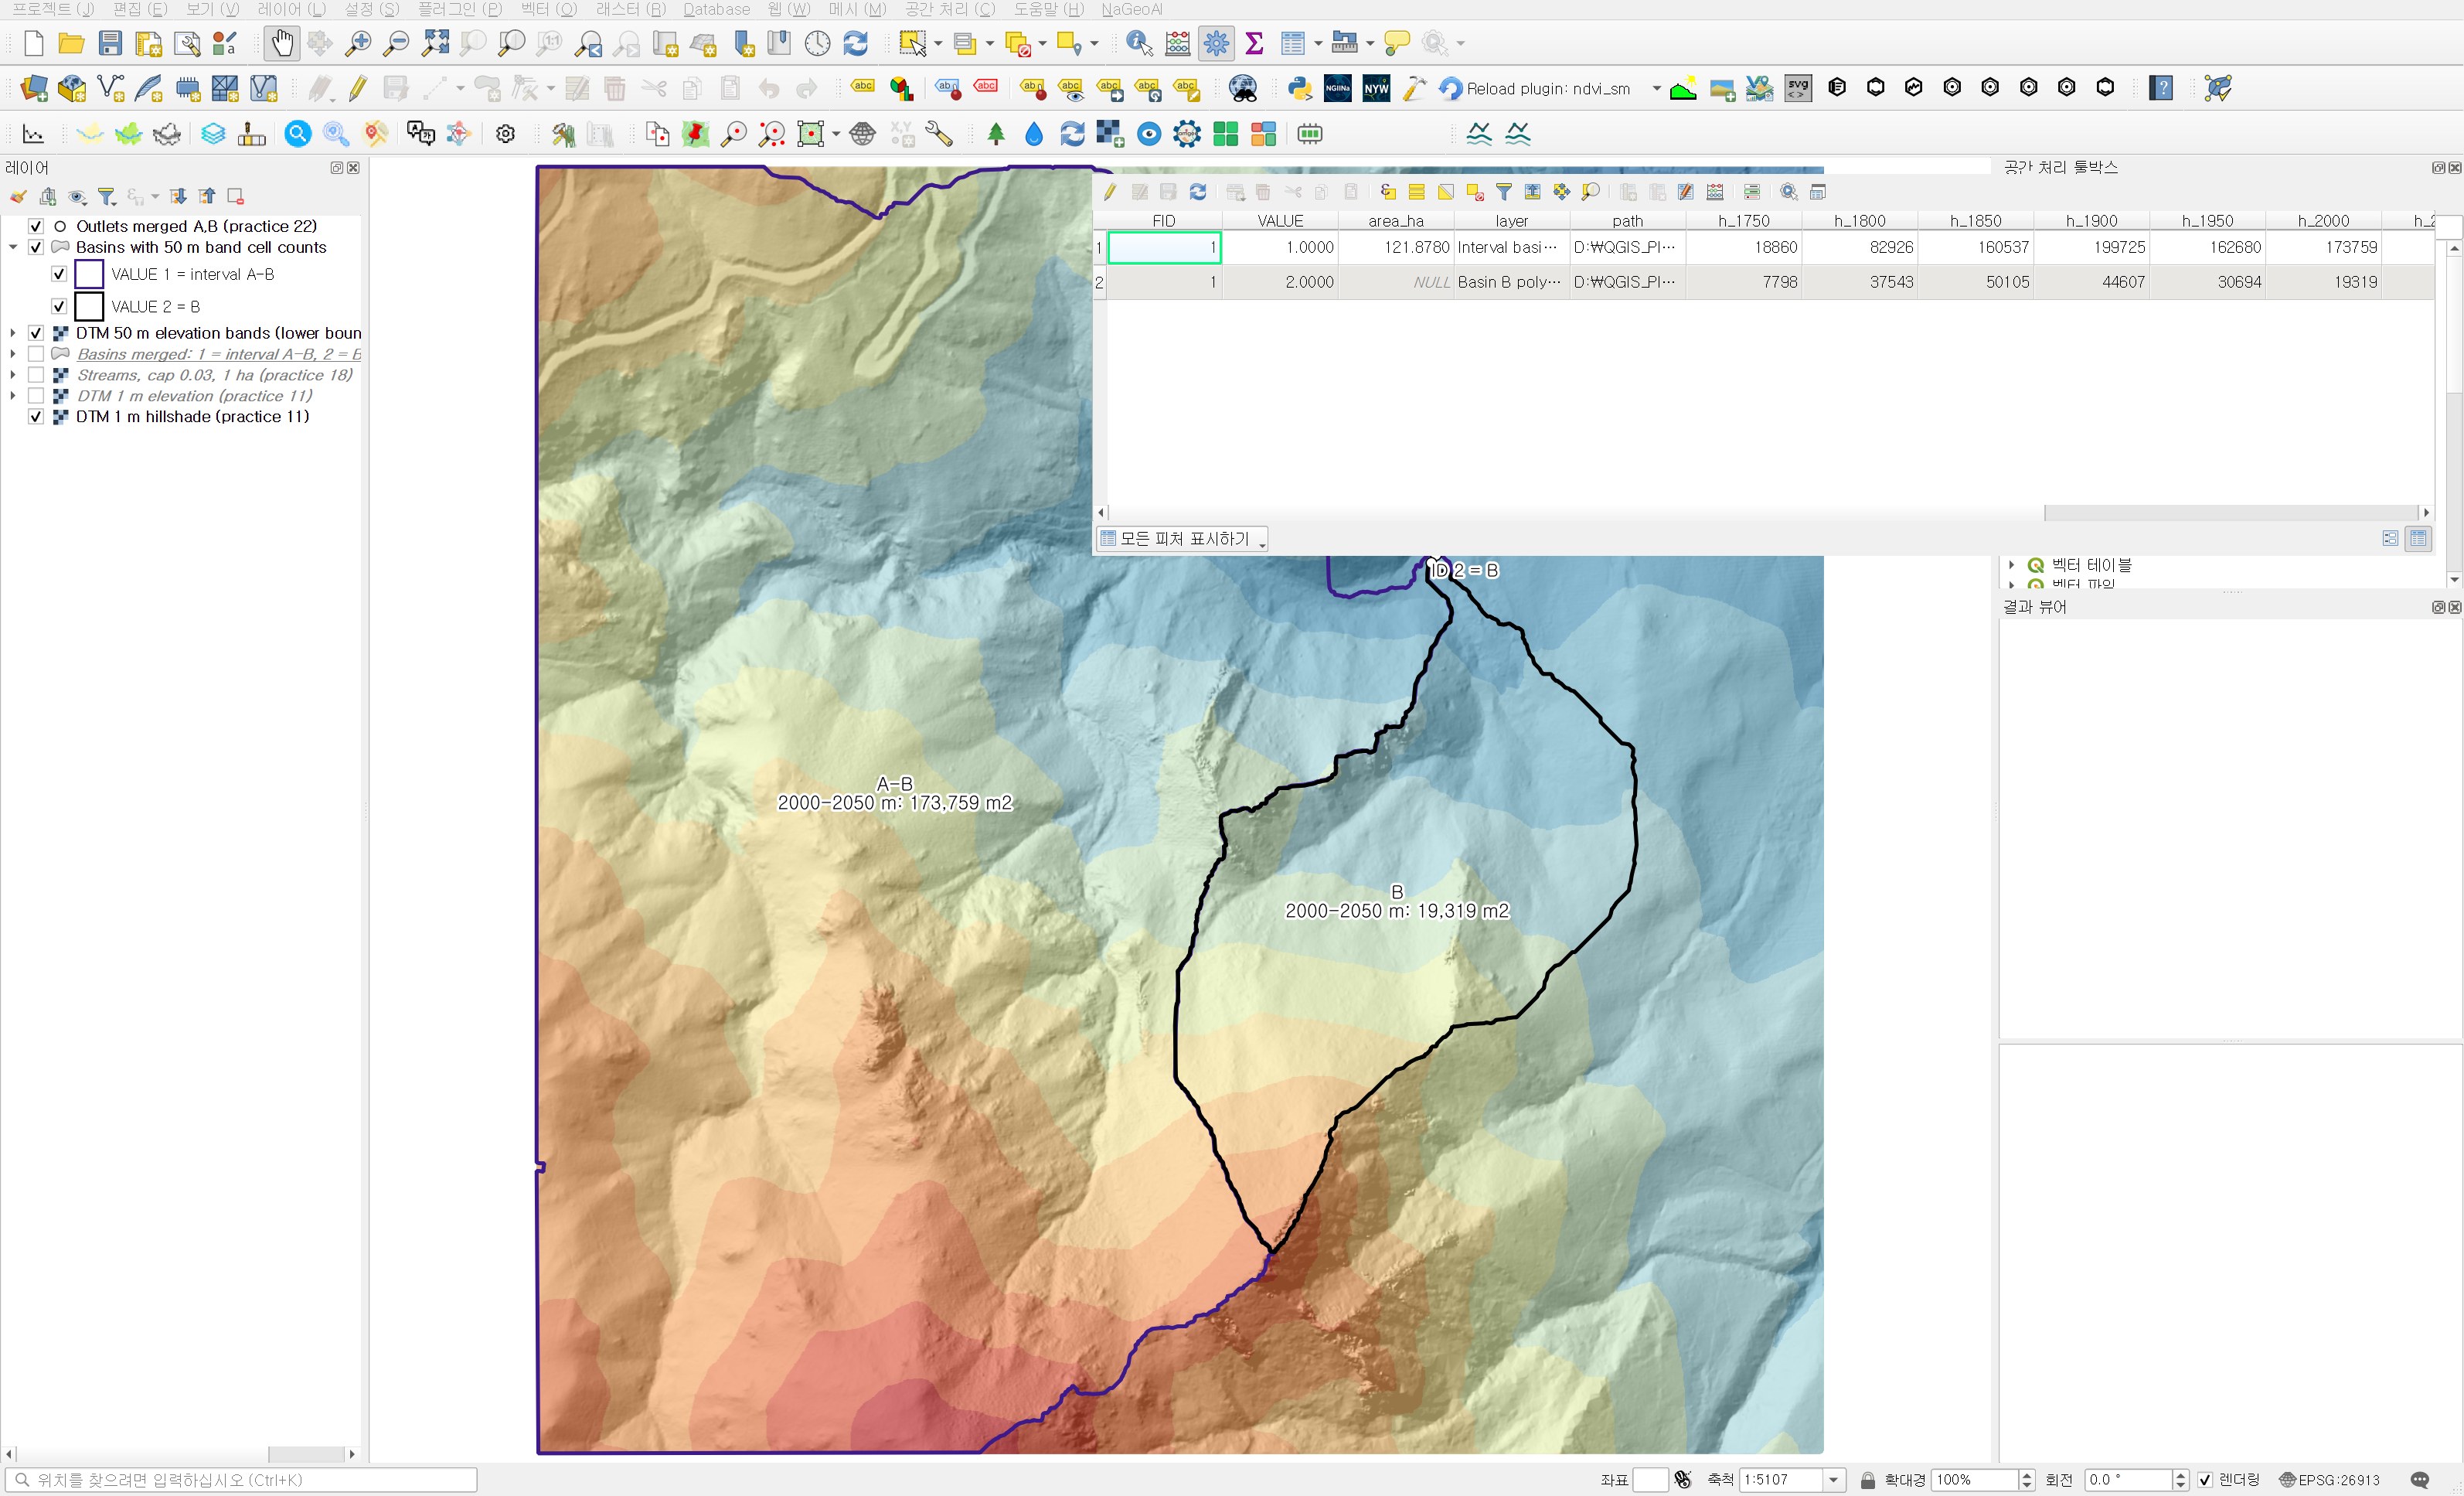
구간별 면적과 비율
셀 수를 유역 전체 셀 수로 나눠 비율로 바꿨다. 면적이 다섯 배 넘게 차이 나는 두 유역을 비교하려면 절대 면적보다 비율이 낫다.
| 표고 구간 | 중간유역 A−B 면적(m²) | 비율 | B 유역 면적(m²) | 비율 |
|---|---|---|---|---|
| 1750~1800 m | 18,860 | 1.55% | 7,798 | 3.69% |
| 1800~1850 m | 82,926 | 6.80% | 37,543 | 17.76% |
| 1850~1900 m | 160,537 | 13.17% | 50,105 | 23.71% |
| 1900~1950 m | 199,725 | 16.39% | 44,607 | 21.10% |
| 1950~2000 m | 162,680 | 13.35% | 30,694 | 14.52% |
| 2000~2050 m | 173,759 | 14.26% | 19,319 | 9.14% |
| 2050~2100 m | 153,334 | 12.58% | 11,747 | 5.56% |
| 2100~2150 m | 147,376 | 12.09% | 7,605 | 3.60% |
| 2150~2200 m | 74,906 | 6.15% | 1,913 | 0.91% |
| 2200~2250 m | 33,309 | 2.73% | 41 | 0.02% |
| 2250~2300 m | 11,368 | 0.93% | 0 | 0% |
| 합계 | 1,218,780 | 100% | 211,372 | 100% |
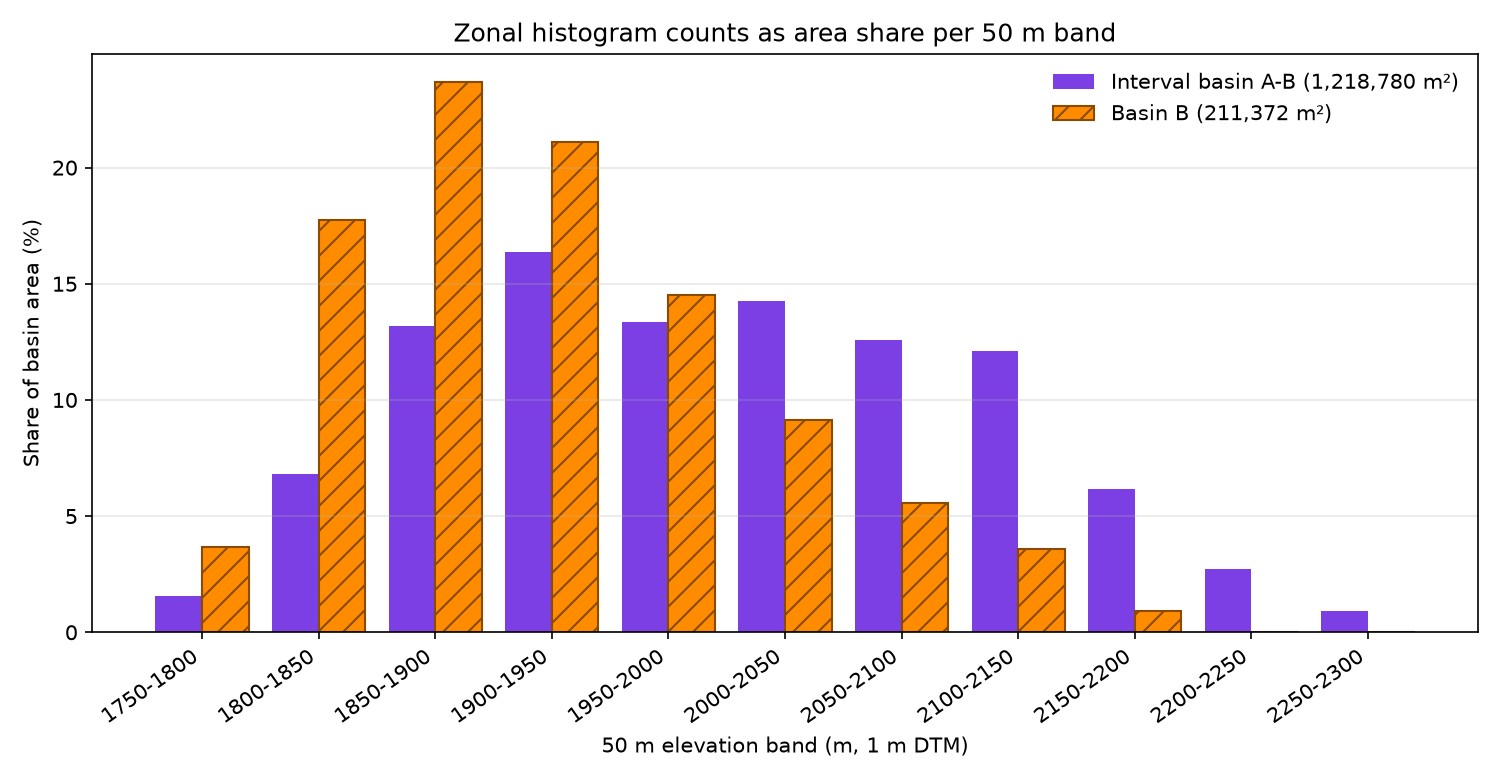
두 유역의 모양이 확실히 다르다. B는 1850~1900 m 구간이 23.71%로 가장 넓고, 그 위로 갈수록 빠르게 줄어든다. 1850~2000 m 세 구간에 면적의 59.33%가 몰려 있고, 2150 m 이상은 0.92%뿐이다. 유출구에서 멀지 않은 낮은 땅에 몸통이 있는 유역이다.
중간유역은 가장 넓은 구간(1900~1950 m)도 16.39%에 그친다. 대신 1850 m부터 2150 m까지 여섯 구간이 각각 12~16%로 거의 평평하게 이어진다. 2150 m 이상도 9.81%나 된다. 표고 폭 전체에 면적이 고르게 깔린 유역이라는 뜻이다. 26편에서 본 "2,000 m 이상 48.7% 대 19.2%"가 어디서 나왔는지 이 표에서 구간별로 보인다.
실무에서 이 차이가 의미 있는 건 표고가 기온, 강수 형태, 적설과 연결되기 때문이다. 같은 강우라도 높은 구간 비중이 큰 중간유역은 눈으로 내리는 면적이 더 넓을 수 있다. 다만 이 자료만으로 적설 면적이나 유출 시점을 말할 수는 없다. 그러려면 이 지역 기온 감률이나 관측 적설 자료를 따로 붙여야 한다. 여기서 확인한 건 표고별 면적 분포까지다.
독립 계산으로 확인
재분류 결과가 표대로 나왔는지, 히스토그램이 셀을 제대로 셌는지 별도 스크립트로 다시 계산했다. numpy로 표고를 50으로 나눠 내림한 뒤 50을 곱해 같은 구간 코드를 만들었더니 QGIS 출력과 225만 셀 전체에서 다른 셀이 0개였다. 폴리곤을 셀 중심 기준으로 같은 격자에 래스터화해 구간별 셀 수를 센 값도 속성 표와 두 유역 모든 구간에서 같았다. 유역별 셀 수 합계는 1,218,780과 211,372로 26편 면적과 정확히 일치한다.
실무에서 챙길 것
- 재분류 범위 경계 기본값은 "최소 < 값 <= 최대"다. 구간 이름을 아래 경계 기준으로 붙일 거면 "최소 <= 값 < 최대"로 바꾼다.
- 재분류 표가 DTM 전체 범위를 덮는지 먼저 확인한다. 범위 밖 값은 "Use NoData when no range matches value"를 끄면 원래 값으로 남아 엉뚱한 코드처럼 섞인다.
- 구역히스토그램은 셀 중심이 폴리곤 안에 있는 셀만 센다. 이번처럼 래스터에서 만든 폴리곤이면 셀 수와 면적이 딱 맞지만, 다른 출처 경계라면 경계 셀 때문에 합계가 폴리곤 면적과 달라진다. 합계를 면적과 한 번 비교해 둔다.
- 구간이 많아지면 shp 필드가 늘어나 속성 표가 옆으로 길어진다. 비교 표를 만들 때는 CSV로 내보내거나 이번처럼 비율 표로 옮긴다.
- 50 m라는 간격은 이번 유역 표고 폭(약 520 m)에서 10개 남짓 구간이 나오도록 고른 값이다. 표고 폭이 좁은 유역이면 간격을 줄여야 분포 모양이 보인다.
다음 회차
표고 분포는 확인했으니 다음은 경사다. 26편에서 표준편차가 크다고 경사가 급한 건 아니라고 했는데, 실제로 DTM에서 경사 래스터를 만들어 두 유역의 경사 분포를 같은 방식(구간 재분류와 구역히스토그램)으로 비교해 보려고 한다.
작업 메모
이번 회차는 QGIS 시작 스크립트로 같은 대화상자에 값을 넣어 실행했고, 화면은 그때 캡처한 것이다. 원본 프로젝트는 그대로 두고 복사본(QGIS_Play_NaGeoAI_20261116_27_elevbands.qgz)에서 작업했다. 자료 출처는 USGS 3DEP(The National Map) 타일 13SDE474426이고, 원본 DTM은 재배포하지 않는다. 그림 5와 비율, 독립 계산은 출력 파일을 다시 읽는 별도 스크립트로 만든 것이다. QGIS 3.44.15. SHA-256 앞 12자리:
- 입력 DTM 069a9c249240
- 입력 병합 폴리곤 .shp / .dbf 235891ed214a / 67d3965a6d72
- 50 m 구간 래스터 8ac146e8da50
- 구역히스토그램 .shp / .dbf 235891ed214a / bf5a73f6f6d7


댓글 없음:
댓글 쓰기