
25편에서 A 유출구의 전체 유역에서 B 유역을 빼 중간유역(A−B) 폴리곤을 만들었다. 넓이는 121.878 ha와 21.1372 ha로 이미 알고 있다. 이번에는 두 유역이 지형으로 어떻게 다른지 보고 싶었다. 같은 유출구 근처로 모이는 두 유역인데, 하나는 본류 상류 쪽을 넓게 품고 있고 다른 하나는 짧은 지류다. 눈으로 음영기복도를 보면 중간유역 쪽이 더 높은 능선까지 올라가는 것 같지만, 그걸 숫자로 말하려면 구역통계(Zonal statistics)가 필요하다. 폴리곤 안에 들어오는 DTM 셀들의 평균·중앙값·최저·최고 표고를 뽑는 작업이다.
방법은 단순하게 잡았다. 두 폴리곤을 한 레이어로 병합한 뒤 QGIS 구역통계를 한 번 돌려 표 한 장으로 비교한다. 그리고 같은 통계를 22편 Watershed 래스터(값 1 = A 몫, 값 2 = B)를 구역으로 써서 한 번 더 뽑아, 폴리곤 경로와 래스터 경로가 같은 셀을 세고 있는지 맞춰 본다. 결과는 두 경로가 셀 수까지 같았고, 평균 표고는 중간유역이 약 76 m 높았다.
자료
11편 1 m DTM(USGS 3DEP 타일 13SDE474426, NAD83 UTM 13N EPSG:26913, 지면점으로 만든 DTM)을 통계 대상으로 쓴다. 폴리곤과 구역 래스터는 이전 회차 출력을 새 입력 폴더로 복사했고, 복사본 해시는 원본과 같다.
| 입력 | 원래 출처 | 내용 |
|---|---|---|
| wb26_input_dtm1m.tif | 11편 DTM | 1500×1500 셀, 1 m, float32, NoData −32768 |
| wb26_input_interval_A_minus_B.shp | 25편 wb25_interval_area | 중간유역 1,218,780 m², 유효한 폴리곤(7 m² 구멍 1개), VALUE 1 |
| wb26_input_poly_B.shp | 24편 wb24_poly_ab_1 | B 유역 211,372 m², 유효한 폴리곤, VALUE 2 |
| wb26_input_watershed_ab_wb22.tif | 22편 Watershed(A, B 순서) | 값 1 1,218,780개 셀, 값 2 211,372개 셀, DTM과 같은 격자 |
DTM 전체에는 NoData 셀이 1,834개 있지만 두 유역 안에는 하나도 없었다. 그래서 아래 통계의 셀 수가 곧 폴리곤 면적(m²)과 같아진다.
두 폴리곤을 한 레이어로 병합
공간 처리 툴박스 → 벡터 일반 → 벡터 레이어 병합(Merge vector layers)을 열었다. 구역통계를 레이어마다 따로 돌려도 되지만, 그러면 결과가 파일 두 개로 흩어지고 비교할 때 다시 합쳐야 한다. 처음부터 한 레이어로 만들어 두는 편이 표를 읽기 편하다.
| 입력란 | 값 | 이유 |
|---|---|---|
| 입력 레이어 | Interval basin A minus B (practice 25), Basin B polygon (practice 24) | 비교할 두 유역 |
| 대상 좌표계 | 비워 둠 | 두 레이어 모두 EPSG:26913이라 재투영할 일이 없다 |
| Add source layer information | 체크(기본값) | layer, path 필드가 붙어 어느 행이 어느 파일에서 왔는지 남는다 |
| 병합한 산출물 | wb26_basins_merged.shp |
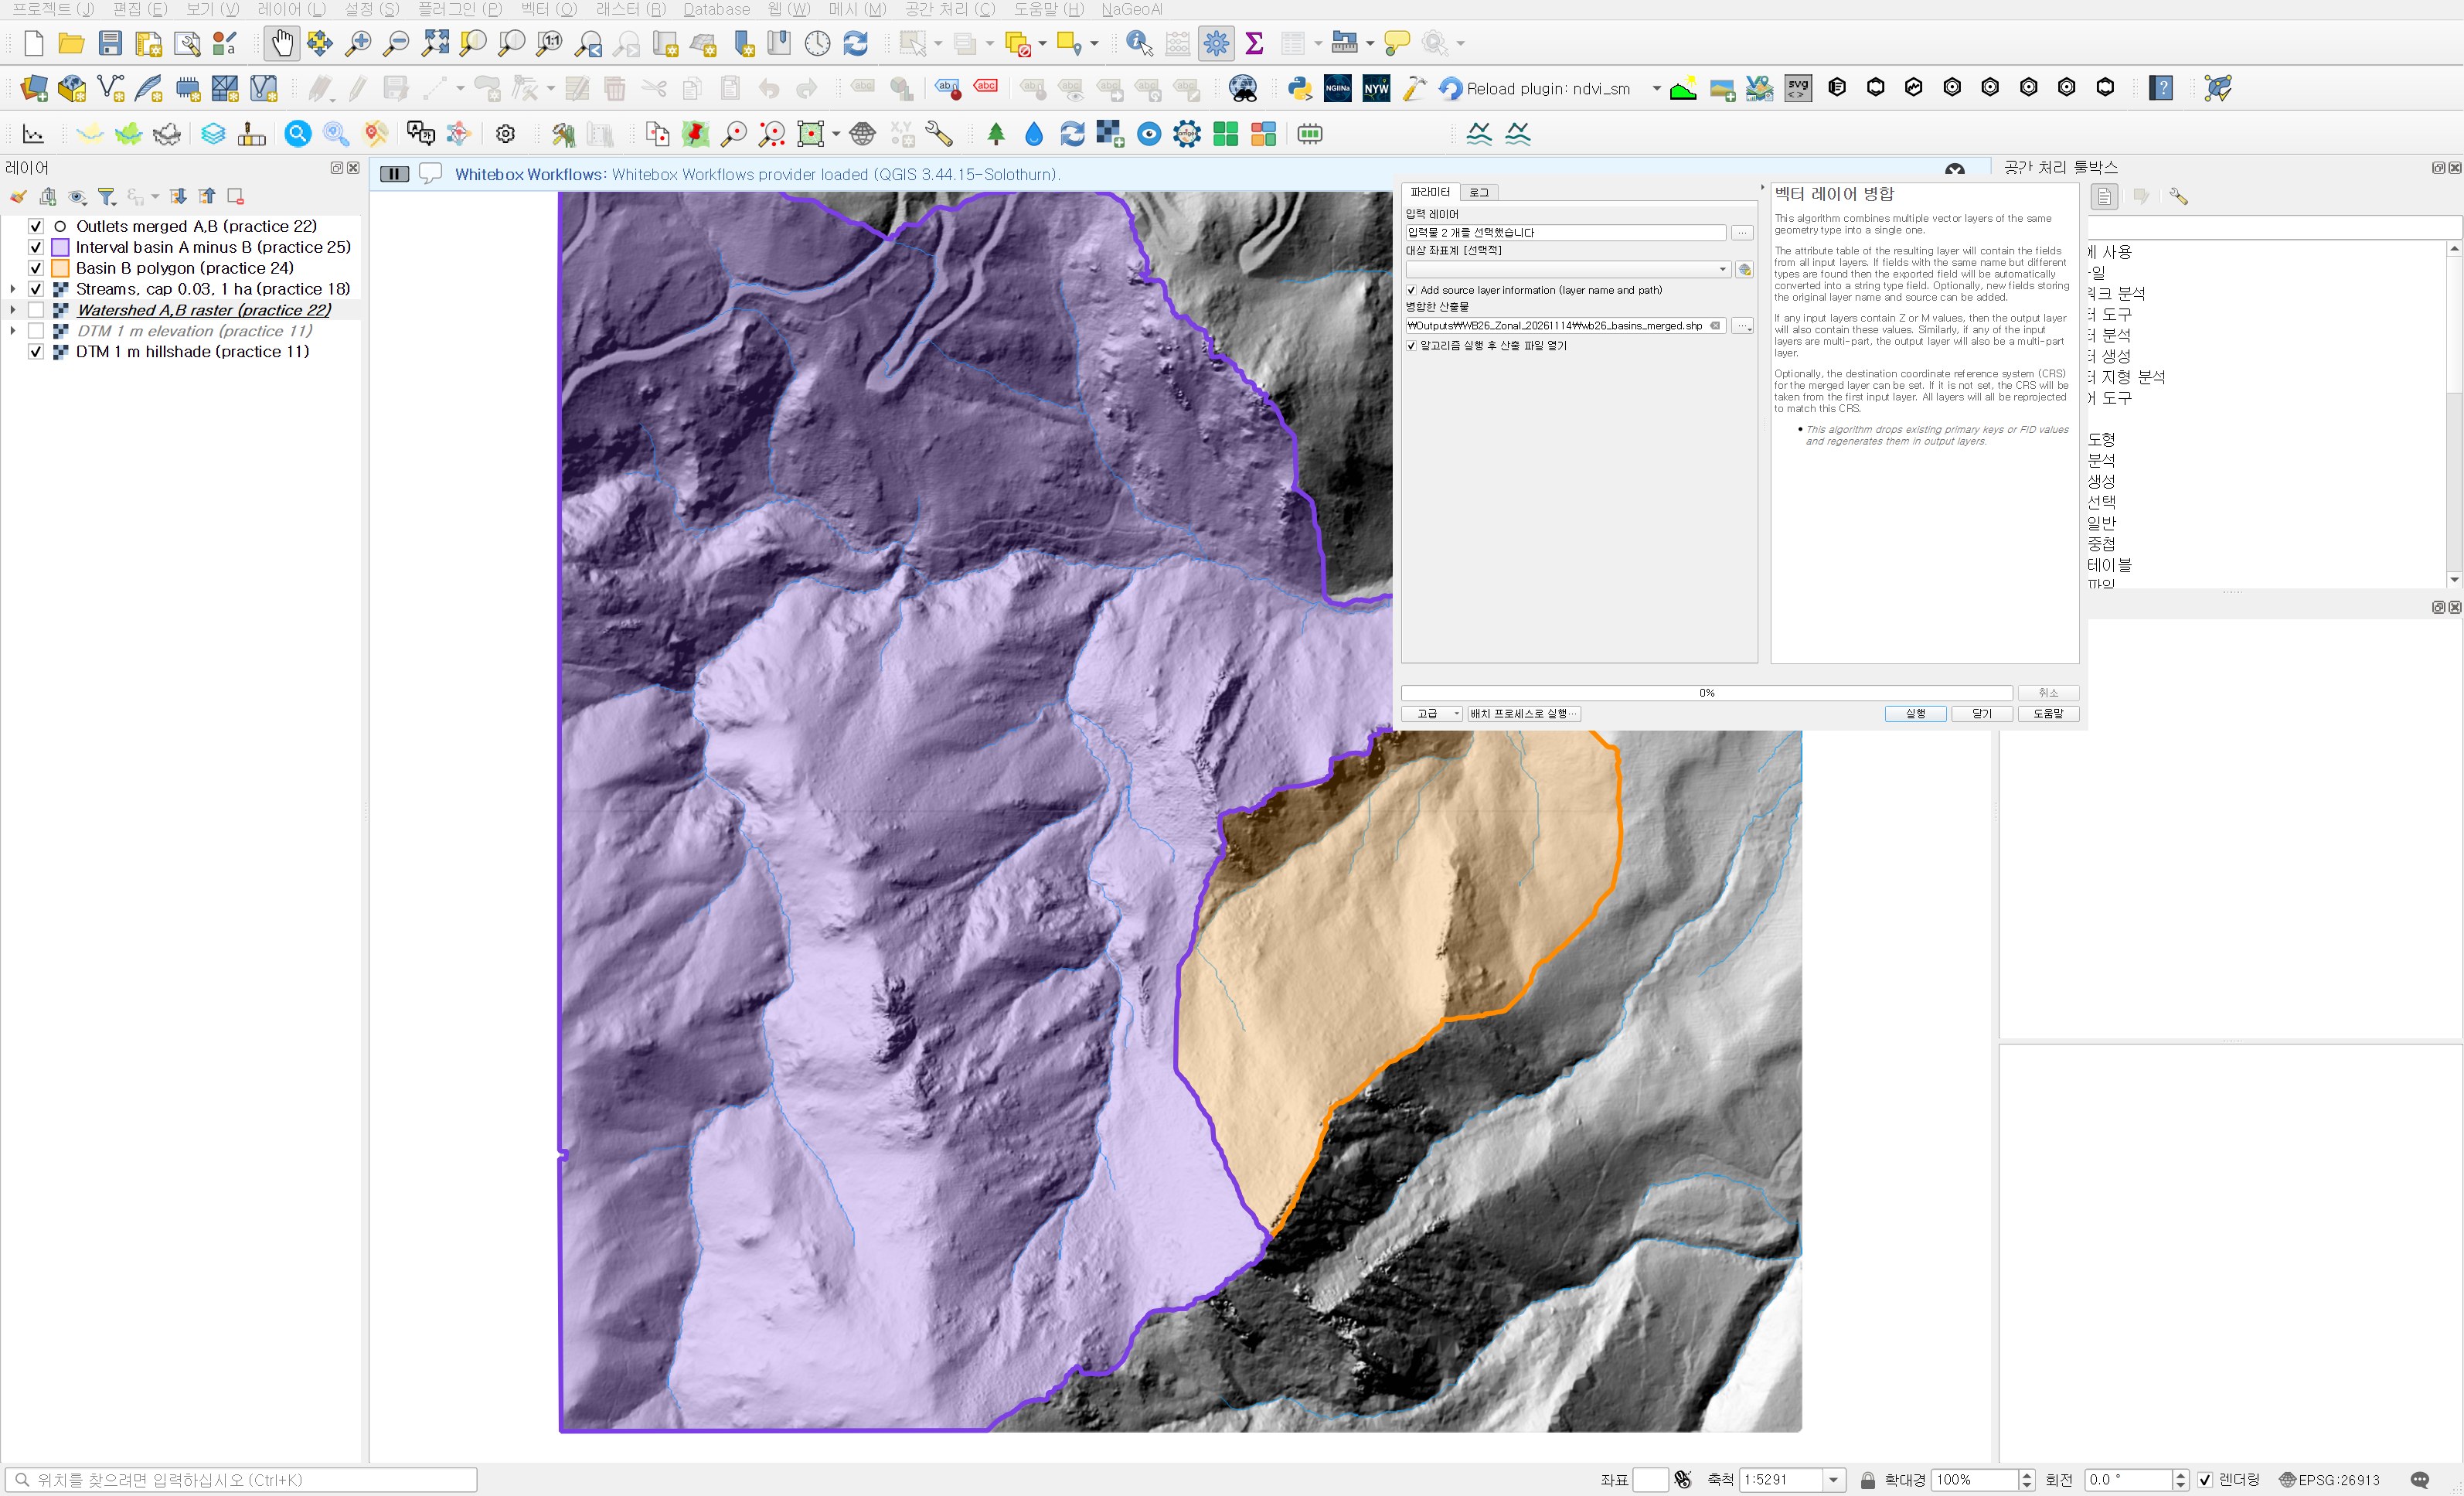
병합 결과는 폴리곤 2개, 둘 다 유효한 도형이다. 속성에서 하나 걸리는 게 있었다. 두 원본 모두 FID 필드 값이 1이라 병합 뒤에도 두 행이 FID 1로 같다. 구분은 VALUE(1, 2)나 layer 필드로 해야 한다. 그리고 area_ha 필드는 중간유역에만 있던 것이라 B 행은 NULL로 들어왔다. 병합은 필드를 합집합으로 만들 뿐 빈 값을 채워 주지 않는다.
구역통계
공간 처리 툴박스 → 래스터 분석 → 구역통계(Zonal statistics)를 썼다. 결과를 새 레이어로 내보내는 버전이라 원본 폴리곤에는 필드가 추가되지 않는다.
| 입력란 | 값 | 이유 |
|---|---|---|
| 입력 레이어 | Basins merged (interval + B) | 방금 병합한 레이어 |
| 래스터 레이어 | DTM 1 m elevation (practice 11) | 음영기복으로 표시한 레이어와 같은 파일을 하나 더 불러 통계용으로 썼다. 결과에는 차이가 없고 레이어 목록에서 헷갈리지 않게 하려는 것이다 |
| 래스터 밴드 | 밴드 1 | 단일 밴드 |
| 산출 열 접두어 | z_ | shp 필드 이름이 10자로 잘리므로 짧게. z_median, z_stdev도 10자 안에 들어간다 |
| 계산할 통계 | 개수, 평균, 중앙값, 표준편차, 최솟값, 최댓값, 범위 | 합계는 표고에서 의미가 없어 뺐다. 개수는 면적 검산용으로 넣었다 |
| 구역통계 | wb26_zonal_dtm.shp |
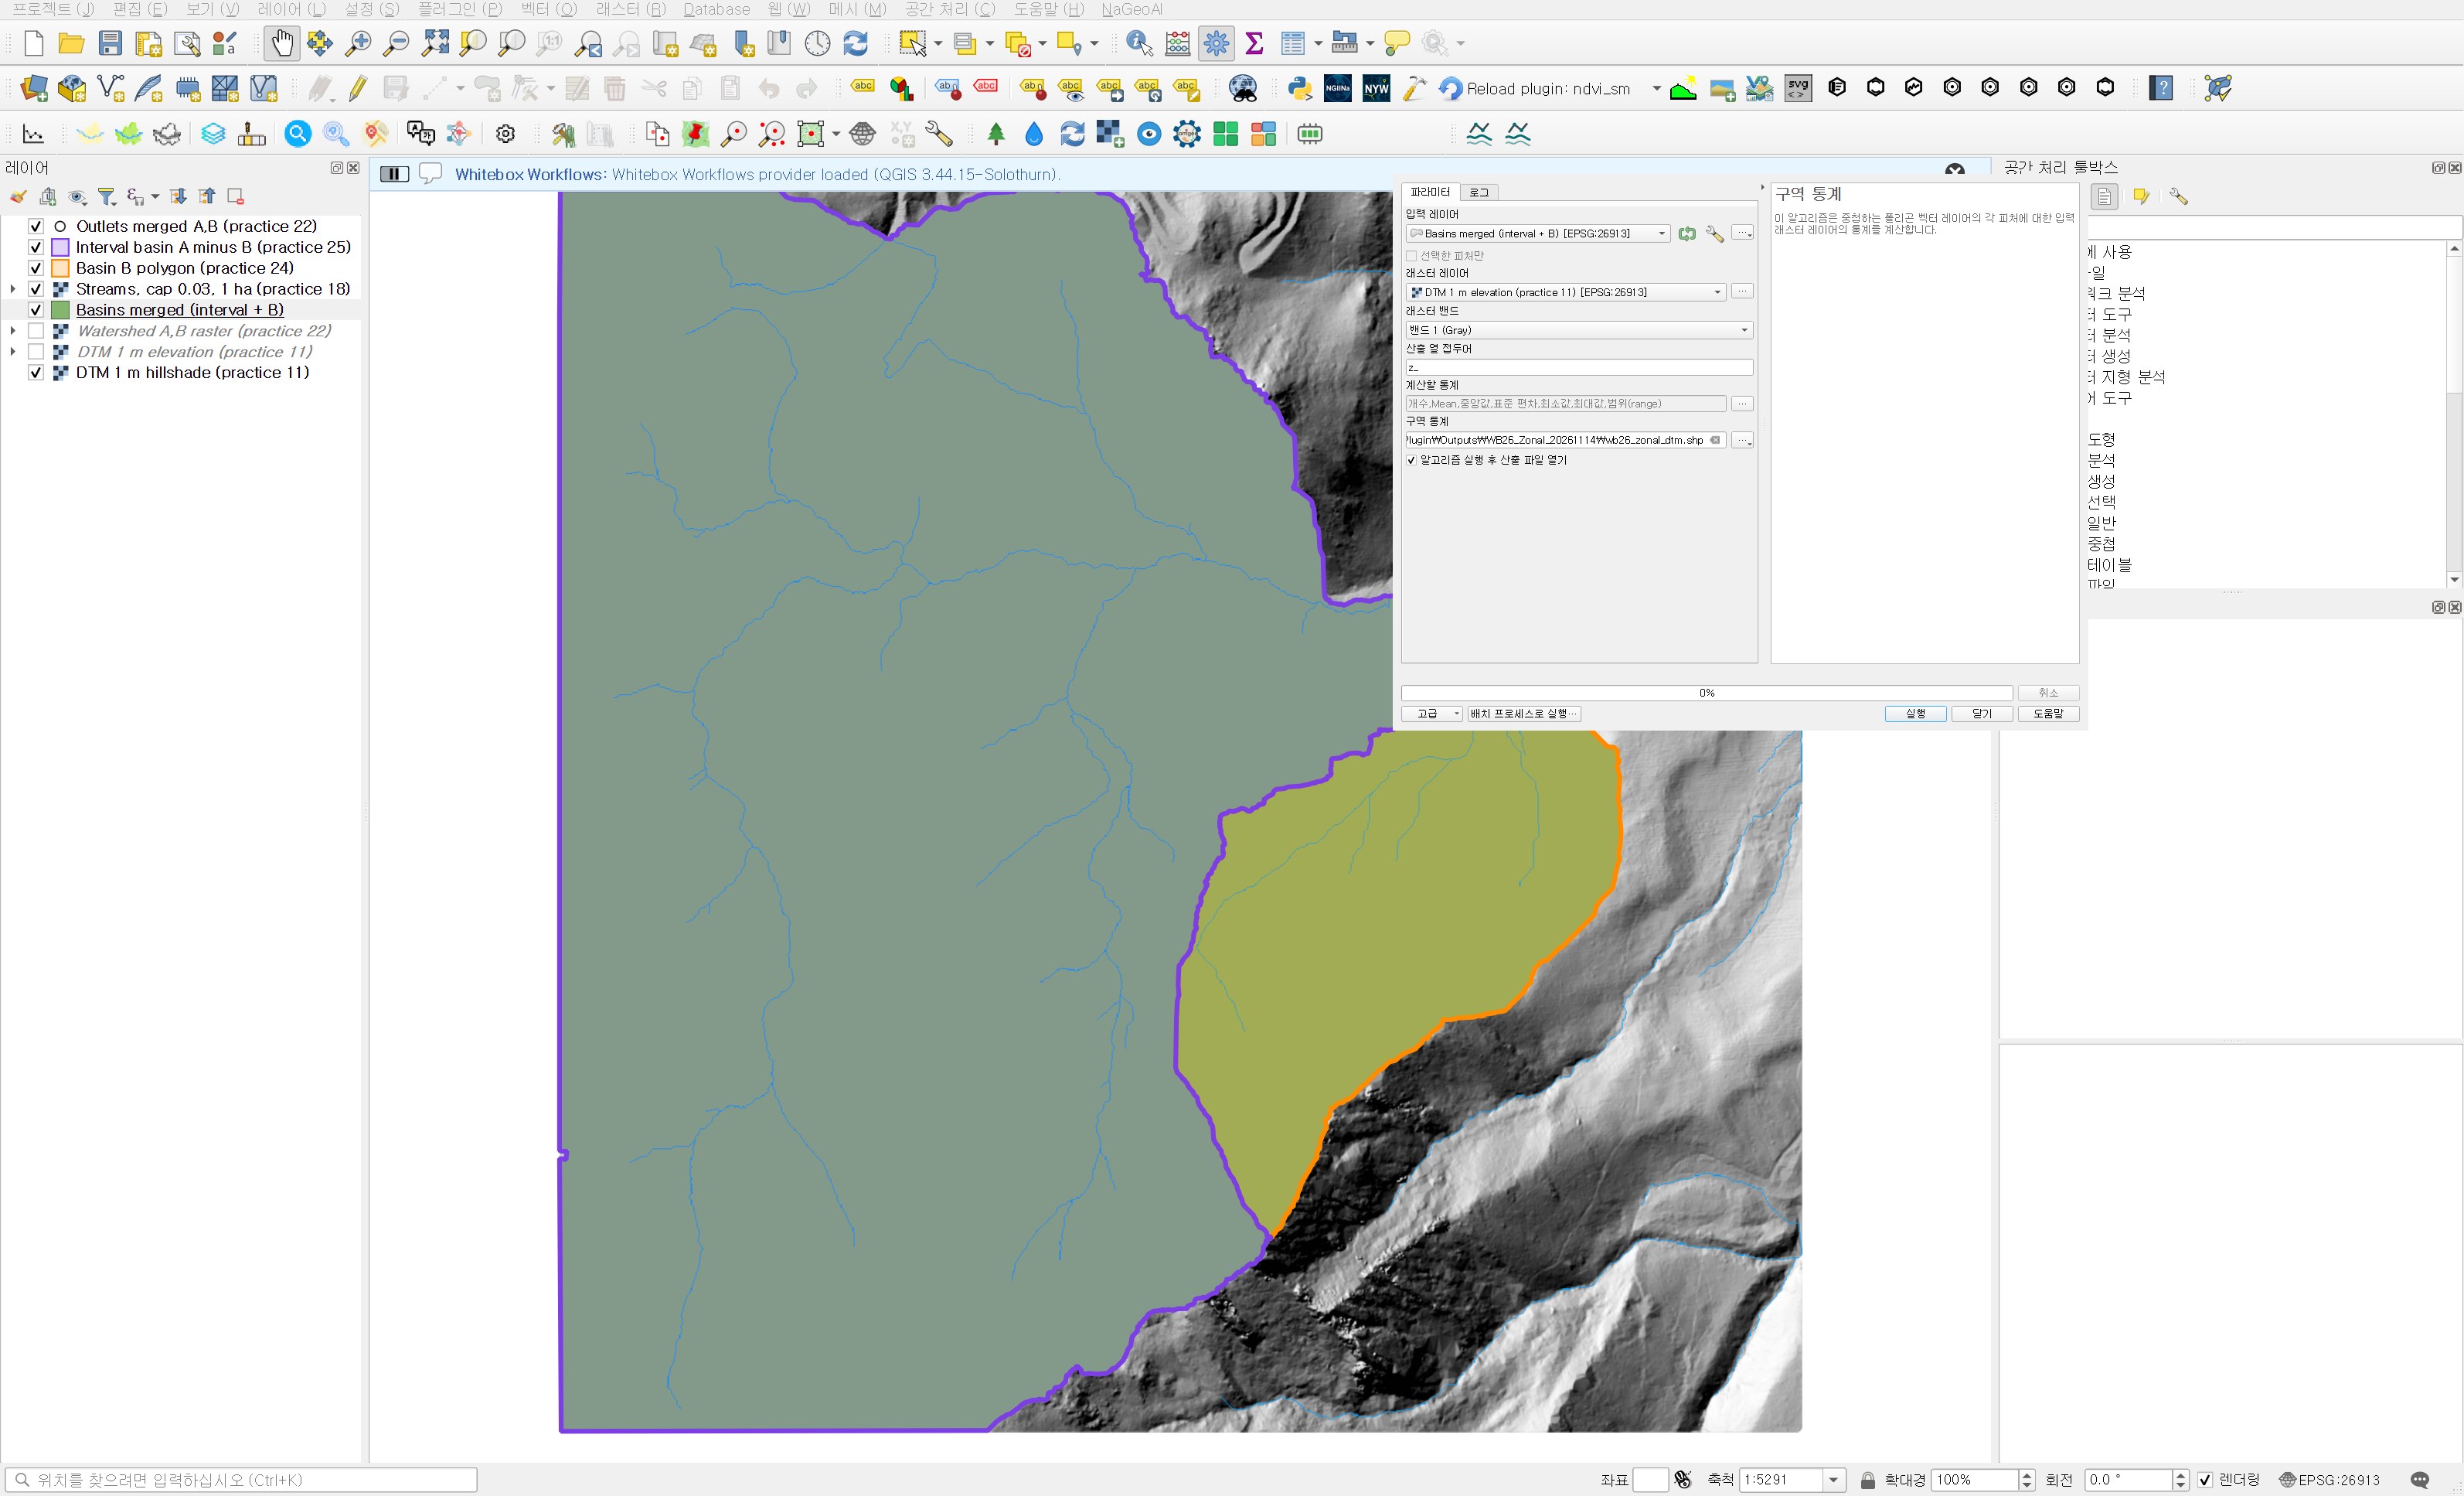
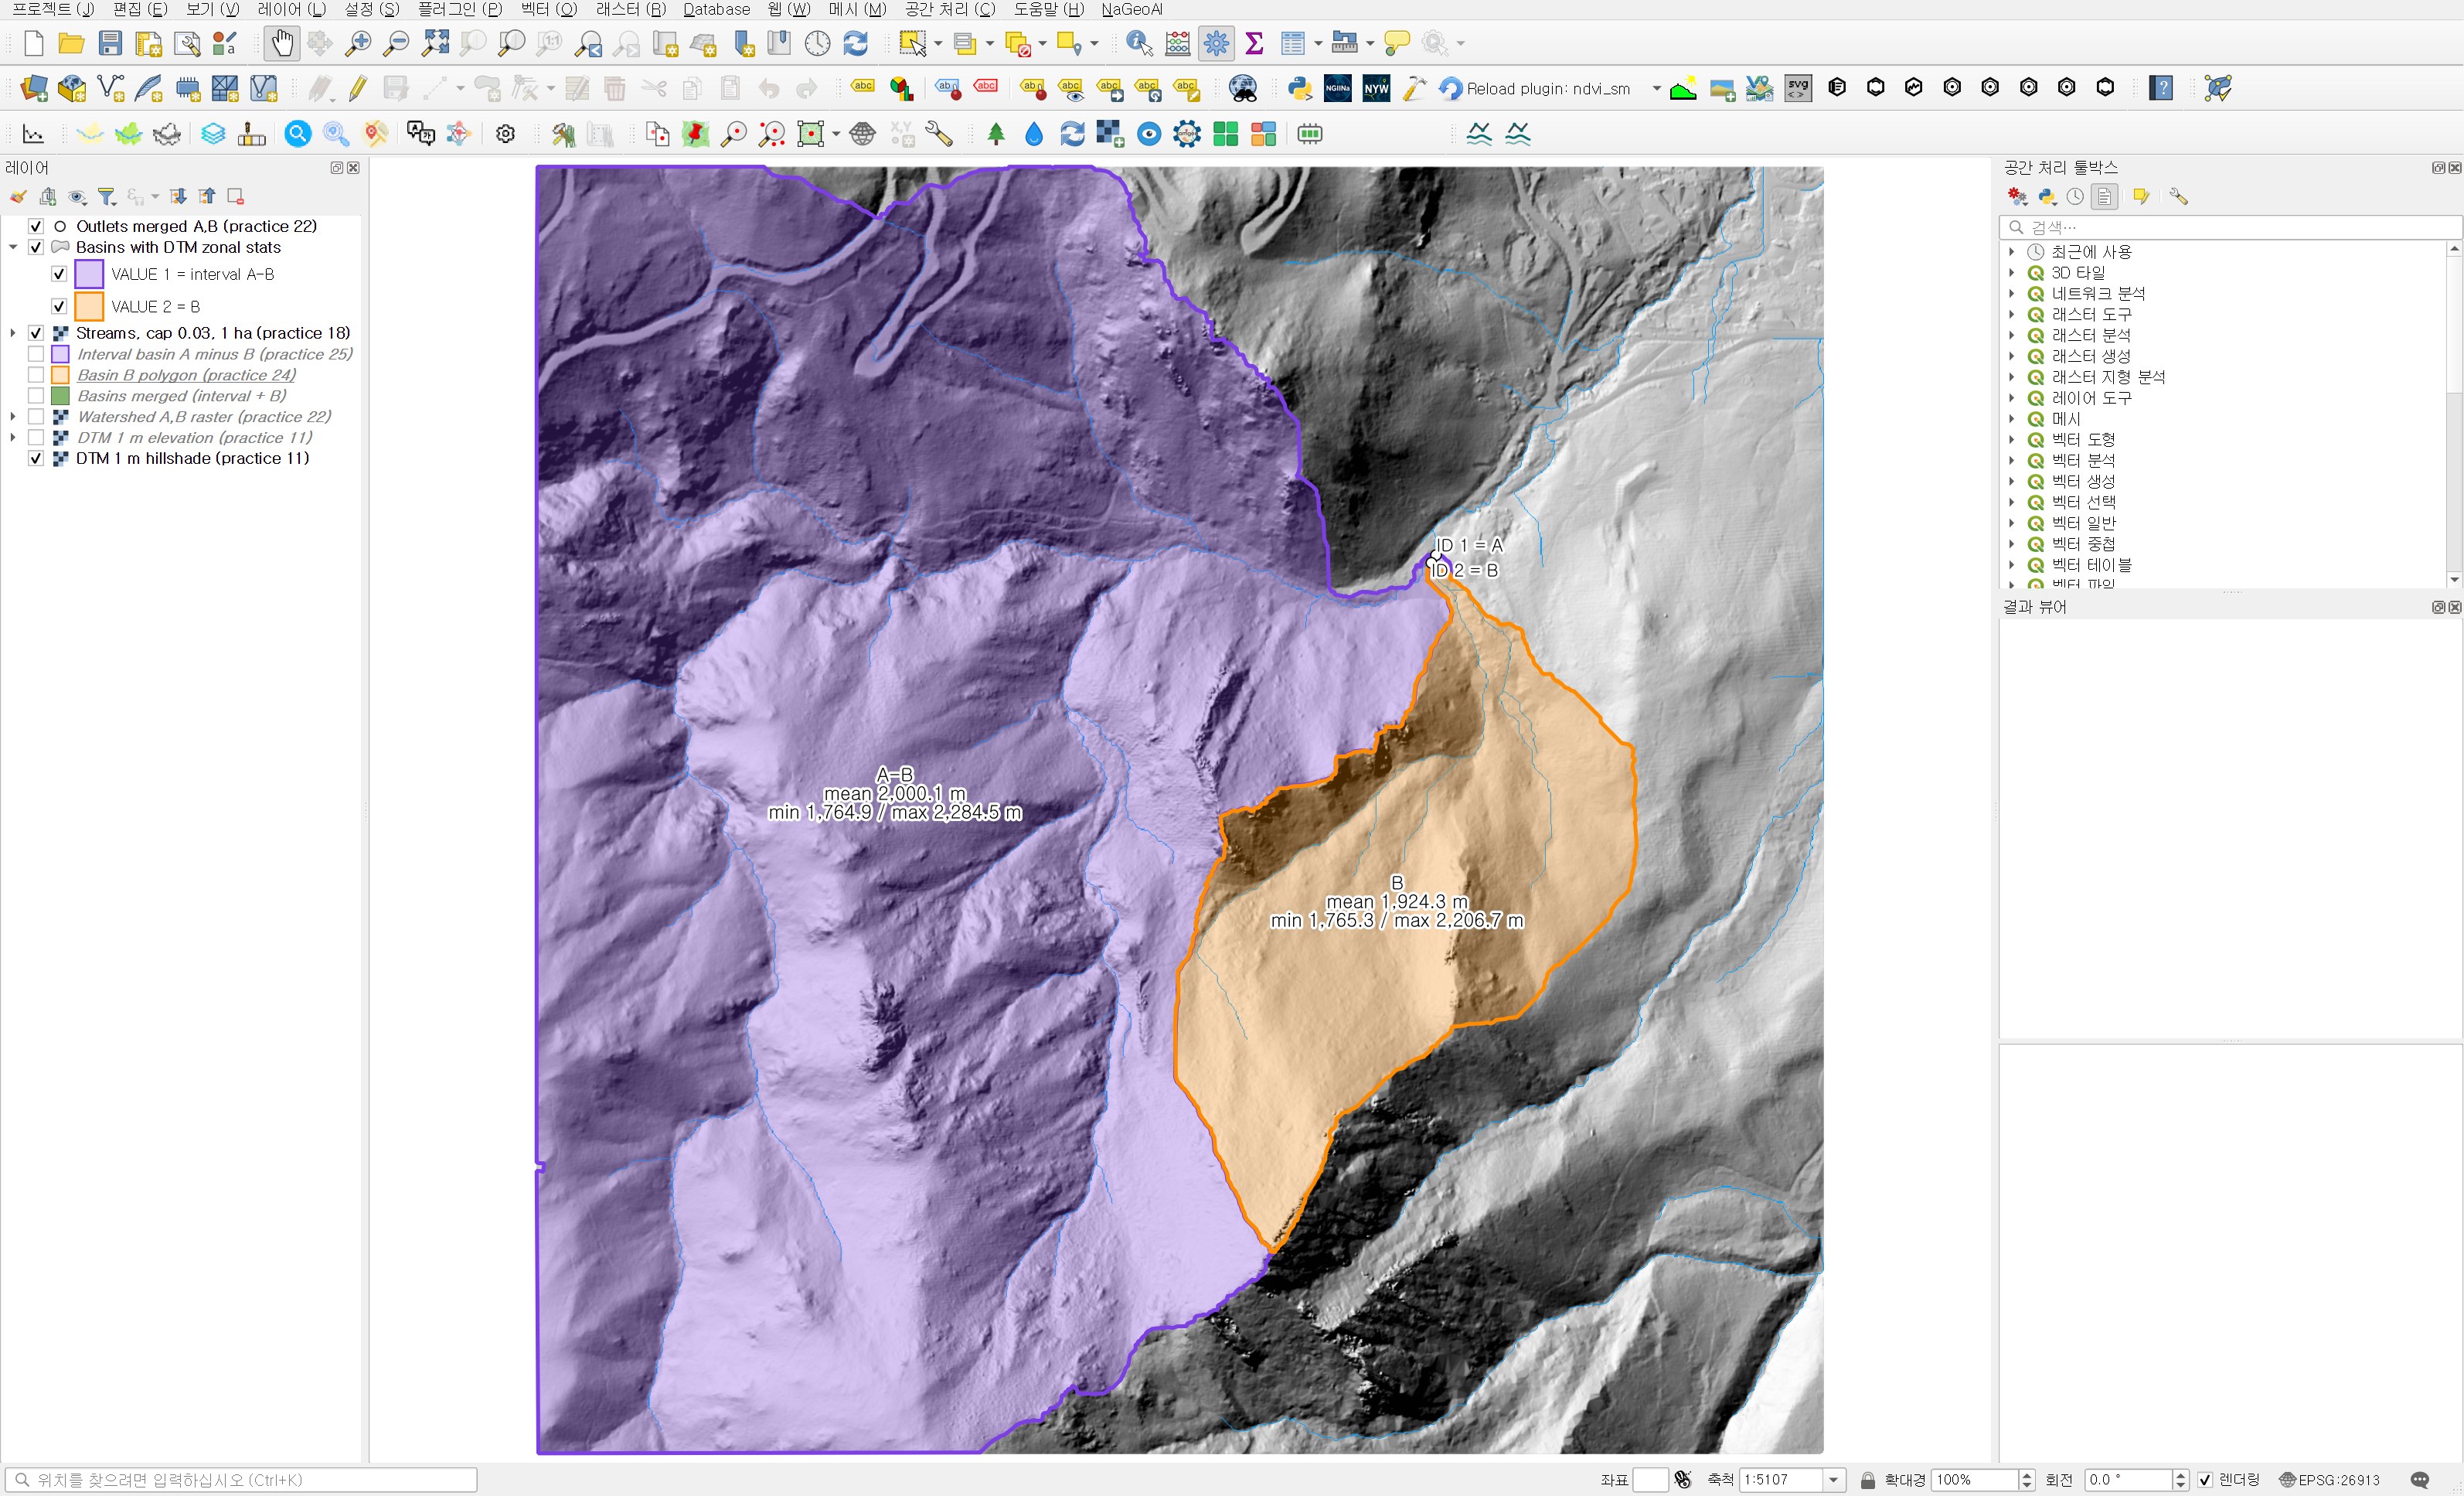
실행은 1초도 걸리지 않았다. 150만 셀 남짓을 두 폴리곤에 나눠 세는 정도라 1 m DTM이라도 부담이 없다. 결과 레이어를 VALUE별로 칠하고 평균·최저·최고 표고를 라벨로 얹어 보았다.
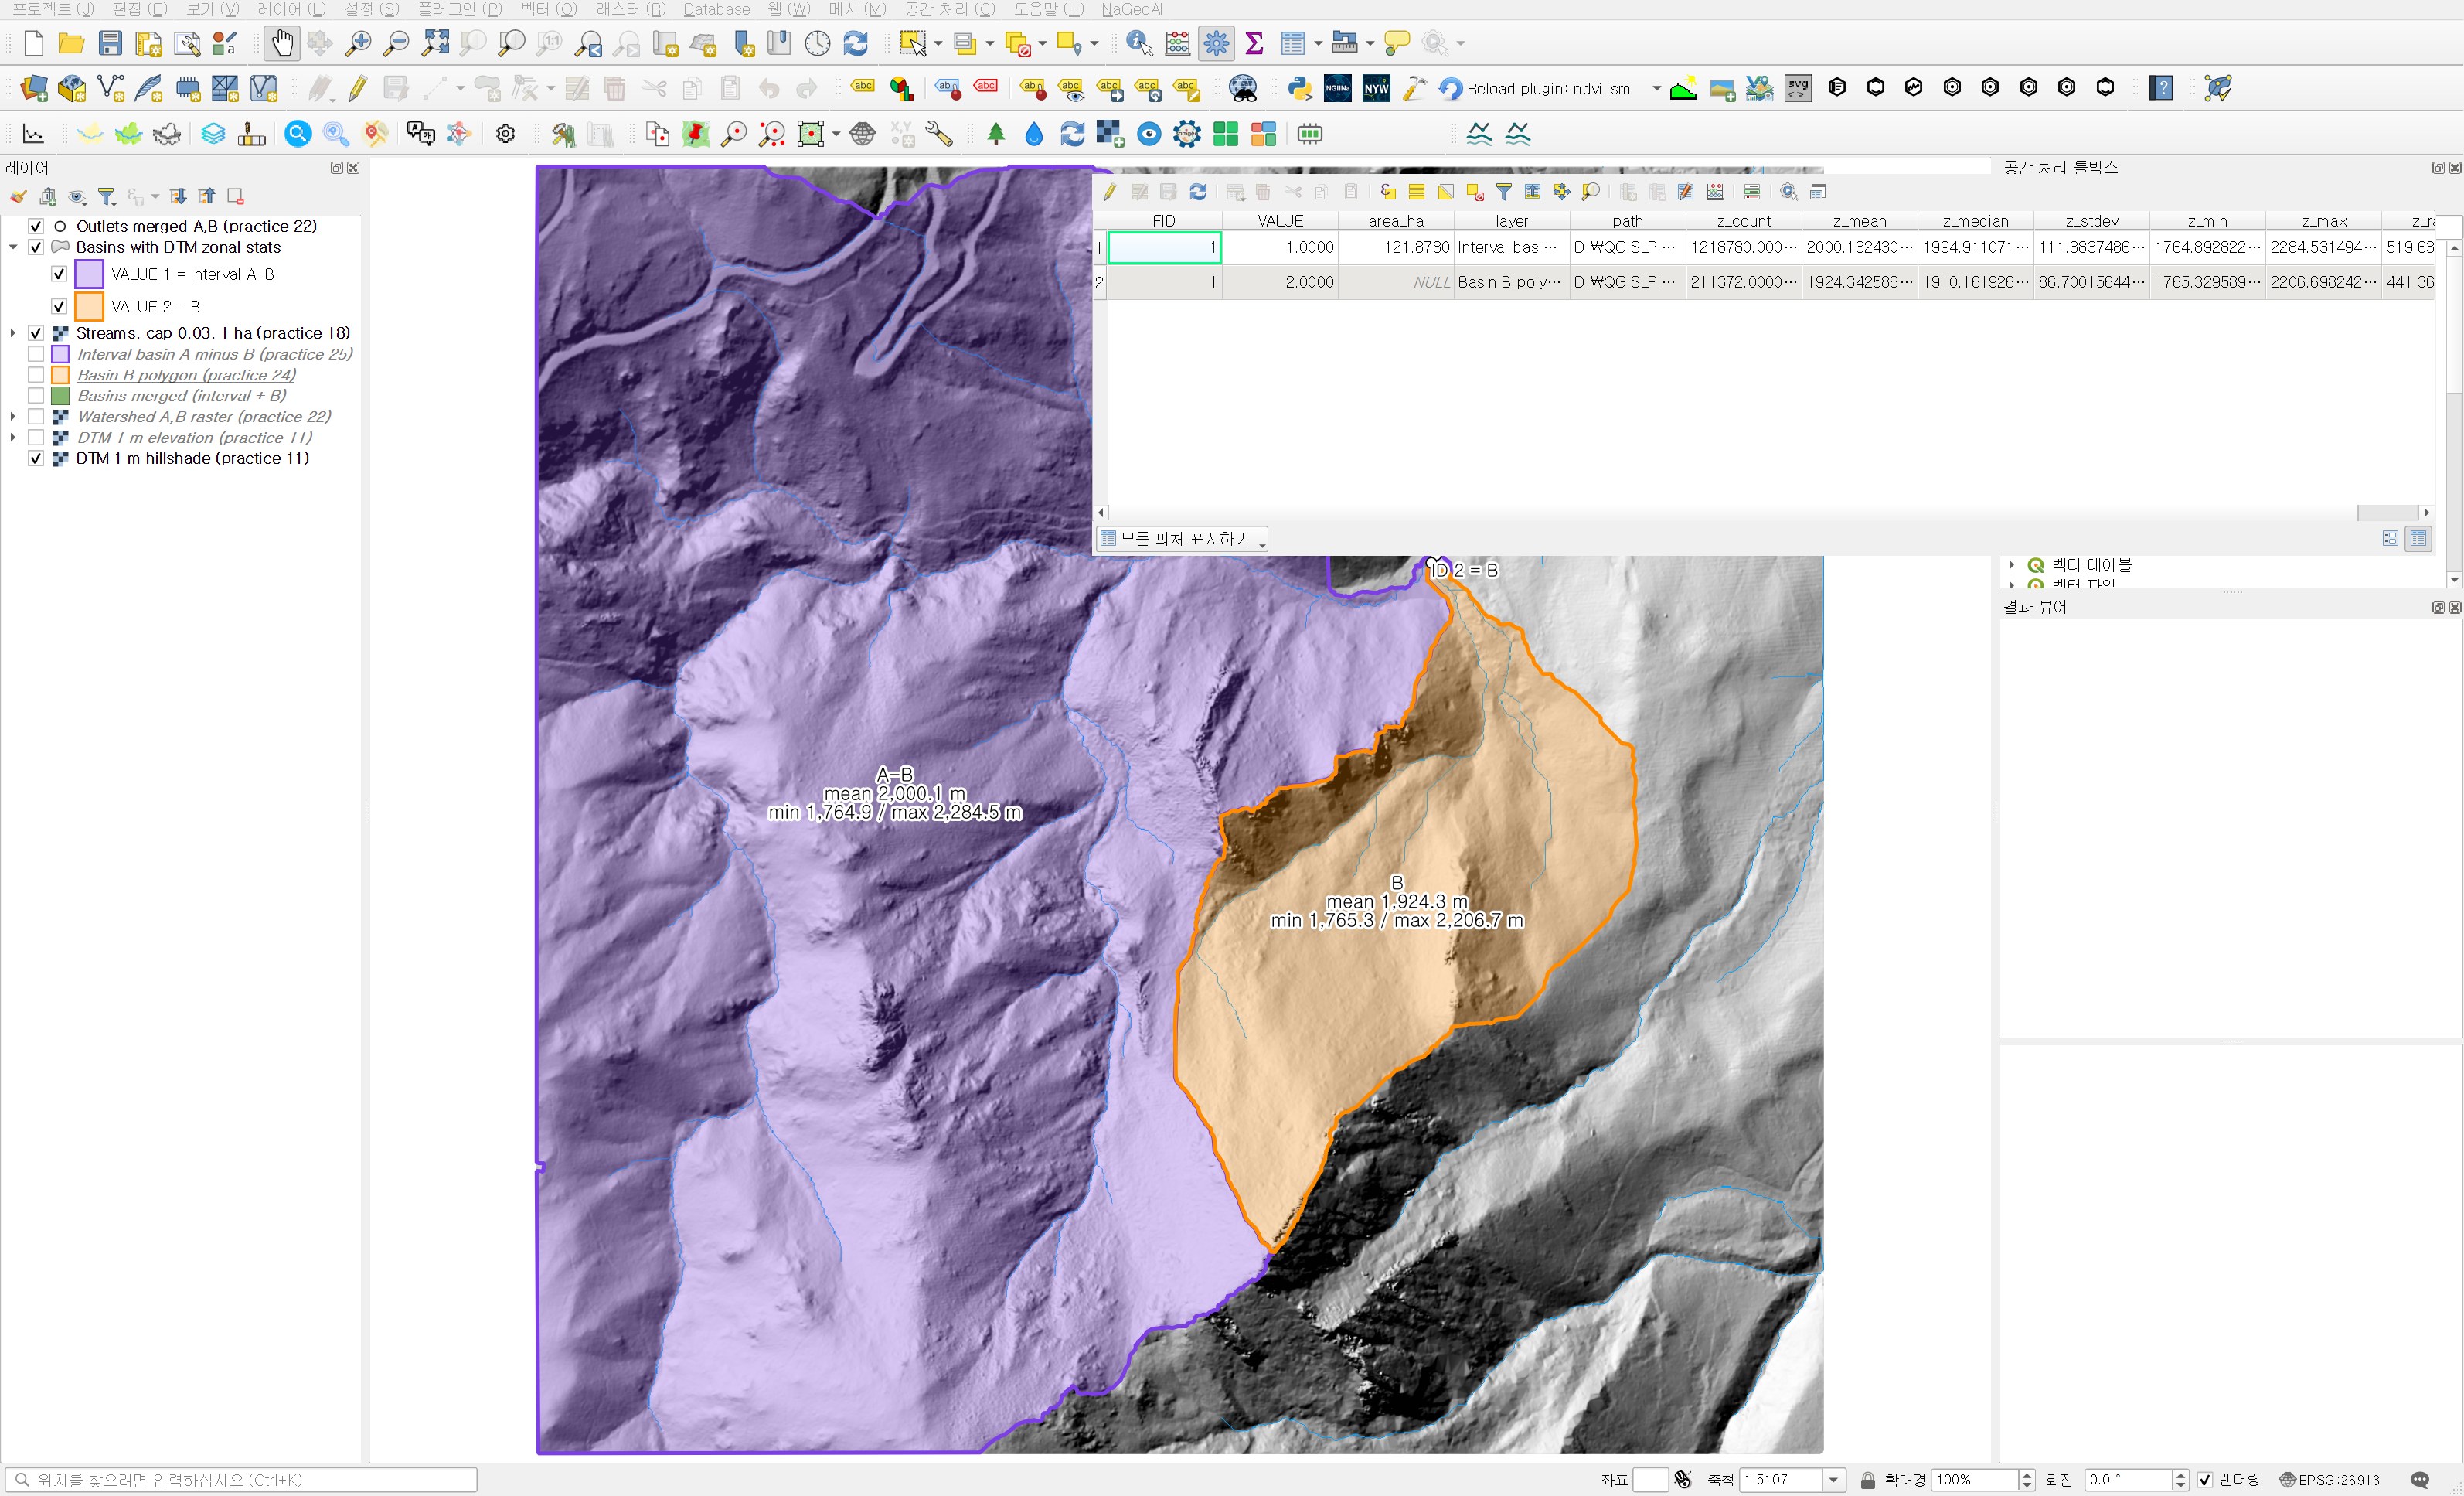
표로 읽은 두 유역
| 항목 | 중간유역 A−B (VALUE 1) | B 유역 (VALUE 2) | 차이(A−B − B) |
|---|---|---|---|
| 셀 수(= 면적 m²) | 1,218,780 | 211,372 | |
| 평균 표고 | 2,000.13 m | 1,924.34 m | +75.79 m |
| 중앙값 | 1,994.91 m | 1,910.16 m | +84.75 m |
| 최저 | 1,764.89 m | 1,765.33 m | −0.44 m |
| 최고 | 2,284.53 m | 2,206.70 m | +77.83 m |
| 범위 | 519.64 m | 441.37 m | +78.27 m |
| 표준편차 | 111.38 m | 86.70 m | +24.68 m |
최저 표고는 두 유역이 0.44 m밖에 차이 나지 않는다. 22편에서 유출구 A와 B를 같은 합류부 근처에 찍었으니 당연한 결과고, 오히려 이 숫자가 유출구 위치가 맞게 들어갔다는 확인이 된다. 차이는 위쪽에서 난다. 최고 표고가 78 m 가까이 높고, 평균과 중앙값도 76~85 m 높다. 중간유역이 더 높은 능선까지 물을 모은다는 인상이 숫자로 맞았다.
평균만 보면 놓치는 게 있어서 검증 스크립트에서 분포를 조금 더 봤다. 중간유역은 셀의 48.7%가 2,000 m 이상이고 1,850 m 미만은 8.4%다. B는 2,000 m 이상이 19.2%, 1,850 m 미만이 21.5%다. 사분위 범위도 중간유역이 1,910.80~2,087.21 m, B가 1,857.31~1,979.13 m로, B는 유출구 가까운 낮은 땅의 비중이 크다. B의 중앙값(1,910.16 m)이 평균(1,924.34 m)보다 14 m가량 낮은 것도 같은 이야기다. 높은 쪽으로 긴 꼬리가 있고, 몸통은 낮은 쪽에 몰려 있다.
표준편차는 중간유역이 더 크다. 면적이 다섯 배 넘게 넓고 표고 범위도 넓으니 자연스럽다. 다만 표준편차가 크다고 경사가 급하다는 뜻은 아니다. 넓은 유역은 완만해도 표고 폭이 커질 수 있으므로, 경사를 말하려면 경사 래스터로 따로 통계를 내야 한다.
래스터 구역으로 한 번 더
폴리곤 경로가 맞게 셌는지 보려고 공간 처리 툴박스 → 래스터 분석 → 래스터 레이어 구역통계(Raster layer zonal statistics)를 돌렸다. 이 도구는 구역을 폴리곤이 아니라 래스터 값으로 받는다. 22편 Watershed 래스터가 바로 그런 구역 래스터다.
| 입력란 | 값 | 이유 |
|---|---|---|
| 입력 레이어 | DTM 1 m elevation (practice 11) | 통계 대상 |
| 밴드 번호 | 1 | |
| 구역 레이어 | Watershed A,B raster (practice 22) | 값 1 = A 몫, 값 2 = B |
| 구역 밴드 번호 | 1 | |
| 참조 레이어 | 입력 레이어(기본값) | 두 래스터 격자가 같아서 어느 쪽을 써도 리샘플링이 일어나지 않는다 |
| 통계 | wb26_raster_zones_dtm.csv | 표 하나라 CSV로 받았다 |
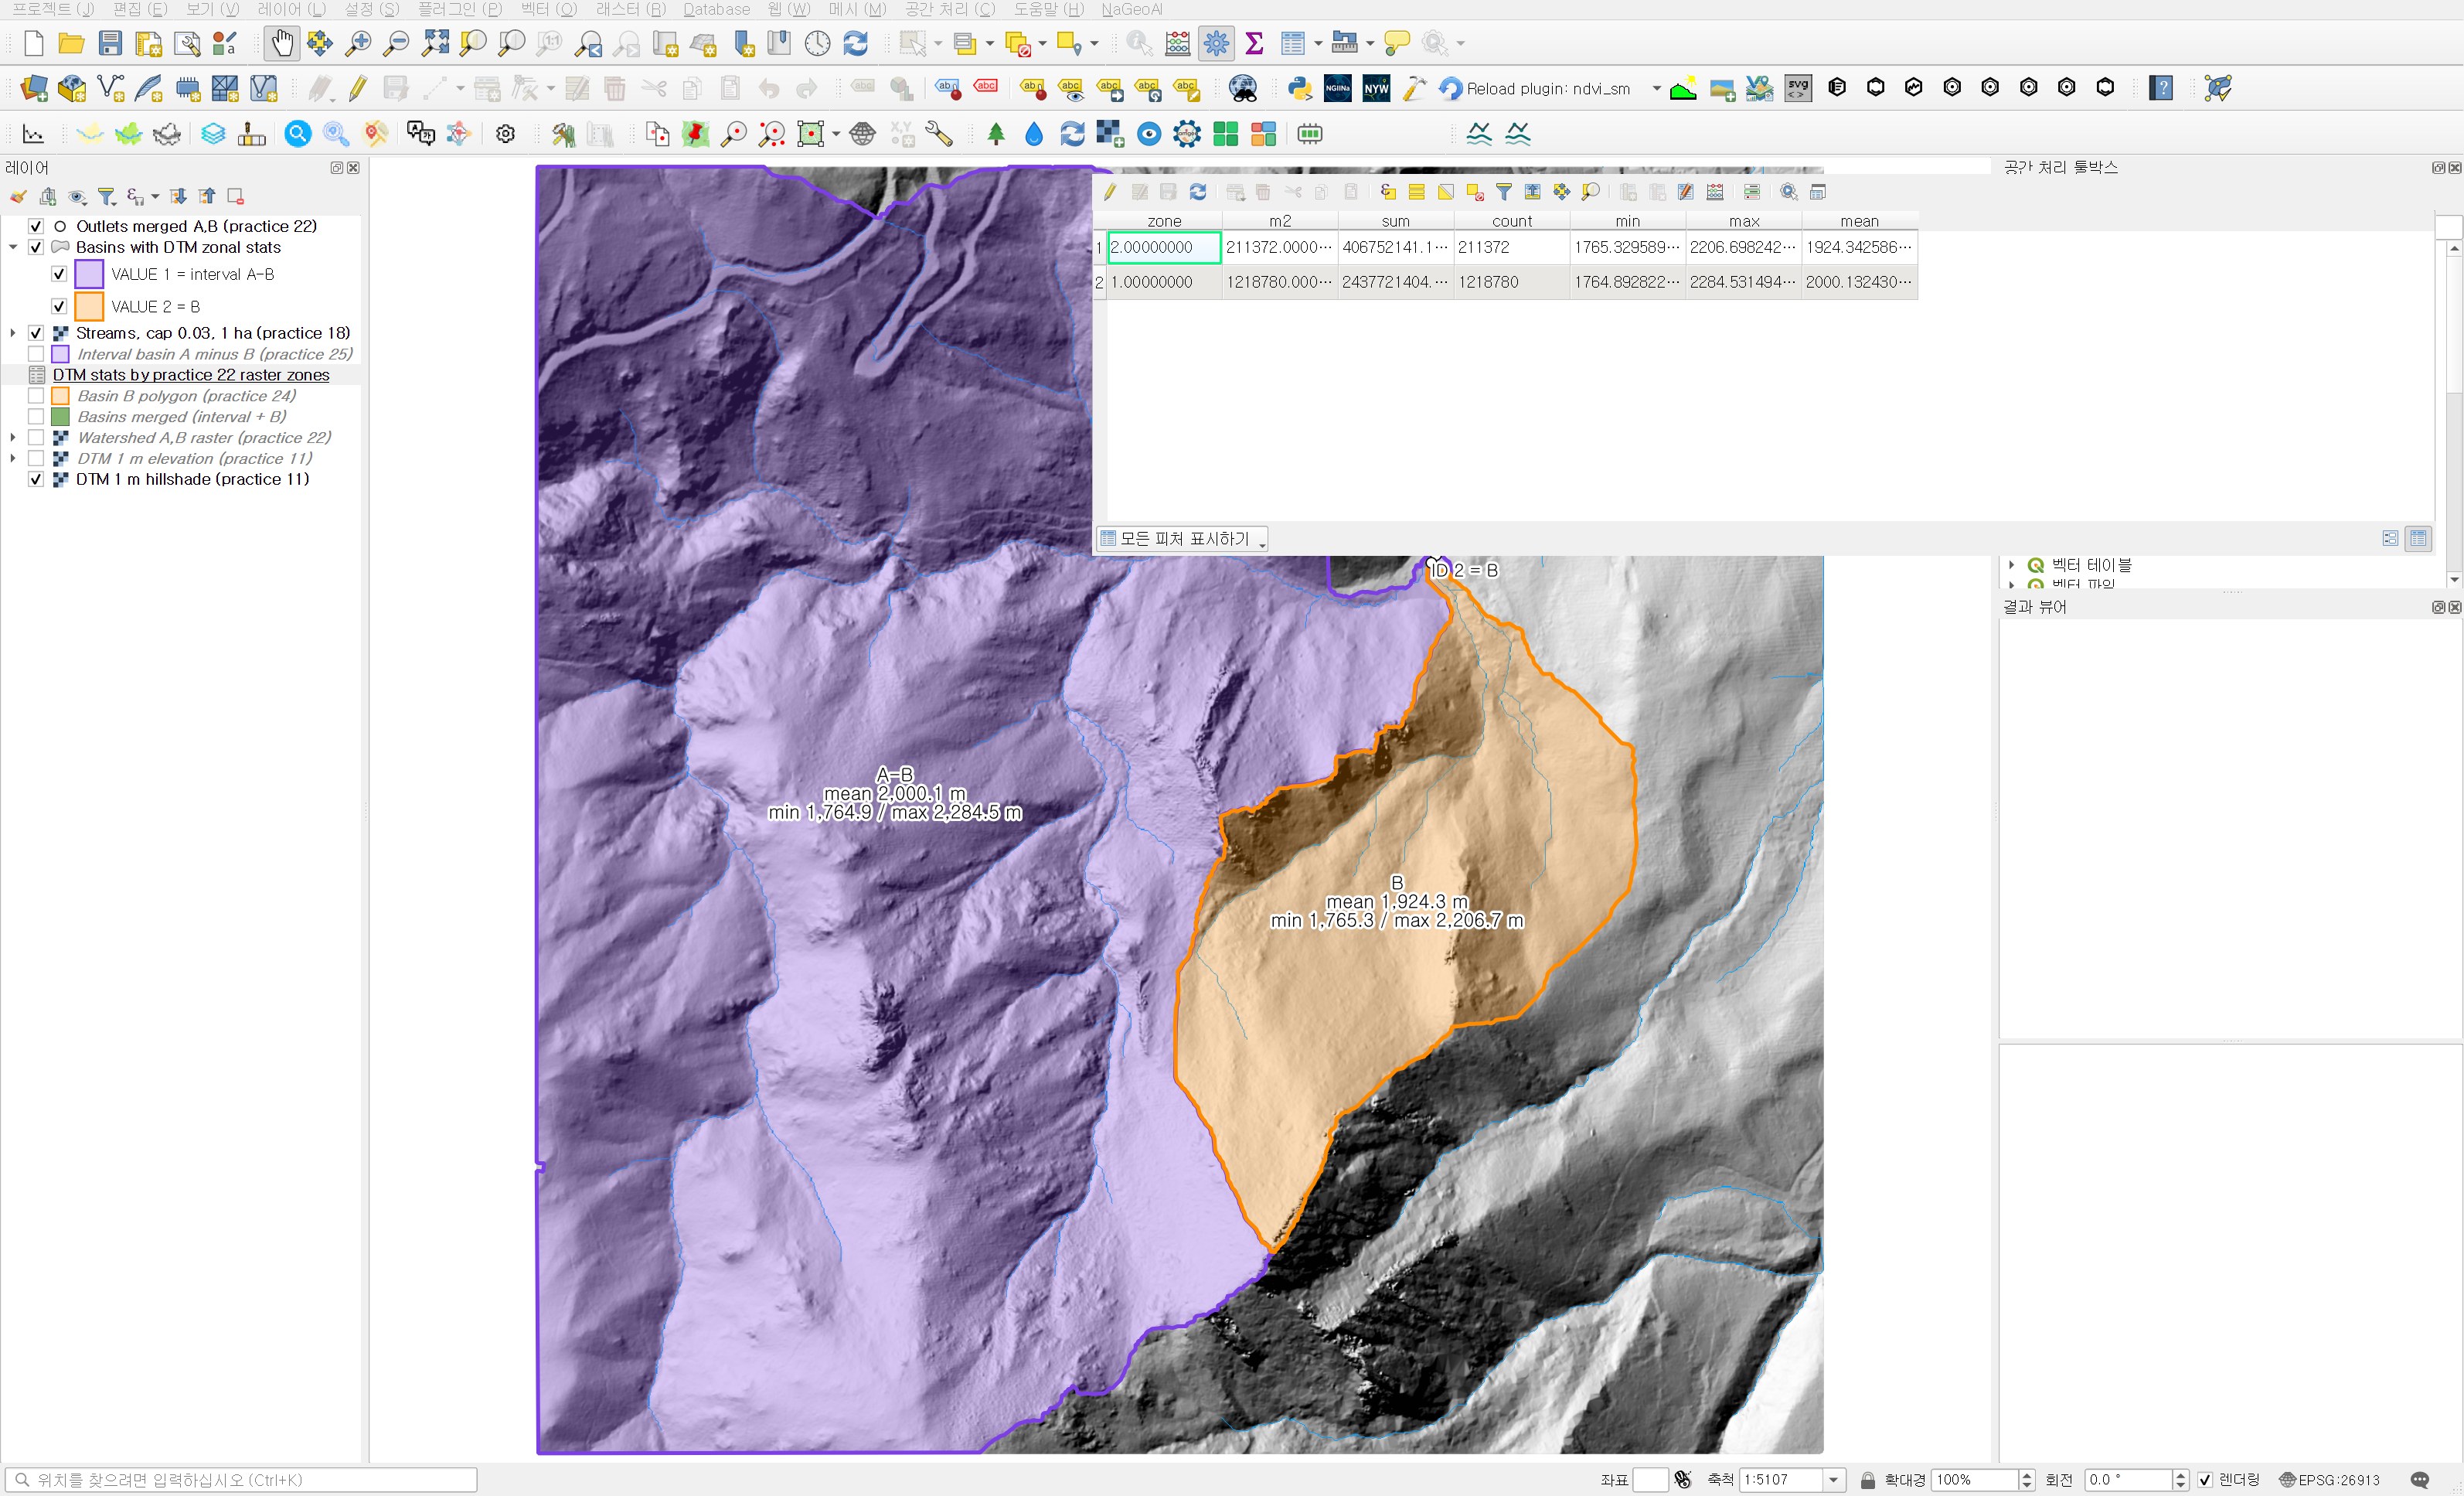
구역 1은 1,218,780개 셀, 구역 2는 211,372개 셀로 폴리곤 경로와 셀 수가 정확히 같다. 평균·최저·최고도 표시 자릿수까지 같다. 검증 스크립트에서 폴리곤을 같은 격자로 래스터화해 22편 구역과 셀별로 맞춰 보니 두 유역 모두 어긋난 셀이 0개였다. 25편에서 생긴 7 m² 구멍도 양쪽에서 똑같이 빠져 있다는 뜻이다. 폴리곤에서는 구멍이라 셀 중심이 안 들어가고, 래스터에서는 원래 NoData다.
이 도구는 중앙값과 표준편차를 주지 않는다. 대신 sum(합계)과 m2(면적) 열이 붙는다. 그래서 두 도구는 서로 대체하기보다 하나로 통계를 내고 다른 하나로 셀 수와 평균을 맞춰 보는 용도로 같이 쓰는 게 낫다고 본다.
실무에서 챙길 것
- 구역통계는 셀 중심이 폴리곤 안에 있는 셀만 센다. 이번처럼 폴리곤이 래스터에서 만들어져 셀 모서리를 따라가면 개수와 면적이 딱 맞지만, 다른 출처의 경계나 더 거친 래스터라면 경계 셀 처리 때문에 개수 × 셀 넓이가 폴리곤 면적과 달라진다. 개수를 함께 뽑아 면적과 비교해 두면 이런 차이가 바로 보인다.
- 병합하면 원본 FID가 겹칠 수 있다. 구분용 필드(이번에는 VALUE)를 미리 확인하고, 없으면 병합 전에 하나 만들어 둔다.
- shp로 저장할 때는 통계 필드 이름이 10자로 잘린다. 접두어를 짧게 하거나 GeoPackage로 저장한다.
- DSM으로 같은 통계를 내면 건물과 수관 높이가 섞인다. 유역 지형을 비교할 때는 지면 DTM을 쓴다. 이번 자료는 지면점으로 만든 DTM이다.
- 평균 차이만 보고하지 말고 중앙값이나 사분위를 같이 본다. B처럼 낮은 땅에 몸통이 몰린 유역은 평균이 실제 대표 표고보다 위로 끌려 올라간다.
다음 회차
평균과 사분위로 보니 두 유역은 표고 분포의 모양이 달랐다. 다음에는 DTM을 표고 구간(예: 50 m 간격)으로 나눠 유역별로 구간마다 면적이 얼마인지 세어, 두 유역의 표고-면적 분포를 나란히 비교해 보려고 한다.
작업 메모
이번 회차는 QGIS 시작 스크립트로 같은 대화상자에 값을 넣어 실행했고, 화면은 그때 캡처한 것이다. 원본 프로젝트는 그대로 두고 복사본(QGIS_Play_NaGeoAI_20261114_26_zonal.qgz)에서 작업했다. 자료 출처는 USGS 3DEP(The National Map) 타일 13SDE474426이고, 원본 DTM은 재배포하지 않는다. 결과는 별도 스크립트로 다시 읽어 numpy로 같은 통계를 독립 계산했고(최대 차이 1×10⁻¹² m 미만), 폴리곤과 22편 구역 래스터의 셀별 일치(불일치 0개 셀)를 확인했다. 사분위와 표고 구간 비율은 그 스크립트에서 계산한 값이다. QGIS 3.44.15, GDAL 3.13.3. SHA-256 앞 12자리:
- 입력 DTM 069a9c249240
- 입력 중간유역 / B 폴리곤 .shp d891fa55042f / 0796f835c715
- 입력 Watershed(22편) 12c9fc71b969
- 병합 결과 .shp / .dbf 235891ed214a / 67d3965a6d72
- 구역통계 .shp / .dbf 235891ed214a / e8e1b17ea680
- 래스터 구역통계 .csv 0f55aa98e87c


댓글 없음:
댓글 쓰기