
22편에서 유출구 A와 B를 한 점 파일로 묶어 Watershed에 넣었더니 A가 143 ha가 아니라 122 ha로 나왔다. B가 자기 몫 21 ha를 먼저 가져가기 때문이다. 구간별 면적이 필요할 때는 그게 맞지만, 하류 관측소의 전체 집수 면적이 필요할 때는 유출구마다 따로 돌려야 했다. Whitebox에는 이 경우를 위한 도구가 따로 있다. UnnestBasins다. 같은 점 파일을 넣어 보니 A 143 ha와 B 21 ha가 21편에서 하나씩 따로 돌린 결과와 셀 하나 다르지 않게 나왔다. 대신 결과가 파일 두 개로 갈라져 나오고, QGIS는 그걸 실패처럼 표시한다.
자료
입력은 22편과 같다. 11편 1 m DTM(USGS 3DEP 타일 13SDE474426, NAD83 UTM 13N EPSG:26913, 1,500×1,500 셀), 19편의 절개 상한 0.03 D8 포인터, 18편의 하천(1 ha), 그리고 22편에서 병합한 점 파일 두 개(A, B 순서 / B, A 순서)를 새 입력 폴더로 복사했다. 비교용으로 21편에서 A, B를 따로 돌린 유역과 22편 Watershed 결과도 같이 복사했다. 복사본 해시는 원본과 같다.
| 점 | 위치 | 21편에서 따로 돌린 유역 |
|---|---|---|
| A | 합류점 아래 본류 | 1,430,152 m²(약 143.0 ha) |
| B | 합류 직전 지류 마지막 셀 | 211,372 m²(약 21.1 ha) |
UnnestBasins 실행
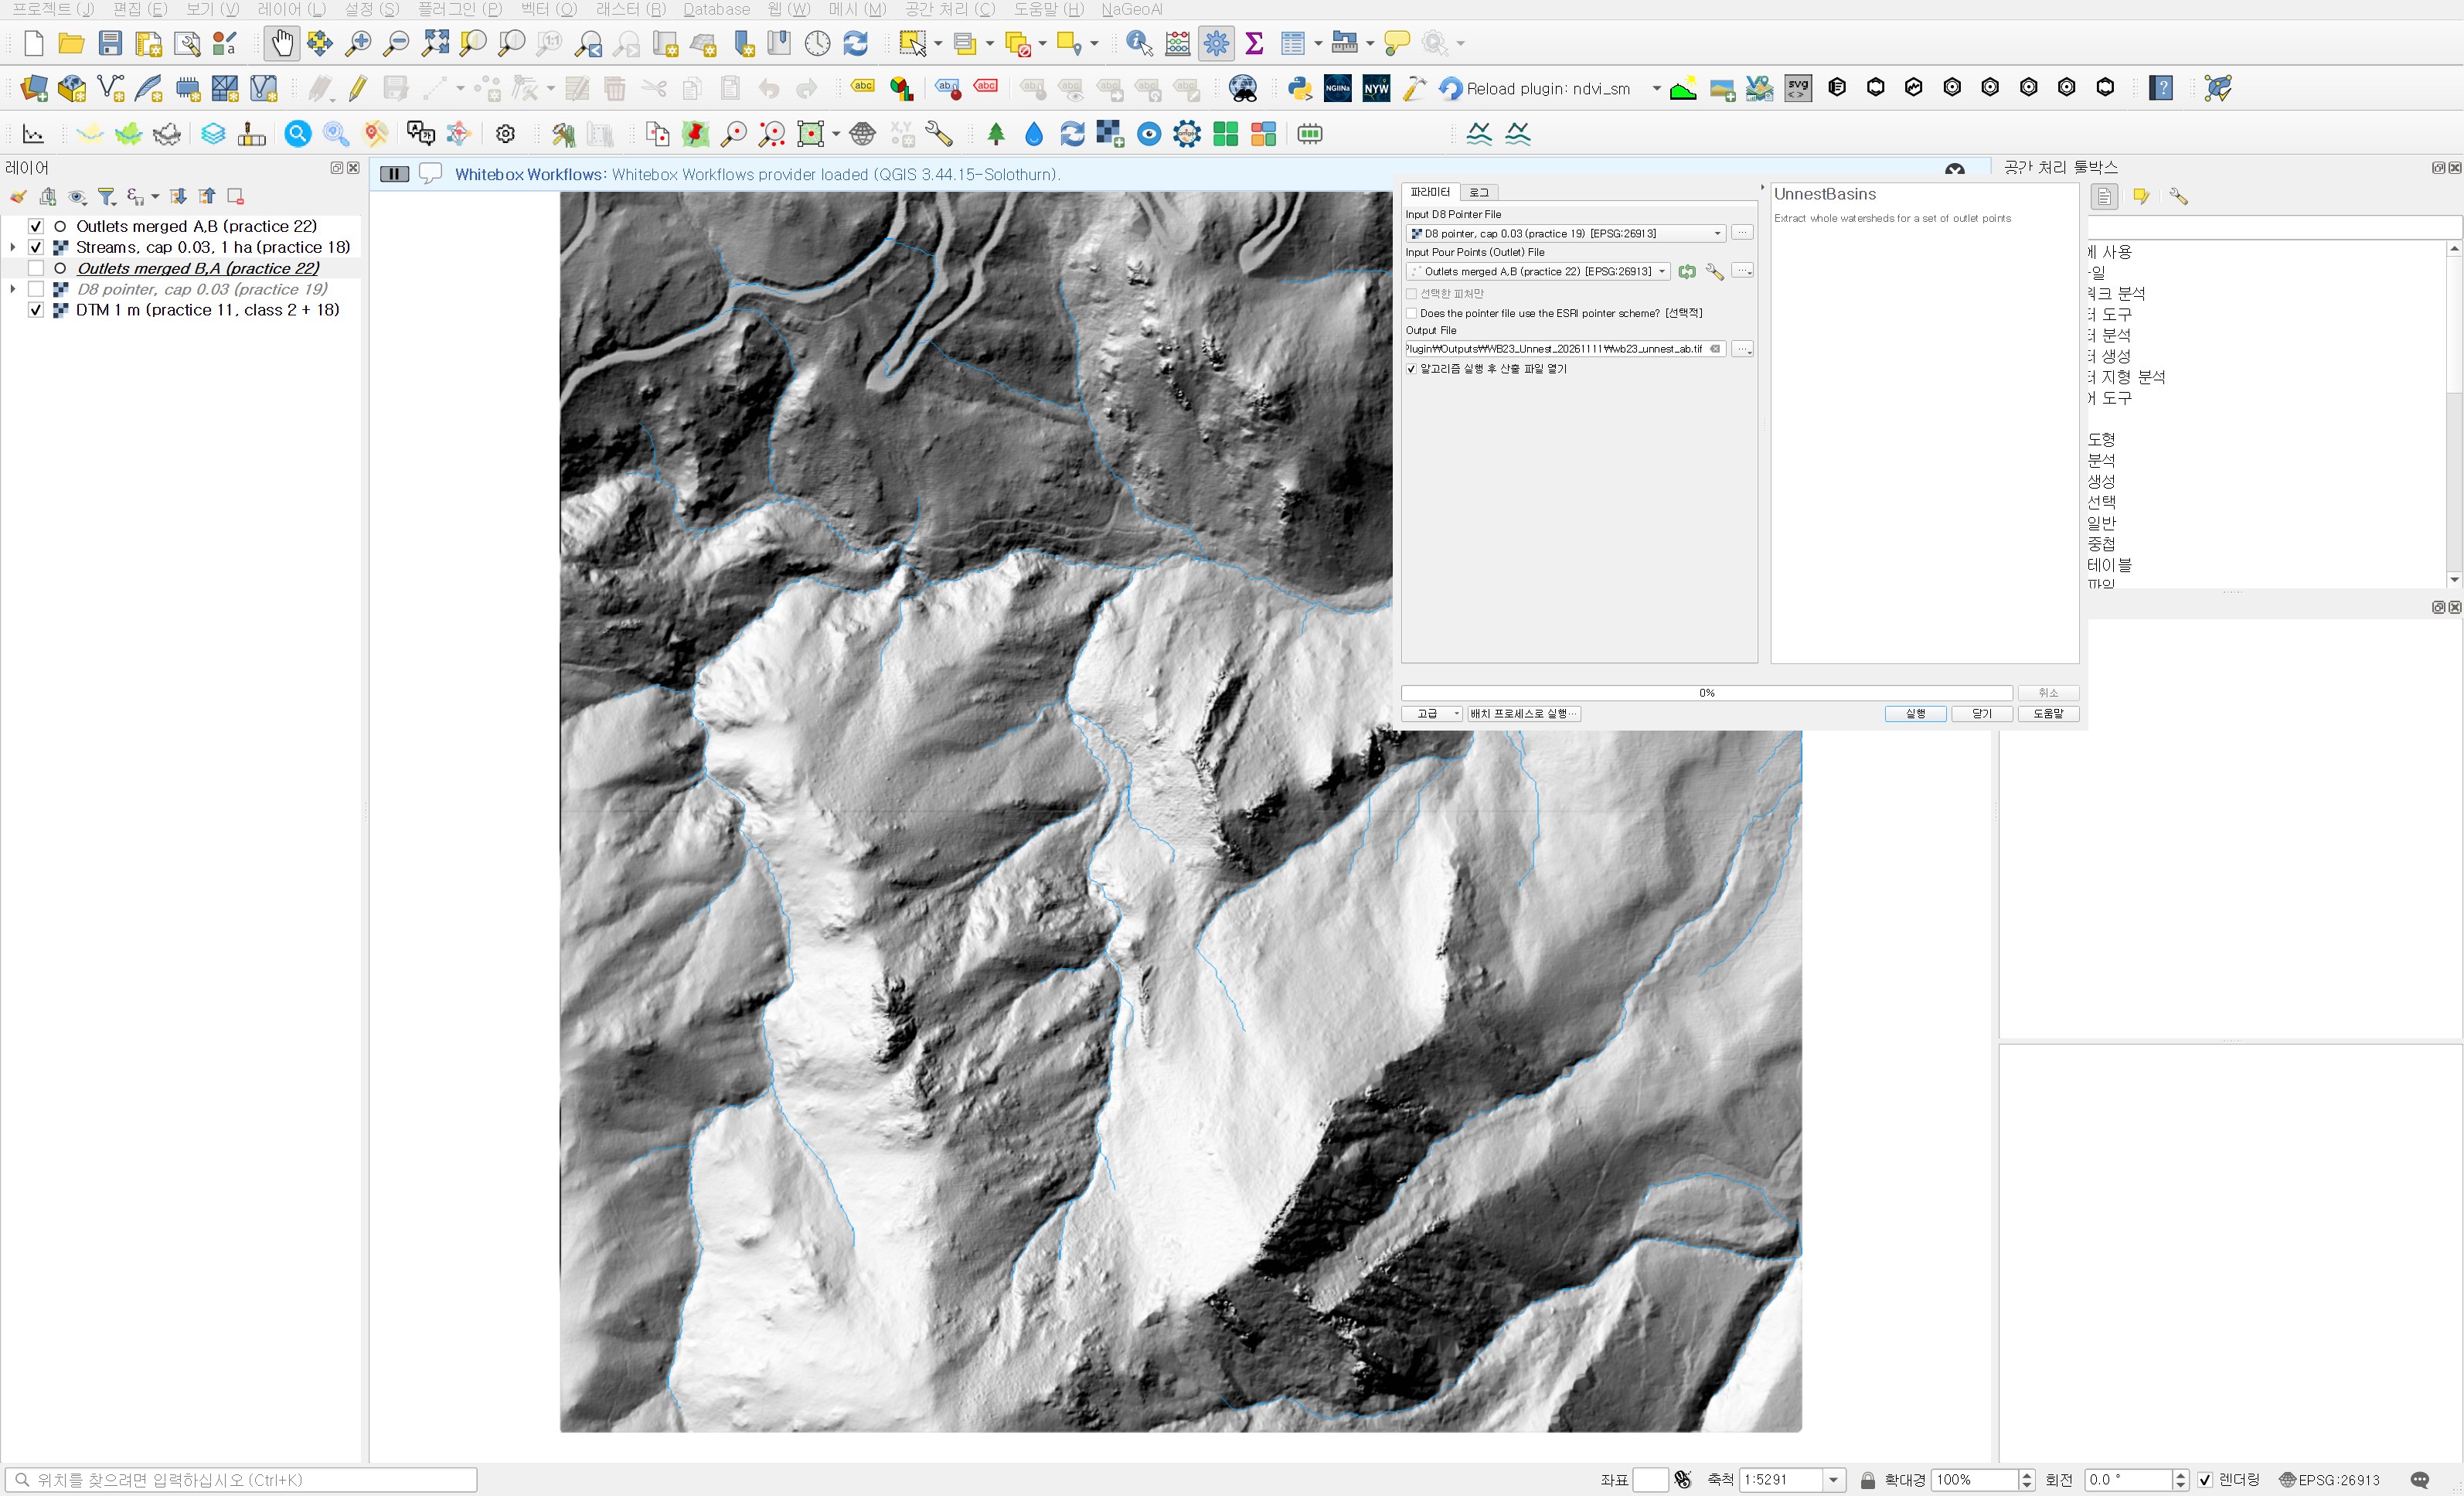
공간 처리 툴박스 → WhiteboxTools → Hydrological Analysis → UnnestBasins를 열었다. 입력란은 Watershed와 똑같이 네 개뿐이다.
| 입력란 | 값 | 이유 |
|---|---|---|
| Input D8 Pointer File | D8 pointer, cap 0.03 (practice 19) | 20~22편과 같은 포인터라야 비교가 된다 |
| Input Pour Points (Outlet) File | Outlets merged A,B (practice 22) | 22편과 같은 파일. 두 번째 실행은 B,A 파일 |
| Does the pointer file use the ESRI pointer scheme? | 체크 안 함 | 포인터를 Whitebox 방식으로 만들었다 |
| Output File | wb23_unnest_ab.tif | 이 이름 그대로는 만들어지지 않는다(아래 참조) |
"제대로 생성되지 않았습니다"
실행은 0.34초 만에 끝났고 Whitebox 쪽 로그는 "Output file written"을 두 번 찍은 뒤 성공으로 끝났다. 그런데 바로 아래에 빨간 글씨로 wb23_unnest_ab.tif가 제대로 생성되지 않았다는 메시지가 붙었다. 폴더를 열어 보면 이유가 보인다. 그 이름의 파일은 없고, wb23_unnest_ab_1.tif와 wb23_unnest_ab_2.tif가 있다. UnnestBasins는 겹친 정도(nesting order)마다 파일을 하나씩 만들고 입력한 이름 뒤에 번호를 붙인다. QGIS는 대화상자에 적힌 이름만 찾다가 못 찾은 것이다.
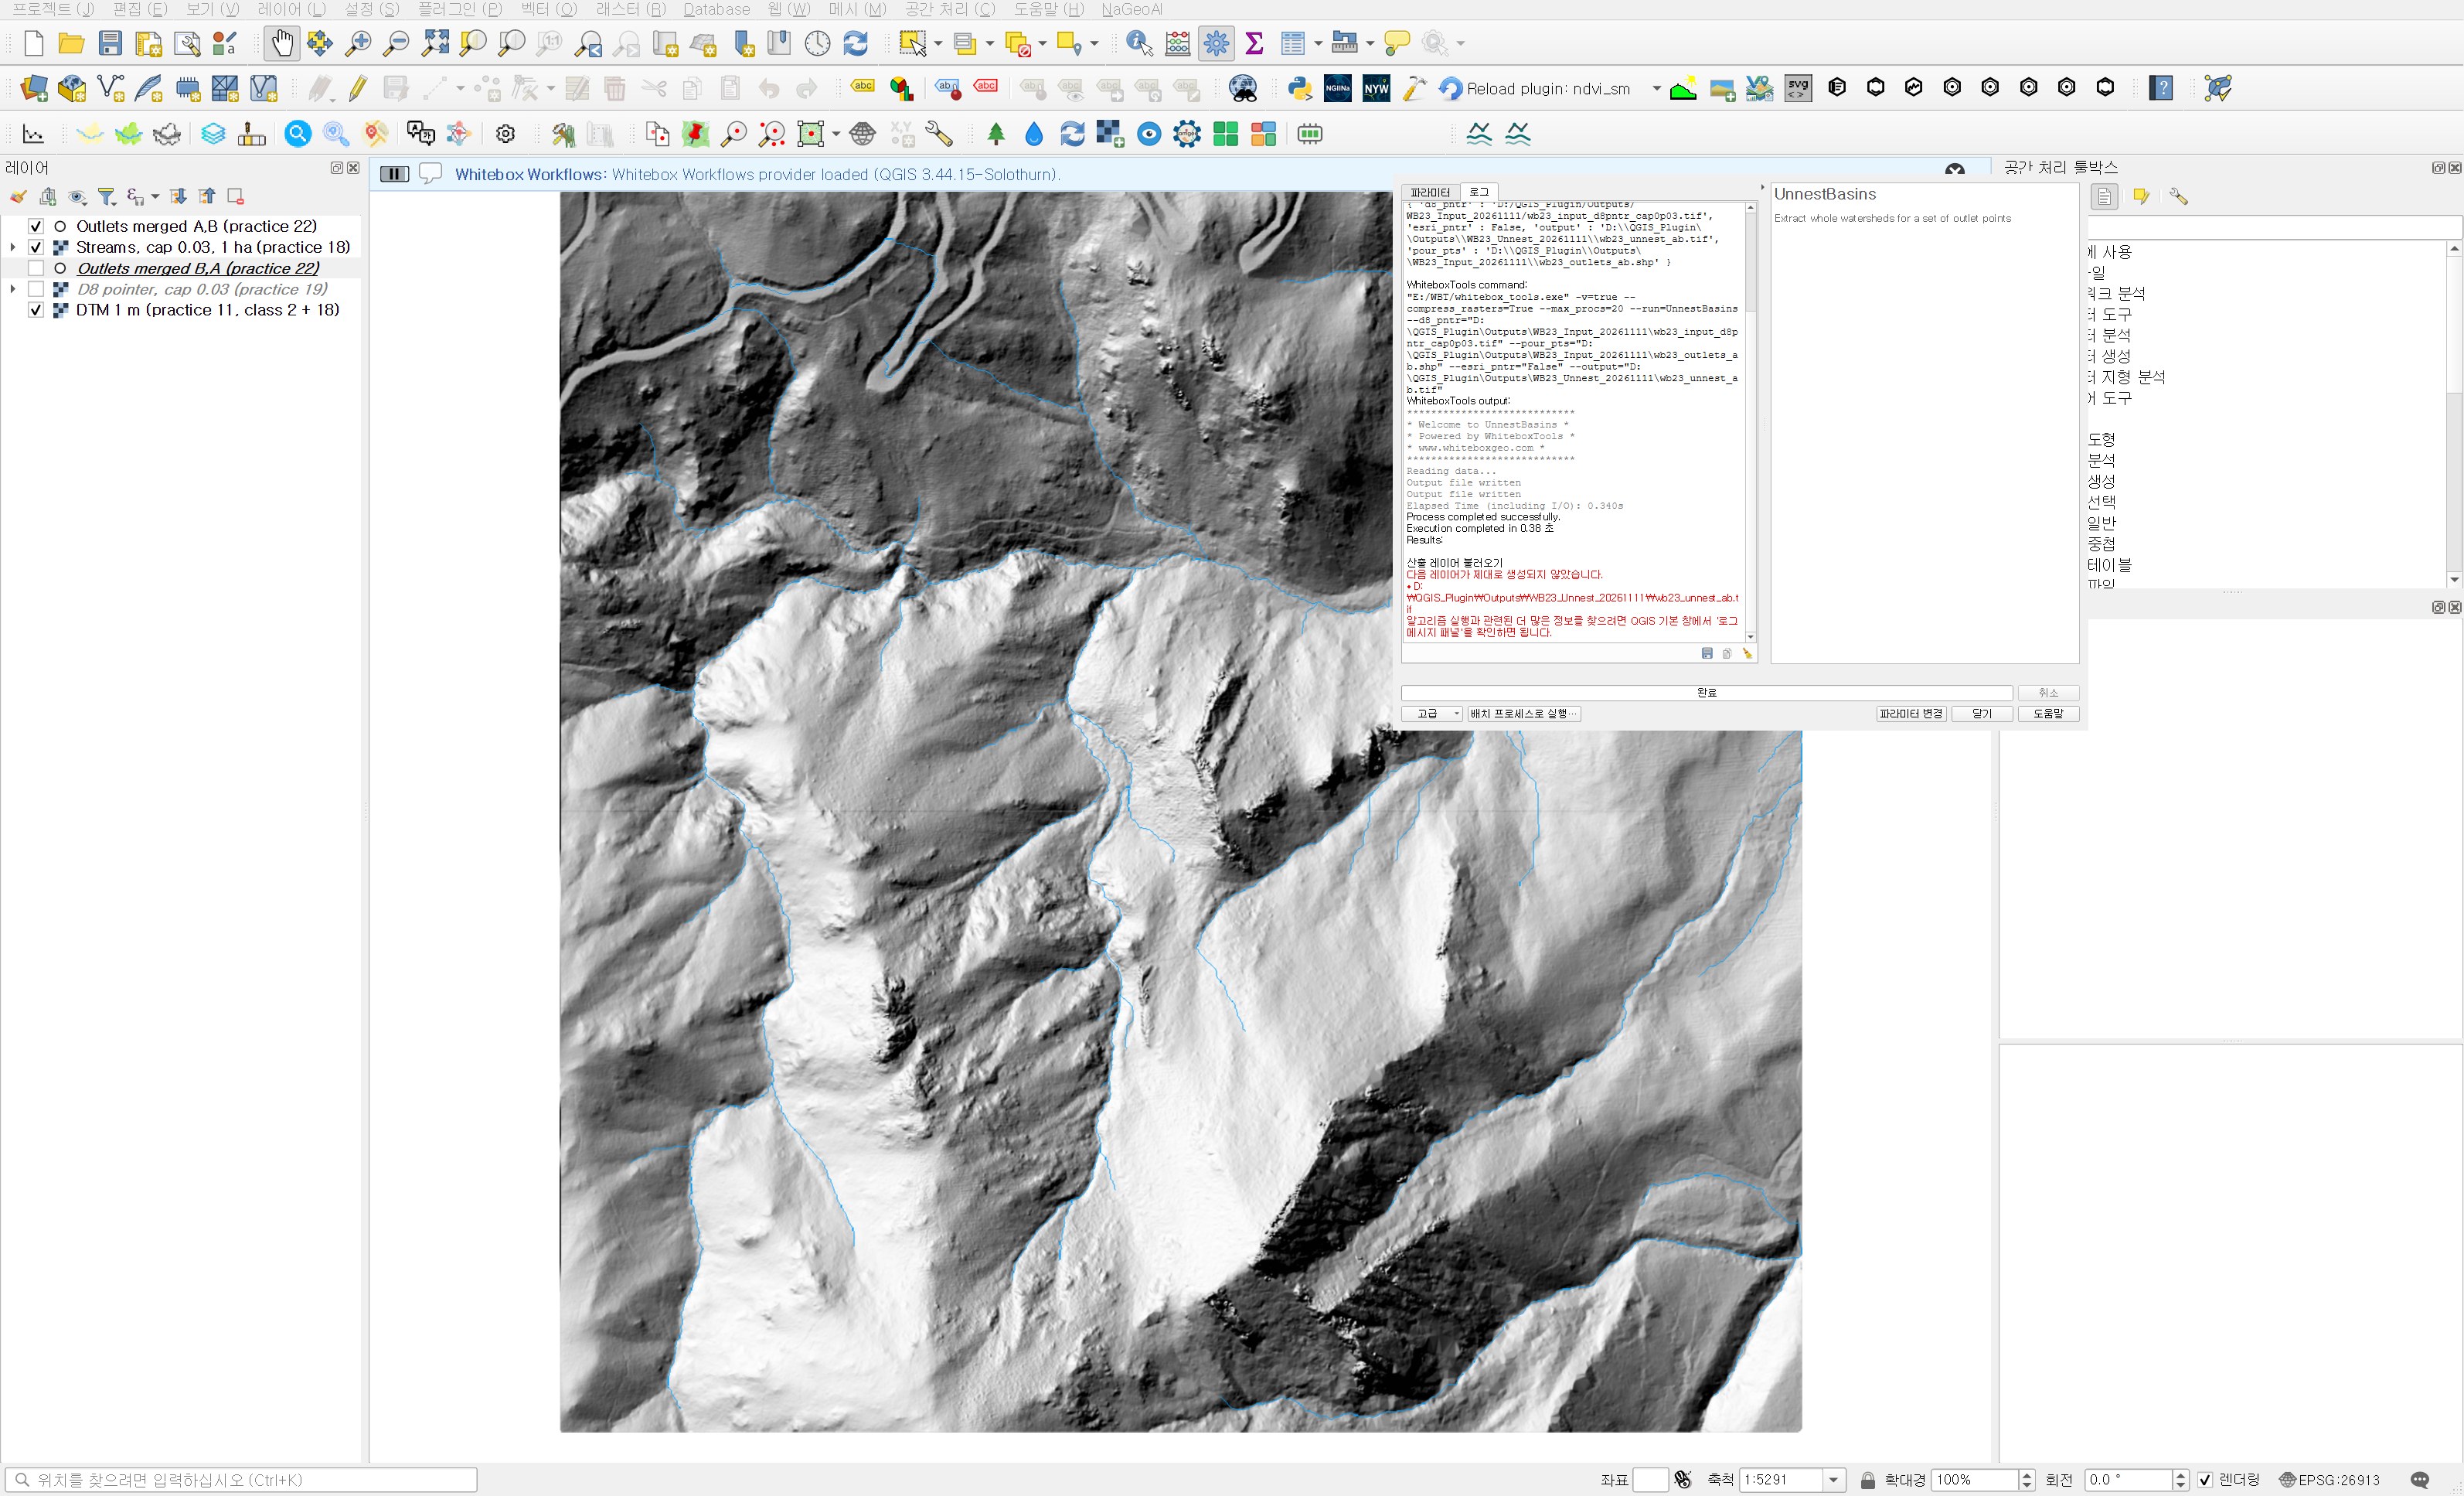
그래서 이 도구는 결과가 지도에 자동으로 올라오지 않는다. 산출 폴더에서 _1, _2 파일을 직접 불러와야 한다. 처음 쓰는 사람은 실패한 줄 알고 다시 돌리기 쉬운데, 그러면 같은 이름 뒤에 번호가 붙은 이전 결과를 덮어쓸 수 있다.
두 파일에 무엇이 들었나
| 파일 | 들어 있는 유출구 | 값(A,B 파일 / B,A 파일) | 셀 수(= m²) | 21편 따로 돌린 결과와 차이 |
|---|---|---|---|---|
| _1 (nesting order 1) | B | 2 / 1 | 211,372(약 21.1 ha) | 0개 셀 |
| _2 (nesting order 2) | A | 1 / 2 | 1,430,152(약 143.0 ha) | 0개 셀 |
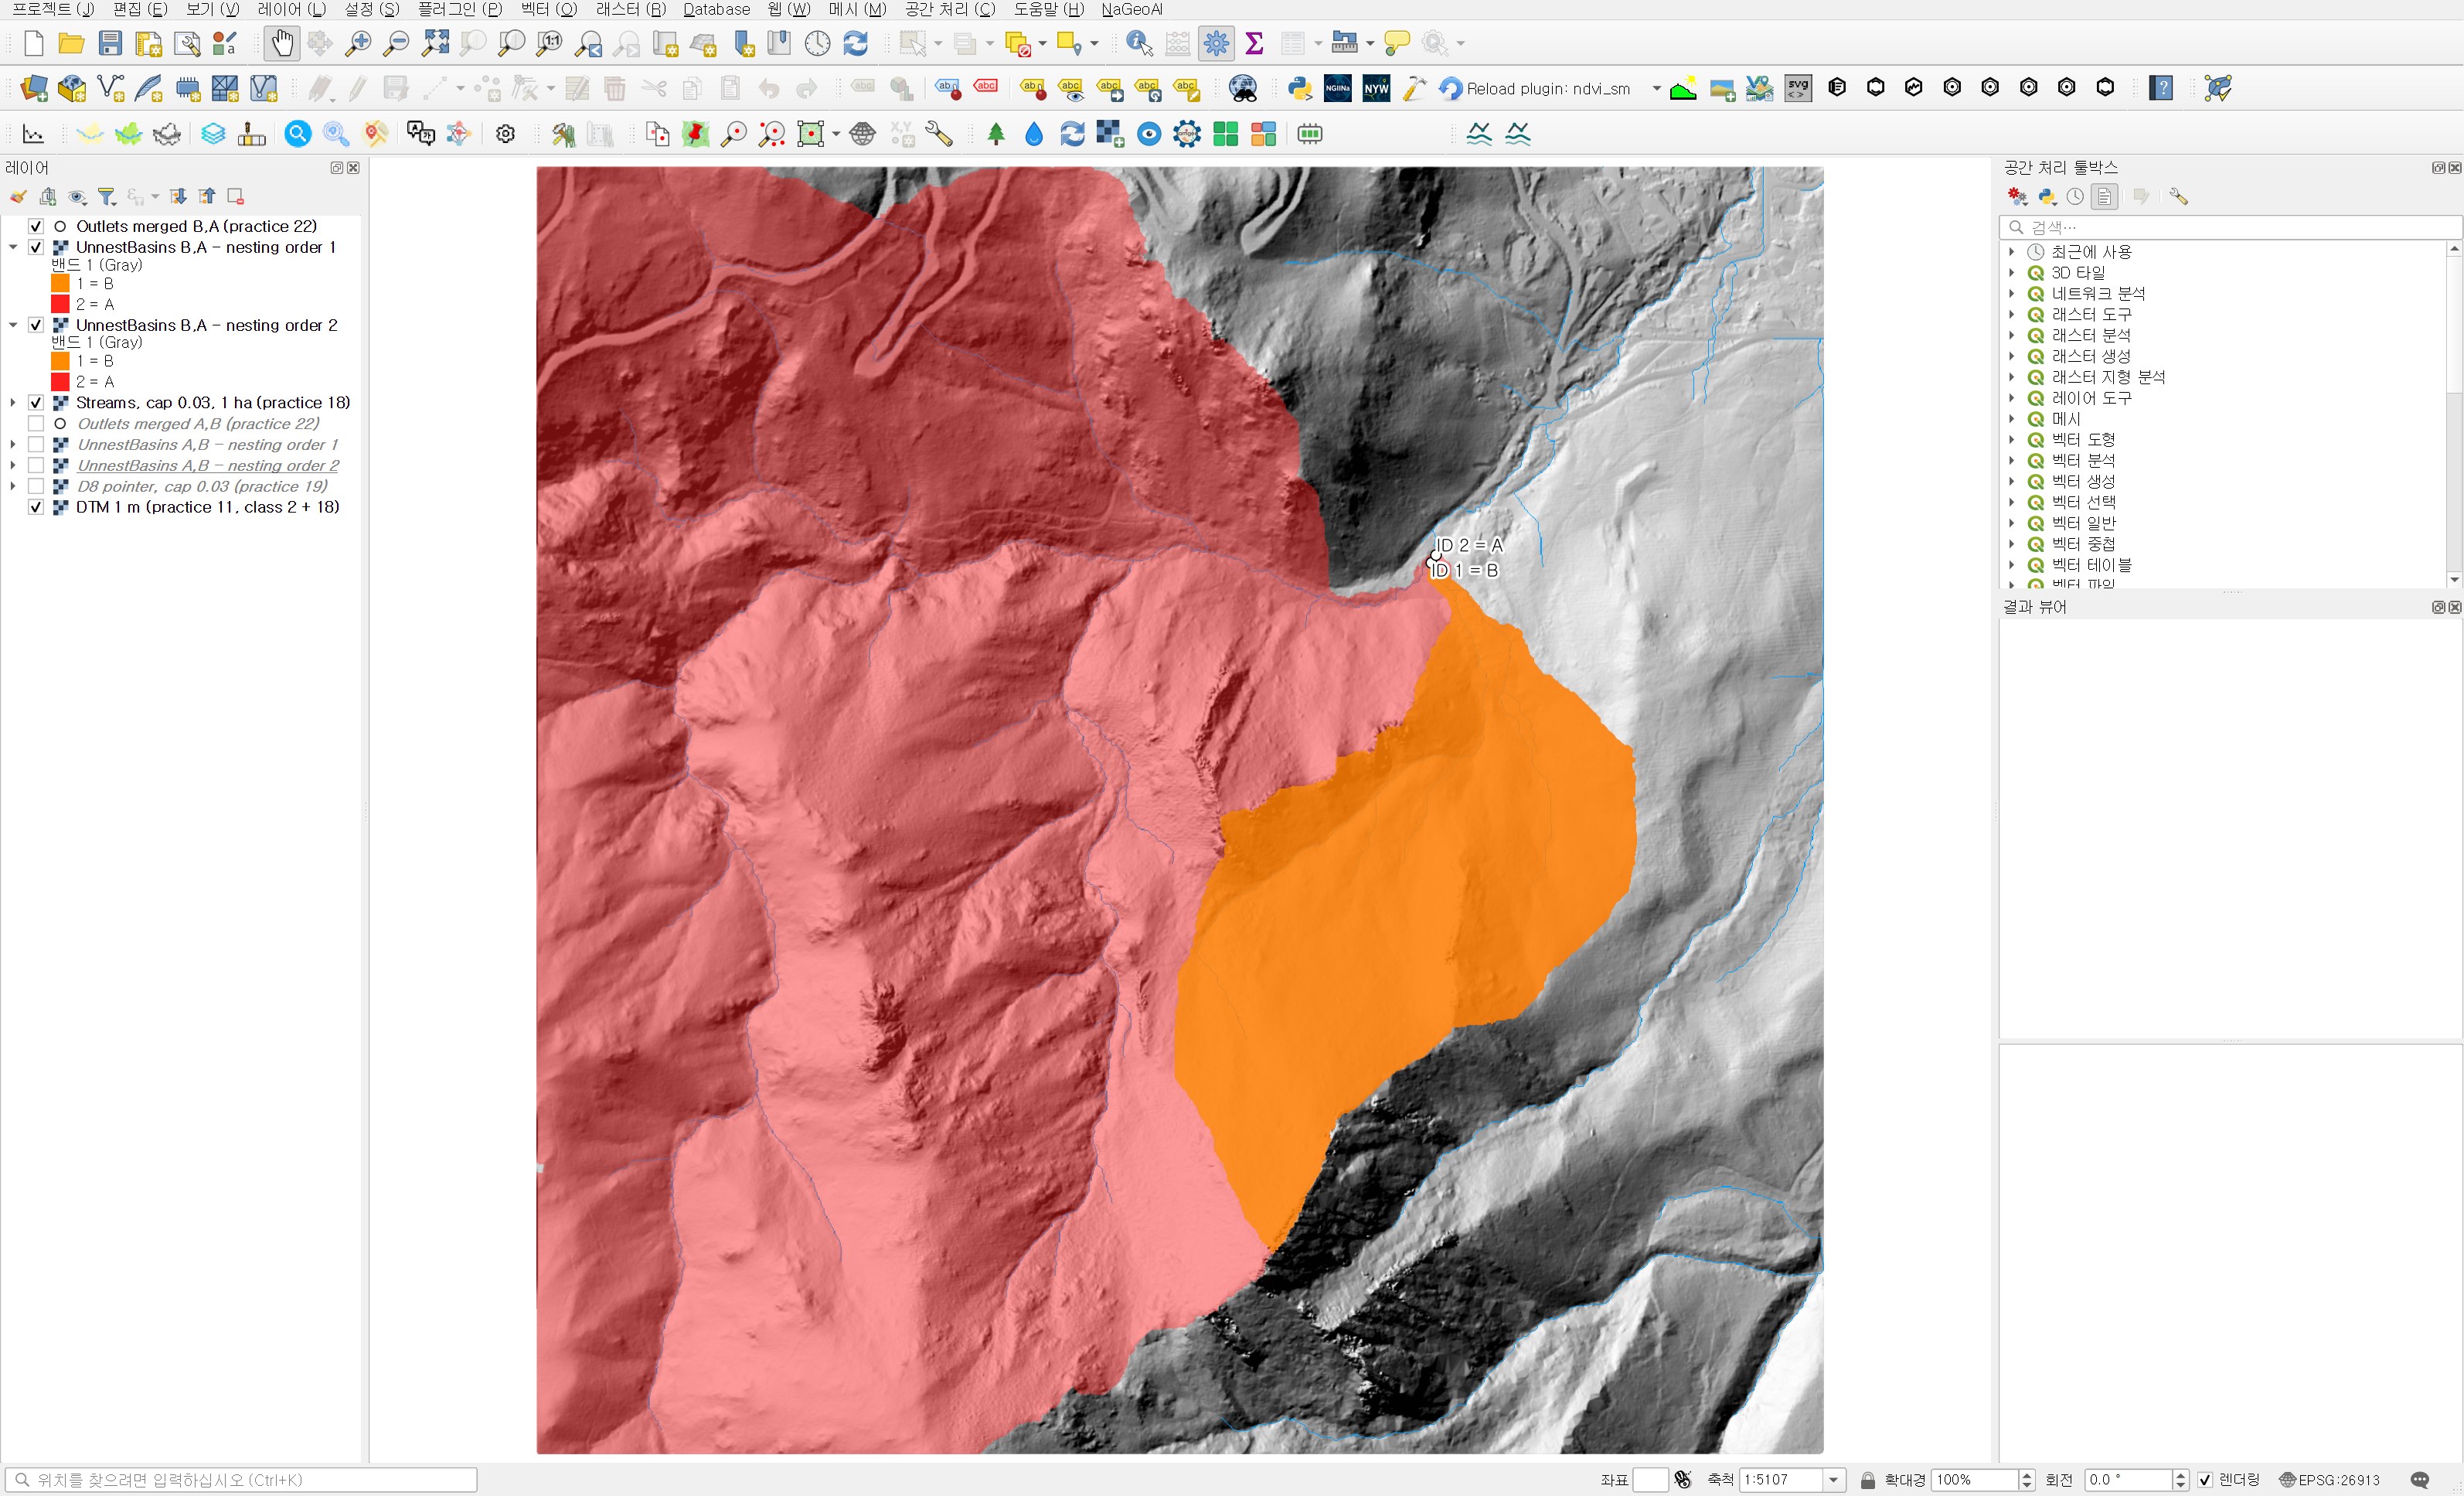
_1에는 안에 다른 유출구가 없는 B 유역만, _2에는 B를 품은 A 유역만 들어 있다. 22편과 달리 A는 B 몫을 빼지 않은 전체 집수 면적이다. 두 파일을 겹쳐 보면 B 211,372개 셀이 양쪽에 다 들어 있다. 21편에서 하나씩 따로 돌린 유역과 셀 단위로 비교한 차이는 둘 다 0이었다. 포인터를 따라 내려가 각 유출구를 지나는 셀을 numpy로 따로 모은 결과와도 같았다.
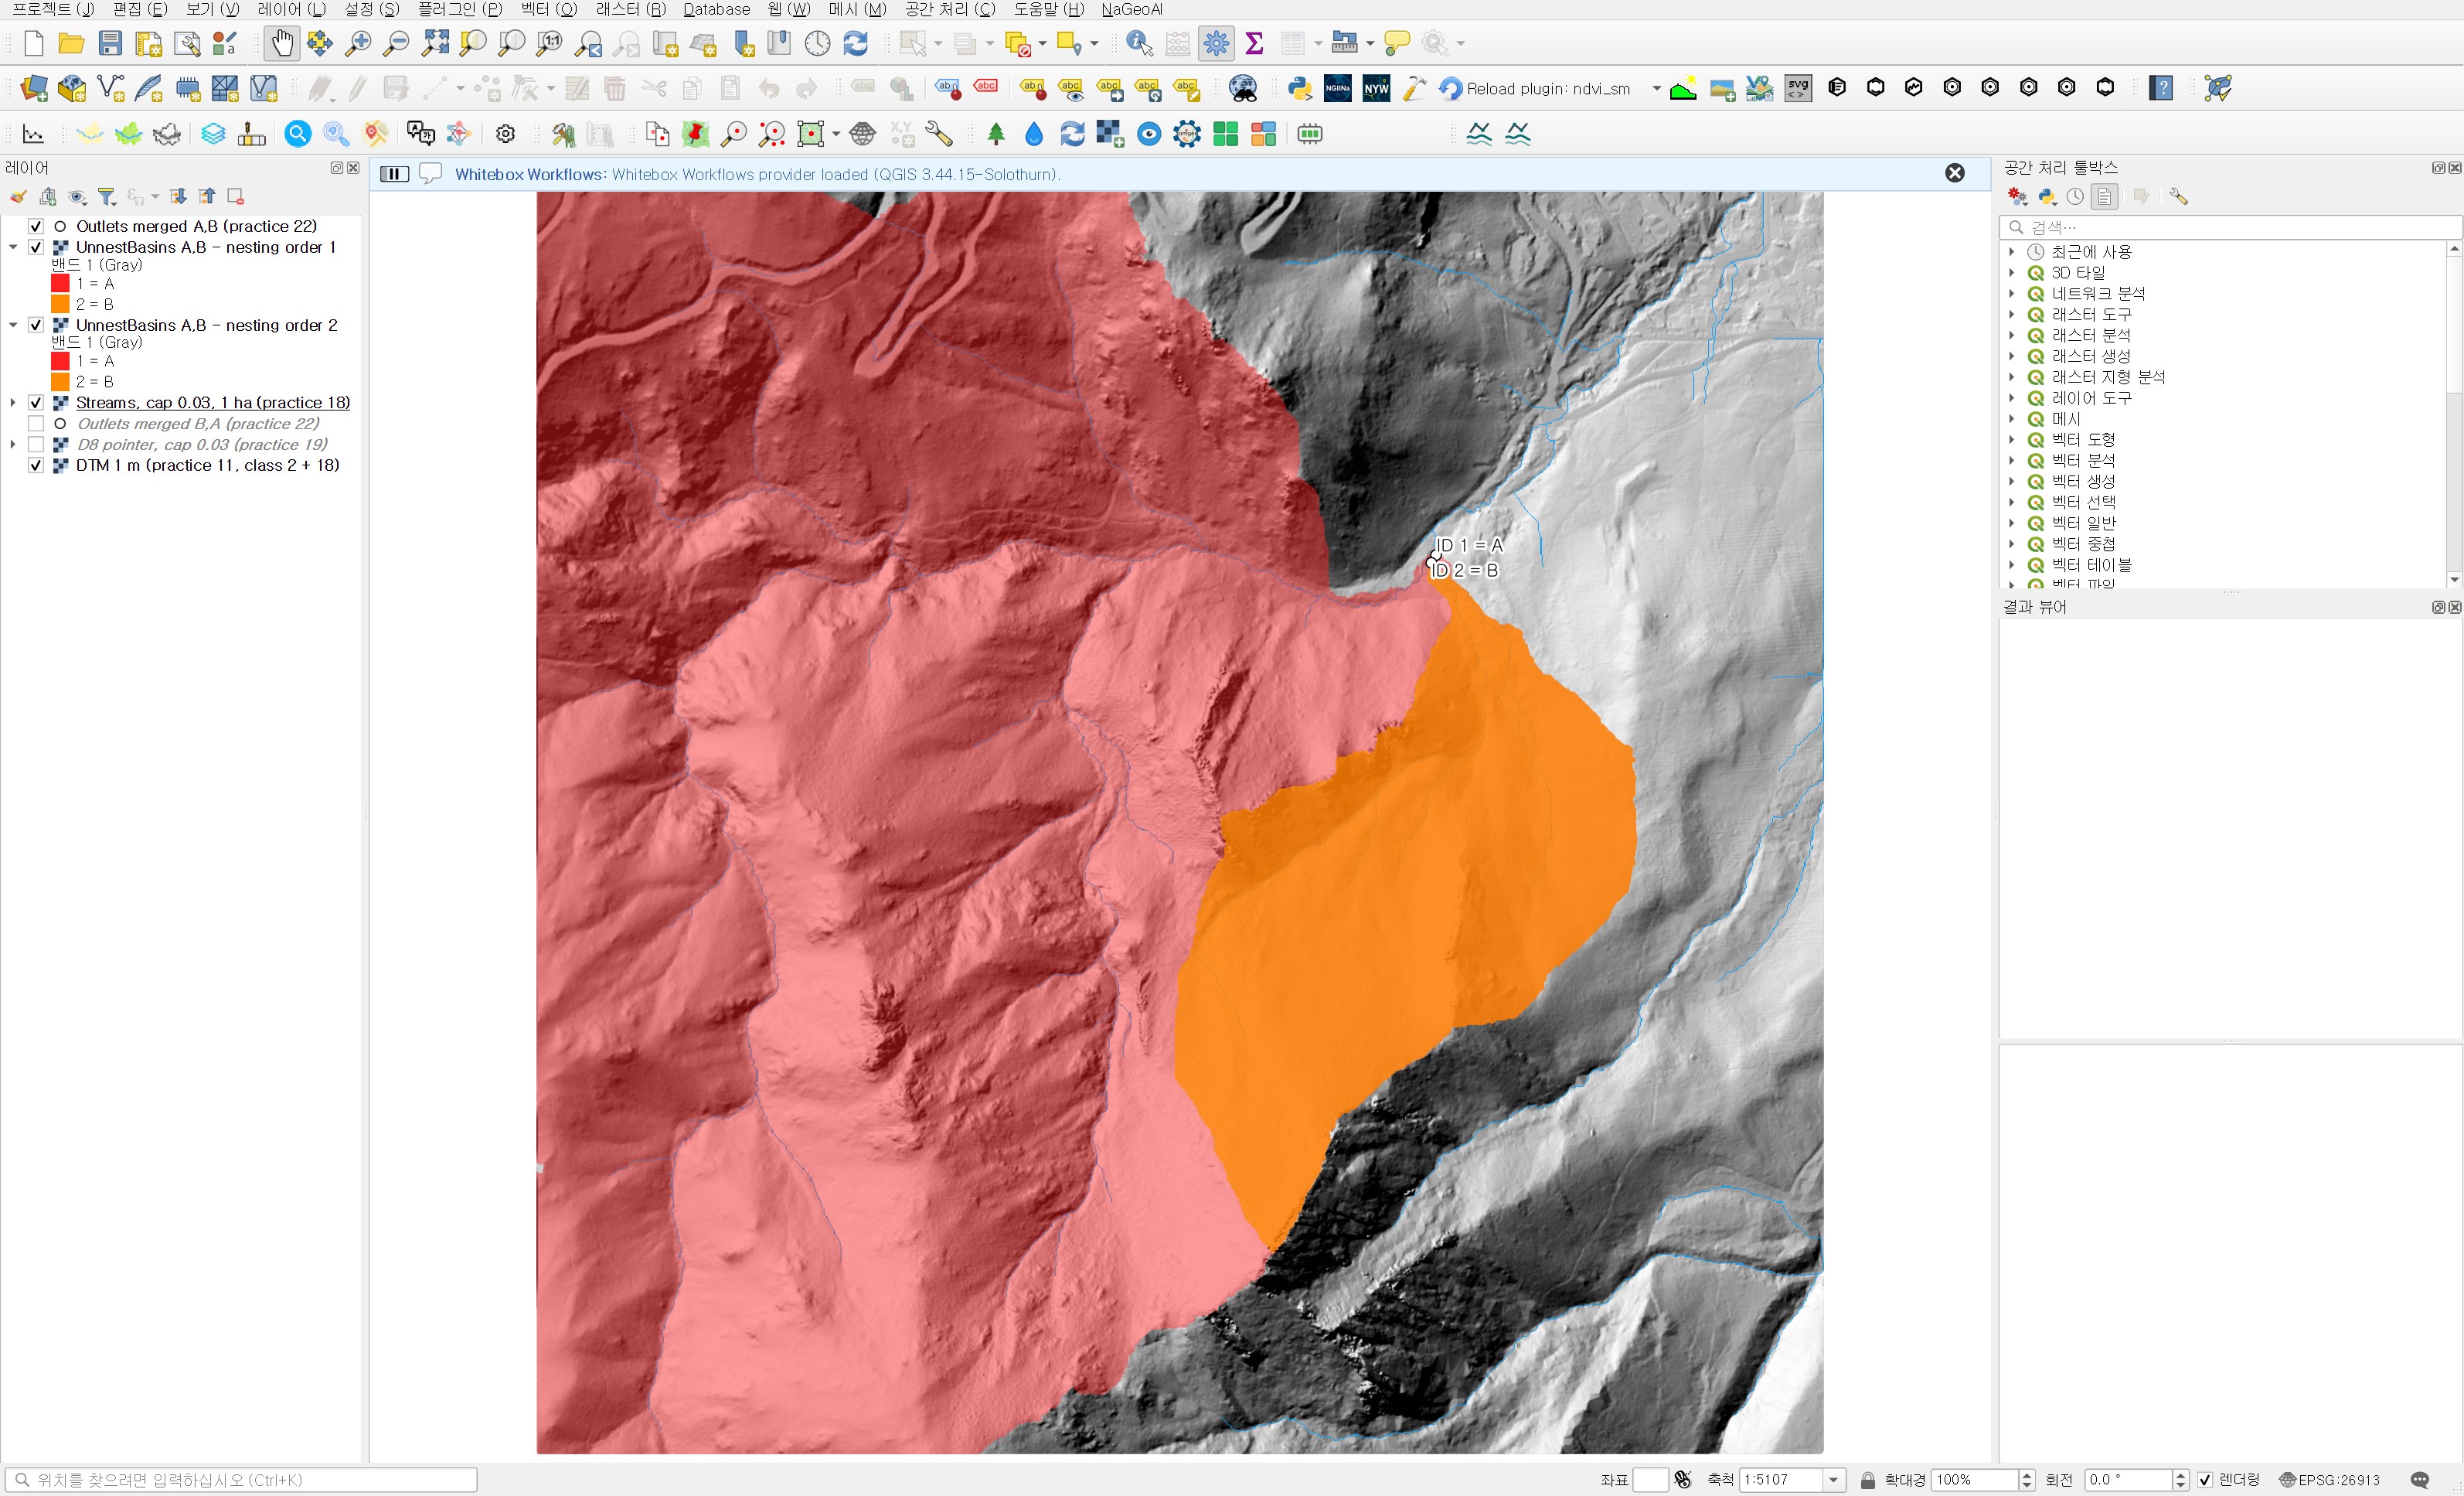
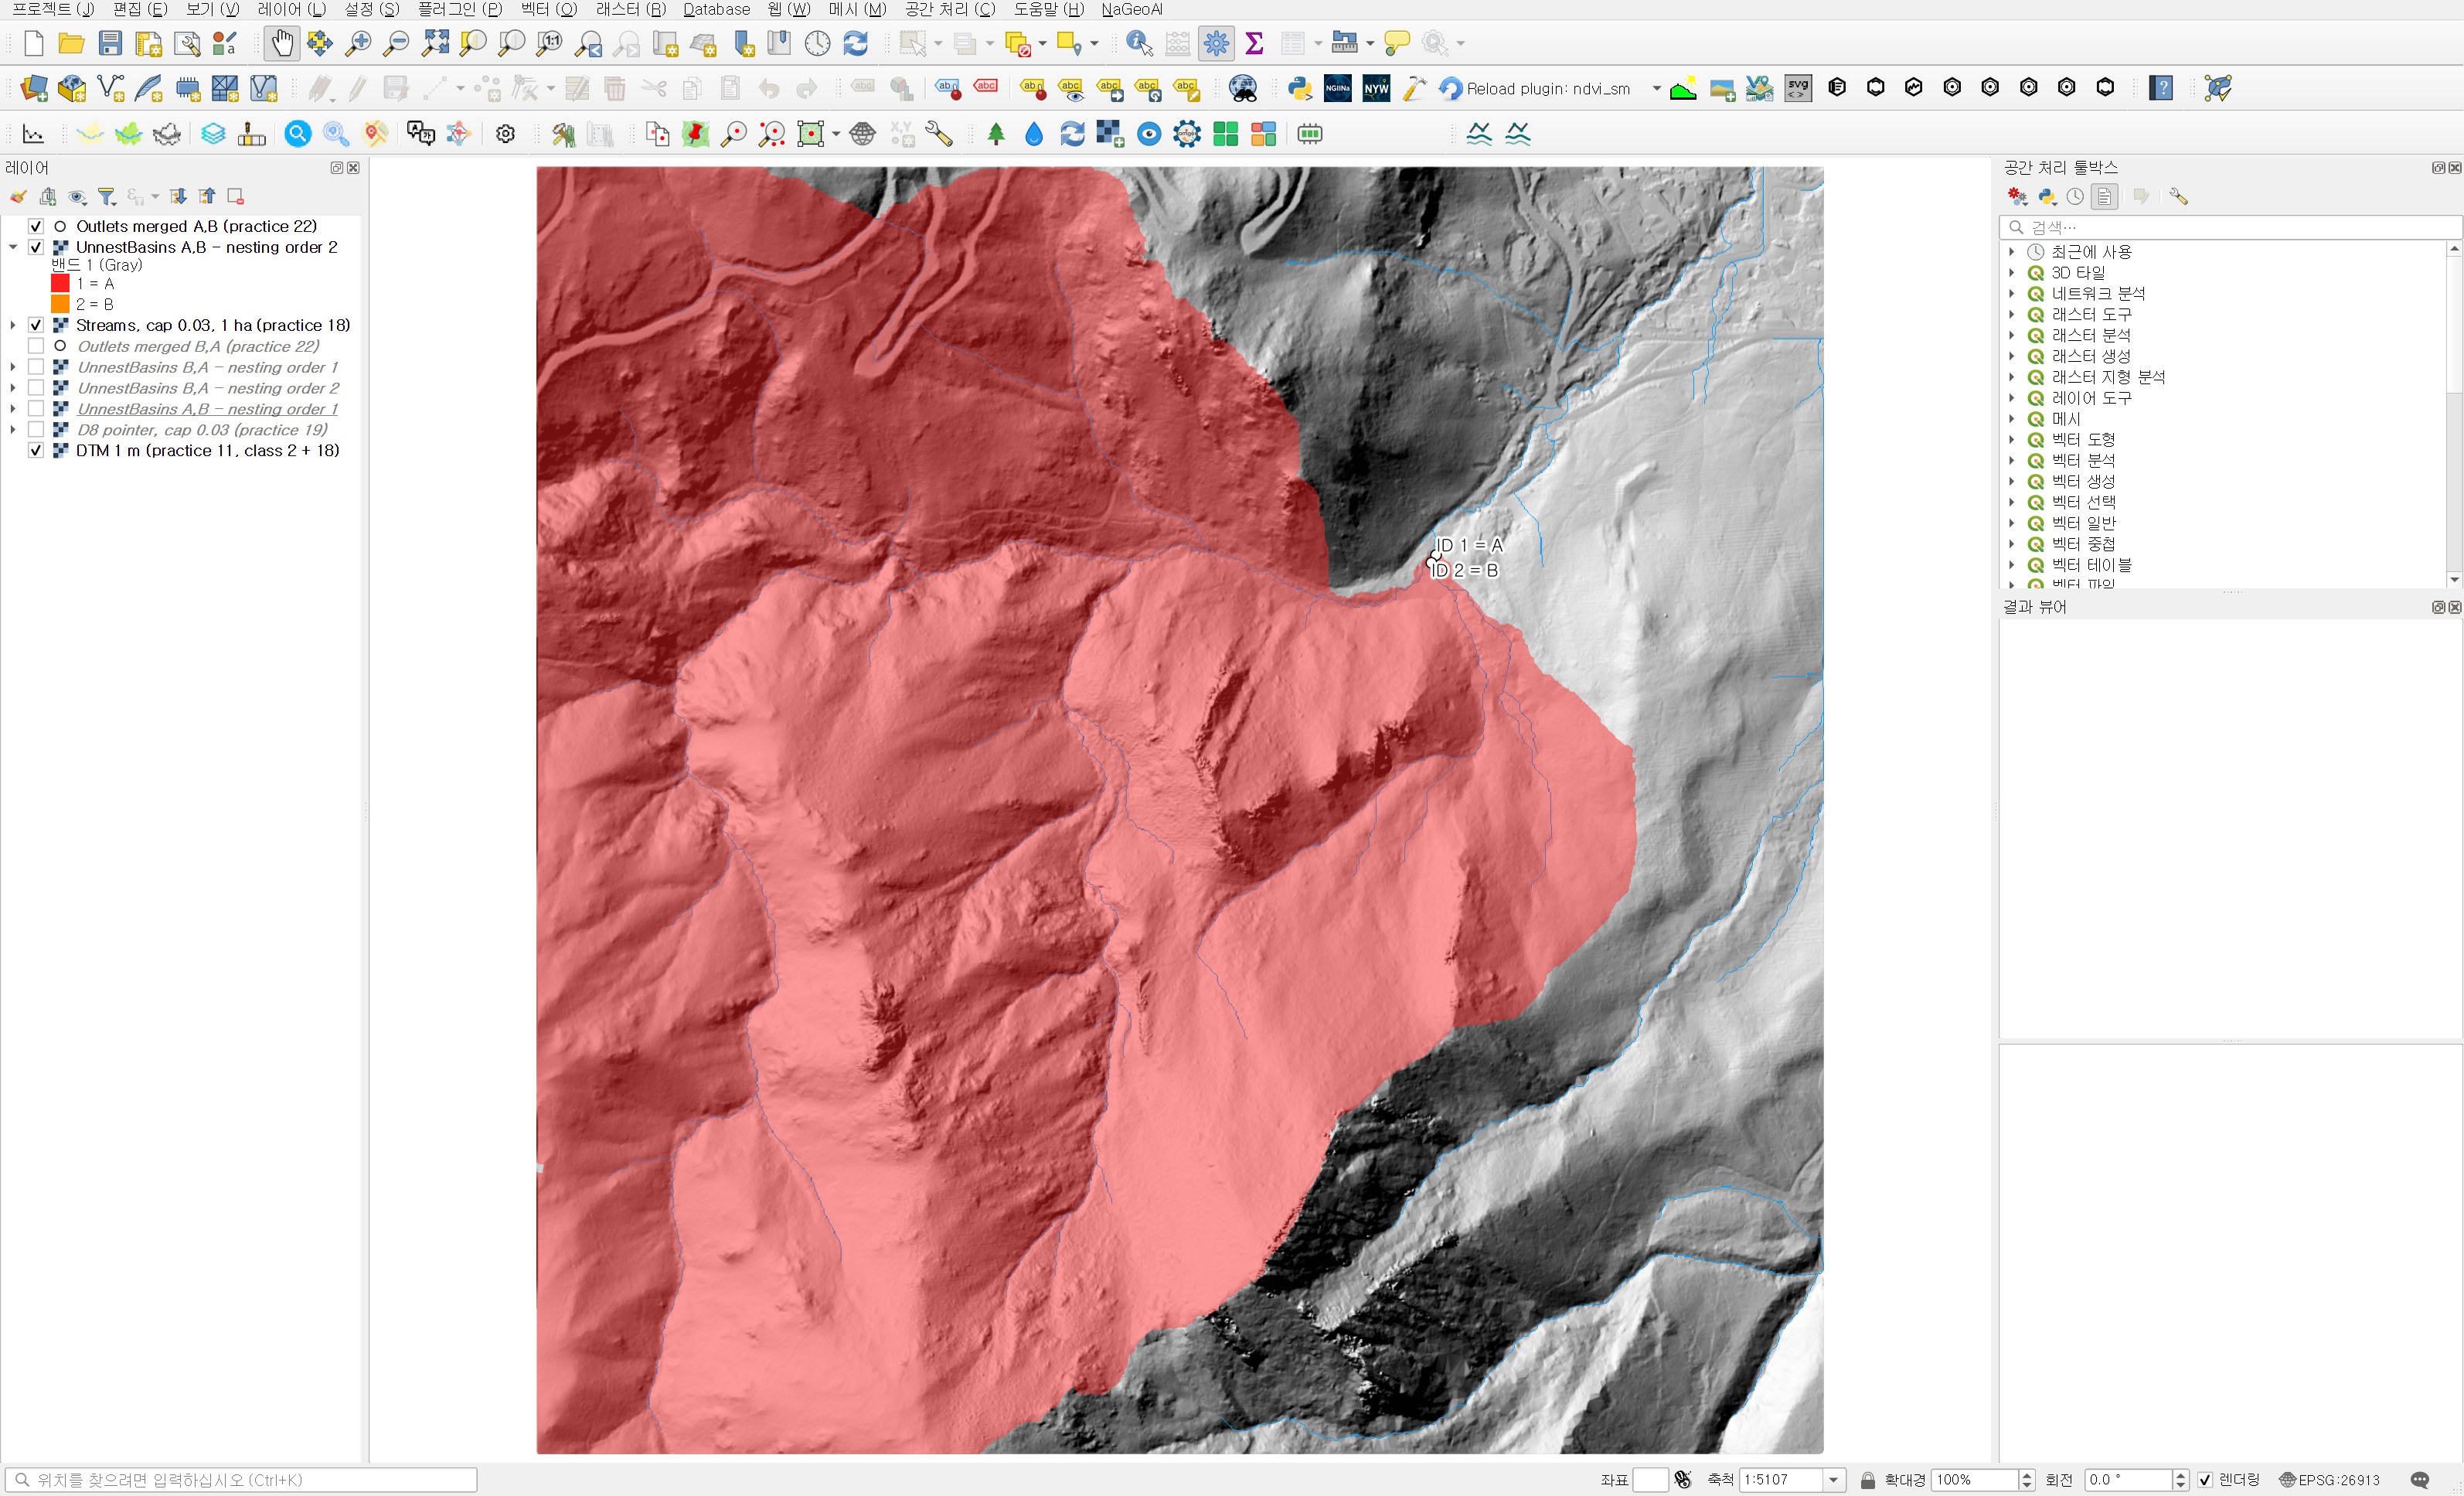
모양만 보면 22편 그림과 비슷하다. 차이는 _2 하나만 켜 보면 드러난다. 주황이 있던 자리까지 빨강으로 차 있다.
B, A 순서 파일로도 한 번 더 돌렸다. 파일 나뉘는 방식은 그대로였다. B는 _1, A는 _2에 들어갔고 셀 위치 차이도 두 파일 모두 0개 셀이었다. 바뀐 건 22편처럼 래스터 값뿐이다. 값은 이번에도 점 파일의 레코드 순서를 따랐고, 파일 번호는 레코드 순서가 아니라 유역이 겹친 정도로 정해졌다.
22편 결과와의 관계
22편 Watershed 결과와 맞춰 보면 두 도구가 무엇을 다르게 내는지가 분명해진다. 22편의 B 몫(값 2)은 이번 _1과 셀 단위로 같다. 22편의 A 몫과 B 몫을 합친 범위는 이번 _2와 같다. 결국 Watershed는 겹친 유역을 유출구 사이 구간으로 잘라 한 장에 담고, UnnestBasins는 유출구마다 전체 유역을 남기되 서로 겹치는 것들은 다른 파일로 나눈다. 이번 결과에서는 파일마다 유역이 하나씩 들어 있었다.
하천 셀도 같은 식으로 나온다. _1의 B 유역 안 1 ha 하천은 1,371개 셀, _2의 A 유역 안은 7,761개 셀이다. 22편에서 A 몫 6,390개 셀과 B 몫 1,371개 셀로 나뉘었던 숫자를 더하면 7,761개 셀이 된다.
판단
유출구별 전체 집수 면적이 필요하면 UnnestBasins 한 번으로 충분하다. 유출구 수십 개를 하나씩 Watershed로 돌릴 필요가 없다. 관측소 여러 곳의 비유량을 한꺼번에 낼 때 쓰기 좋다. 반대로 구간별 유입 면적이 필요하면 22편처럼 Watershed를 쓰면 된다. 두 결과는 이번 자료에서 셀 단위로 서로 맞아떨어졌으니, 한쪽 결과로 다른 쪽을 검산할 수도 있다.
다만 유출구가 많고 여러 겹으로 겹치면 파일 수가 겹친 깊이만큼 늘어난다. 이번에는 두 겹이라 _1, _2 두 개였다. 면적 표를 만들 때는 파일별로 값마다 셀 수를 세서 합쳐야 하고, 값과 유출구의 대응은 22편처럼 레코드 순서로 맞춰야 한다.
실무에서 챙길 것
- QGIS의 "제대로 생성되지 않았습니다" 경고는 이 도구에서는 실패가 아니다. 산출 폴더에서 이름 뒤에 _1, _2가 붙은 파일을 확인하고 직접 불러온다.
- 다시 돌리기 전에 산출 폴더를 비우거나 이름을 바꾼다. 같은 이름 뒤에 번호가 붙으므로 이전 결과를 덮어쓸 수 있다.
- 파일 번호는 겹친 깊이, 래스터 값은 레코드 순서다. 두 가지를 같이 적은 대응표를 남긴다.
- 결과 자료형이 Watershed(int32)와 달리 int16이었다. 이번에는 유출구 두 개라 문제가 없지만, 유출구 번호가 32,767을 넘는 대규모 작업이라면 확인해 볼 부분이다.
다음 회차
래스터로는 겹친 유역을 파일 두 개로 나눌 수밖에 없지만, 폴리곤은 한 레이어 안에 겹쳐 담을 수 있다. 다음에는 _1, _2 두 결과를 폴리곤으로 바꿔 한 레이어로 합치고, 유출구별 전체 면적을 속성 표에서 바로 읽을 수 있게 정리해 보려고 한다.
작업 메모
이번 회차는 QGIS 시작 스크립트로 같은 대화상자에 값을 넣어 실행했고, 화면은 그때 캡처한 것이다. 원본 프로젝트는 그대로 두고 복사본(QGIS_Play_NaGeoAI_20261111_23_unnest.qgz)에서 작업했다. 자료 출처는 USGS 3DEP(The National Map) 타일 13SDE474426이고, 원본 점군과 DTM은 다시 배포하지 않는다. 출력 래스터는 다시 읽어 21편 유역, 22편 Watershed 결과, numpy로 따로 모은 유출구별 전체 유역과 셀 단위로 비교했다. QGIS 3.44.15, WhiteboxTools 2.2.0. SHA-256 앞 12자리:
- 입력 DTM 069a9c249240
- D8 포인터 0.03(19편) ce45b57cf7ac
- 병합 점 A,B / B,A(22편) .shp dfd95ae7b05b / 7f714af8636e
- A,B 결과 _1 / _2 b551f5c79e18 / de4a690ba7c6
- B,A 결과 _1 / _2 caefca3919ce / ad685c58945b


댓글 없음:
댓글 쓰기