
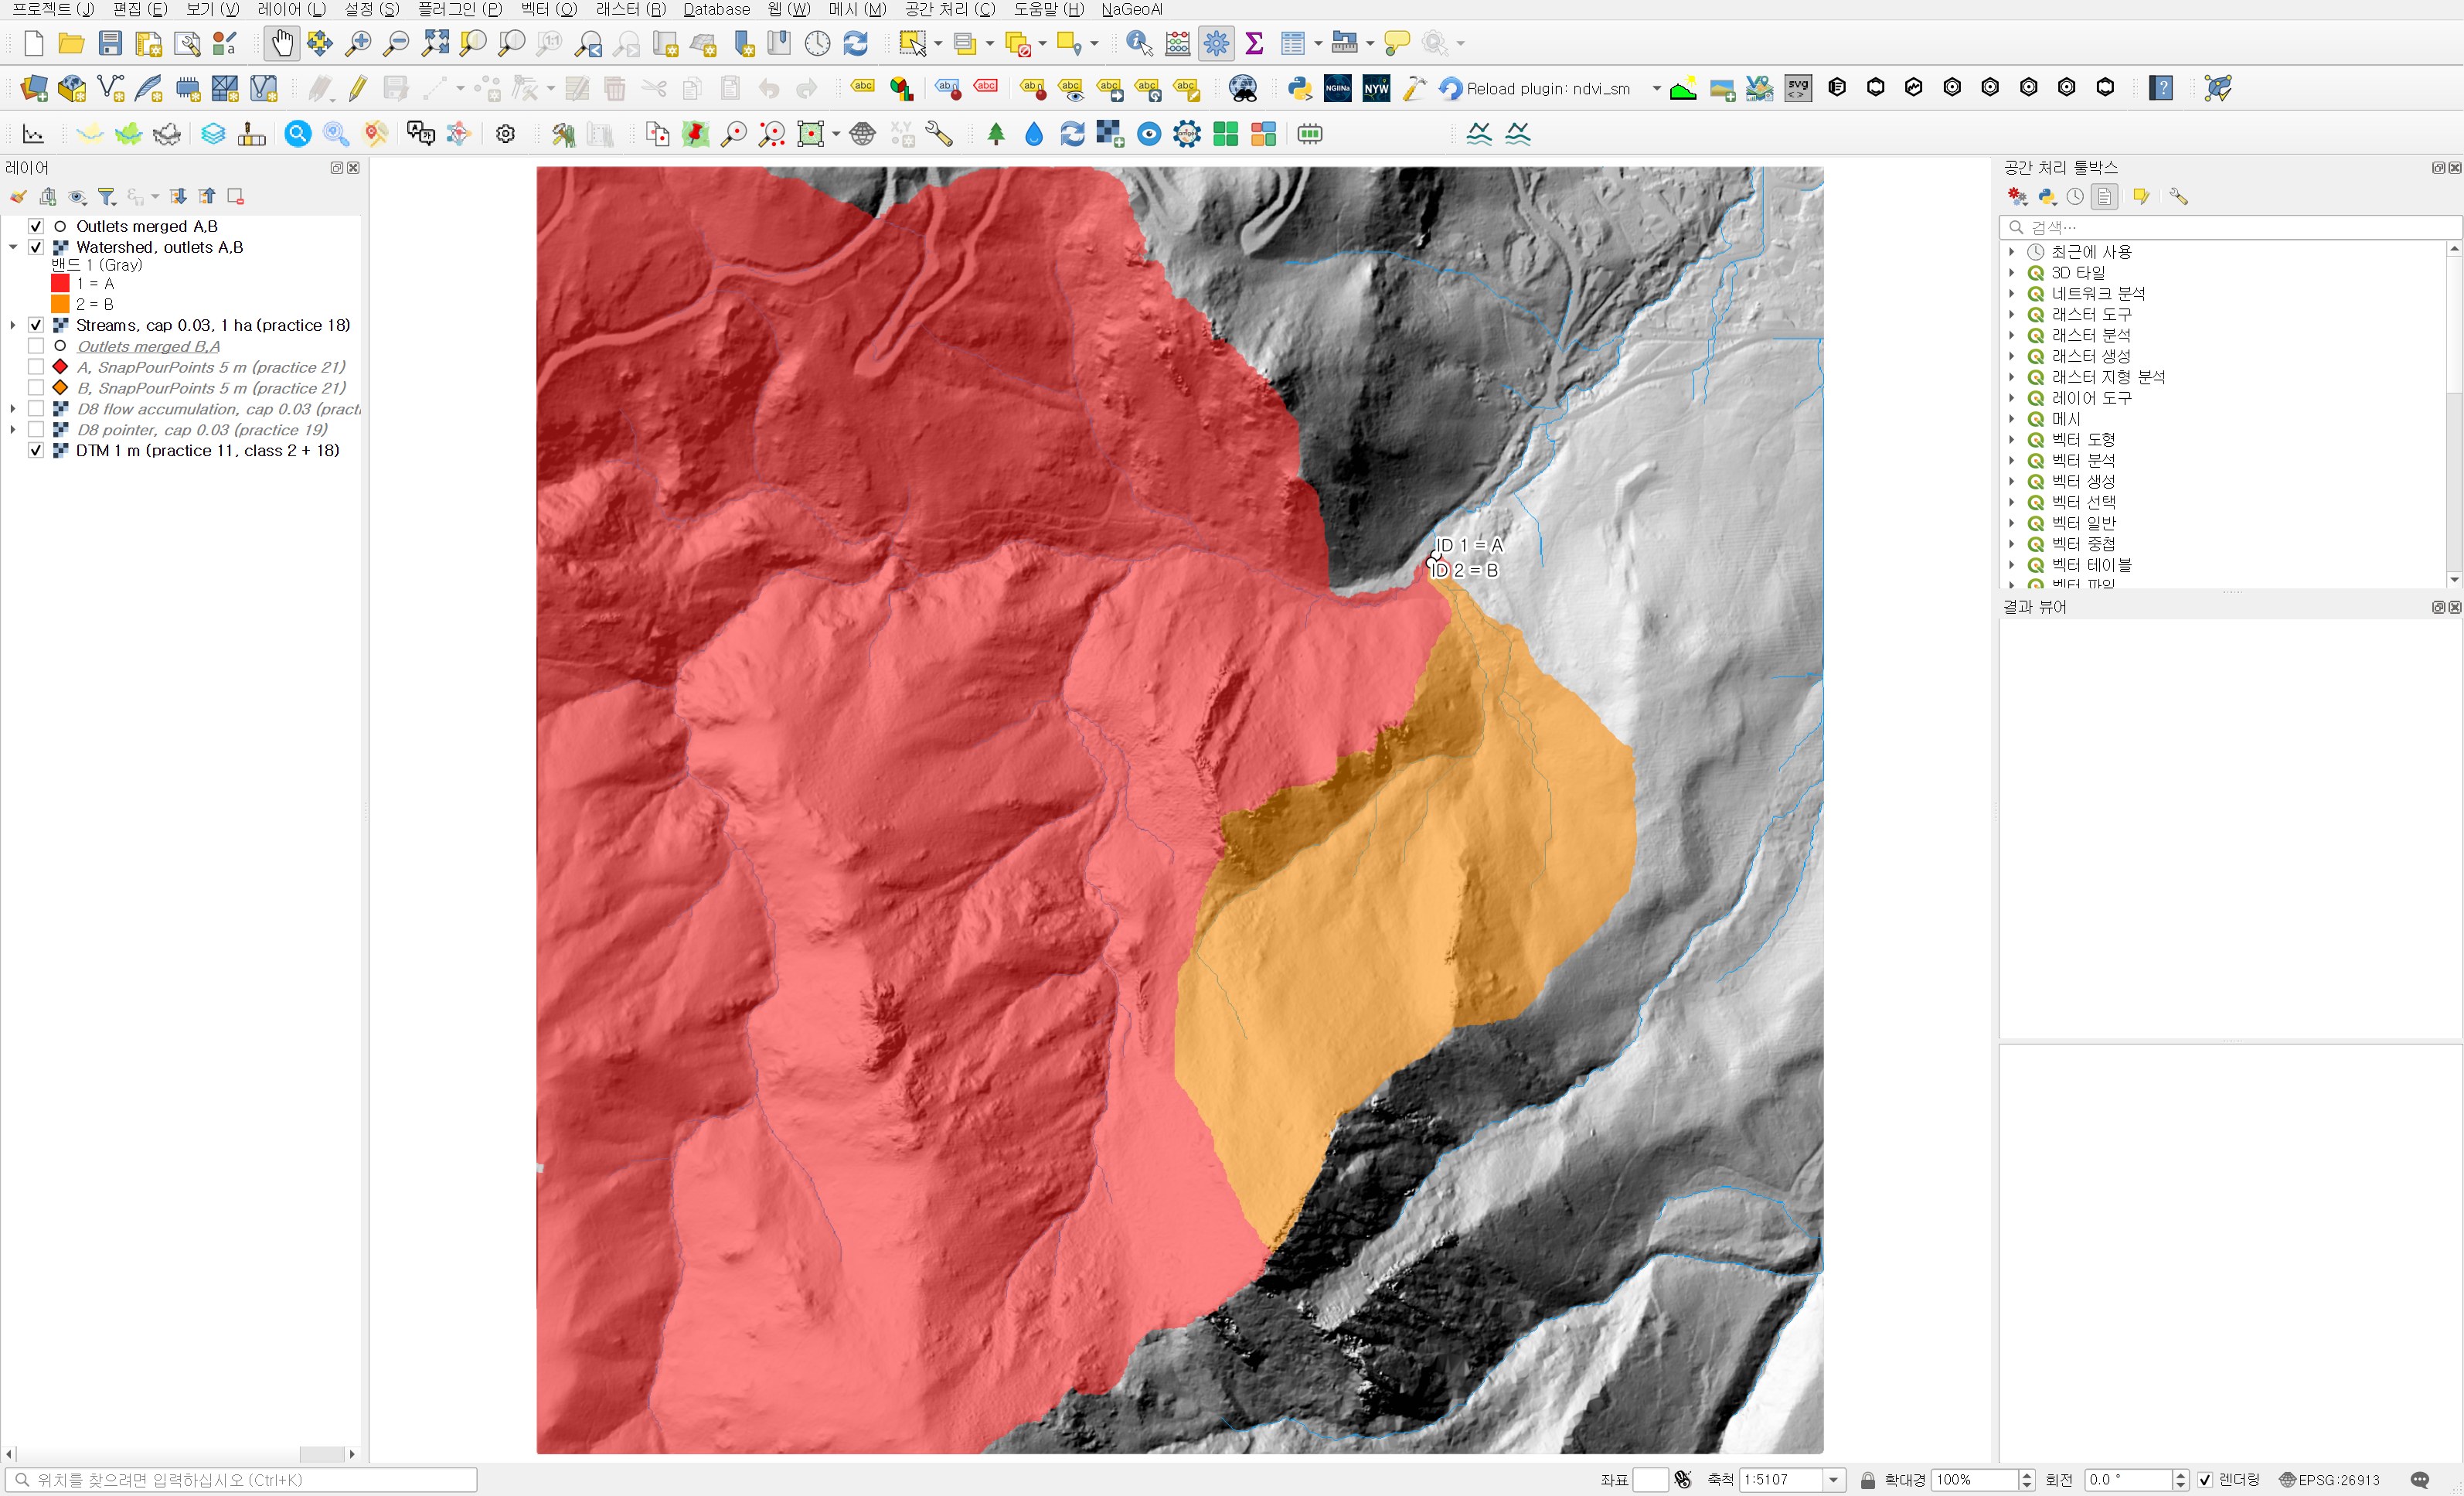
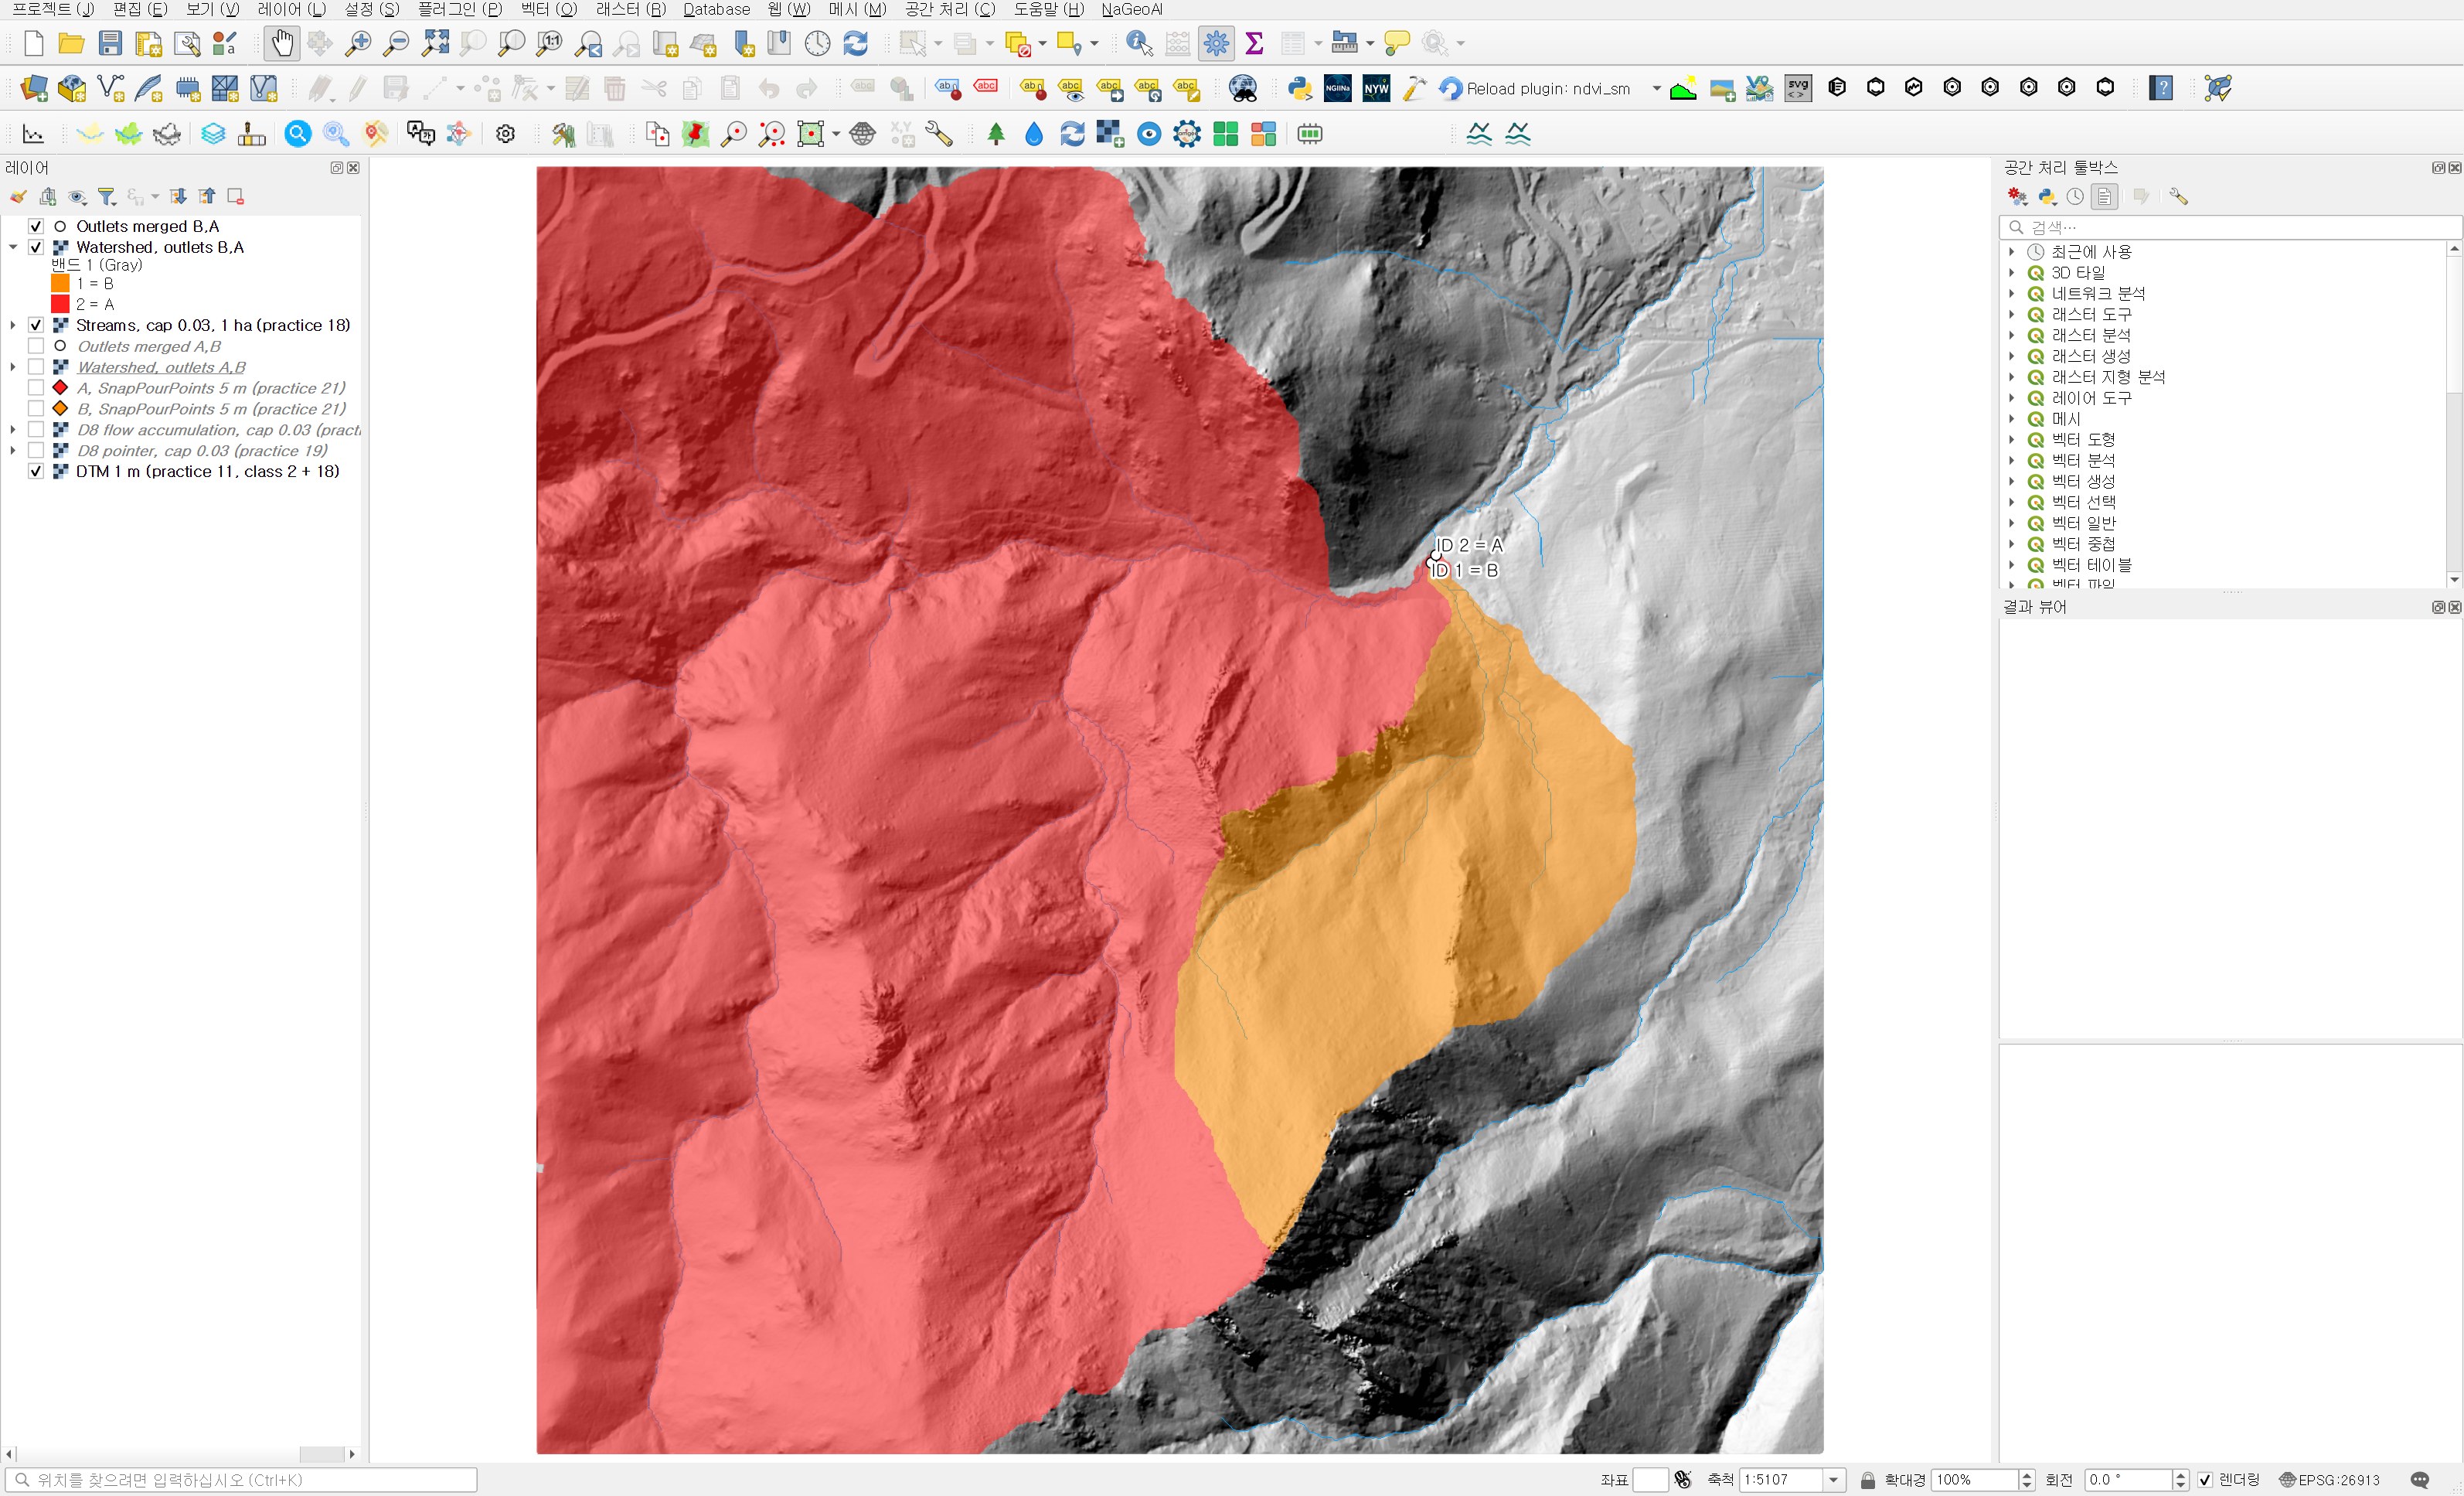
20편과 21편에서는 유출구 지점을 하나씩 따로 Watershed에 넣었다. 본류에 붙은 점 A를 넣으면 143 ha, 합류 직전 지류에 붙은 점 B를 넣으면 21 ha가 나왔다. 그런데 실무에서는 관측소나 다리 여러 곳을 한 점 파일로 만들어 한 번에 돌리는 경우가 더 많다. 이때 B 유역은 A 유역 안에 통째로 들어가 있다. 한 래스터 안에서 겹친 두 유역을 어떻게 칠할지 궁금했고, 결과부터 말하면 A는 143 ha가 아니라 122 ha로 나왔다. B가 자기 몫 21 ha를 가져가고 남은 부분만 A로 칠해진다.
자료와 유출구 지점
입력은 21편 그대로다. 11편 1 m DTM(USGS 3DEP 타일 13SDE474426, NAD83 UTM 13N EPSG:26913, 1,500×1,500 셀), 19편의 절개 상한 0.03 D8 포인터, 18편의 상한 0.03 흐름누적과 하천(1 ha), 그리고 21편에서 SnapPourPoints 5 m로 옮긴 점 A와 B를 새 입력 폴더로 복사했다. 비교용으로 21편에서 A, B를 따로 돌린 유역 래스터도 같이 복사했다. 복사본 해시는 모두 원본과 같다.
| 점 | 좌표(EPSG:26913) | 놓인 셀의 흐름누적 | 따로 돌렸을 때 유역 |
|---|---|---|---|
| A | 475,048.01 / 4,427,546.99 | 1,430,152 | 1,430,152 m²(약 143.0 ha) |
| B | 475,042.01 / 4,427,537.99 | 211,372 | 211,372 m²(약 21.1 ha) |
B는 합류 직전 지류 마지막 셀이고, A는 합류점 아래 본류다. B에서 흘러내린 물은 몇 셀 뒤 A를 지난다. 위아래로 겹친 유출구의 전형적인 배치다.
1단계 — 두 점을 한 파일로 묶기
A와 B는 각각 다른 셰이프파일이다. 공간 처리 툴박스 → 벡터 일반 → 벡터 레이어 병합(native:mergevectorlayers)으로 묶었다. 같은 작업을 순서만 바꿔 한 번 더 했다. 레코드 순서가 결과에 영향을 주는지 보기 위해서다.
| 입력란 | 값 | 이유 |
|---|---|---|
| 입력 레이어 | A, B 순서 / B, A 순서 | 병합 결과의 레코드 순서가 입력 순서를 따른다 |
| 대상 좌표계 | EPSG:26913 - NAD83 / UTM zone 13N | DTM·포인터와 같은 좌표계로 고정 |
| Add source layer information | 체크(기본값) | 어느 파일에서 온 점인지 layer 필드로 남는다 |
| 병합한 산출물 | wb22_outlets_ab.shp / wb22_outlets_ba.shp | Whitebox가 읽을 수 있게 셰이프파일로 저장 |
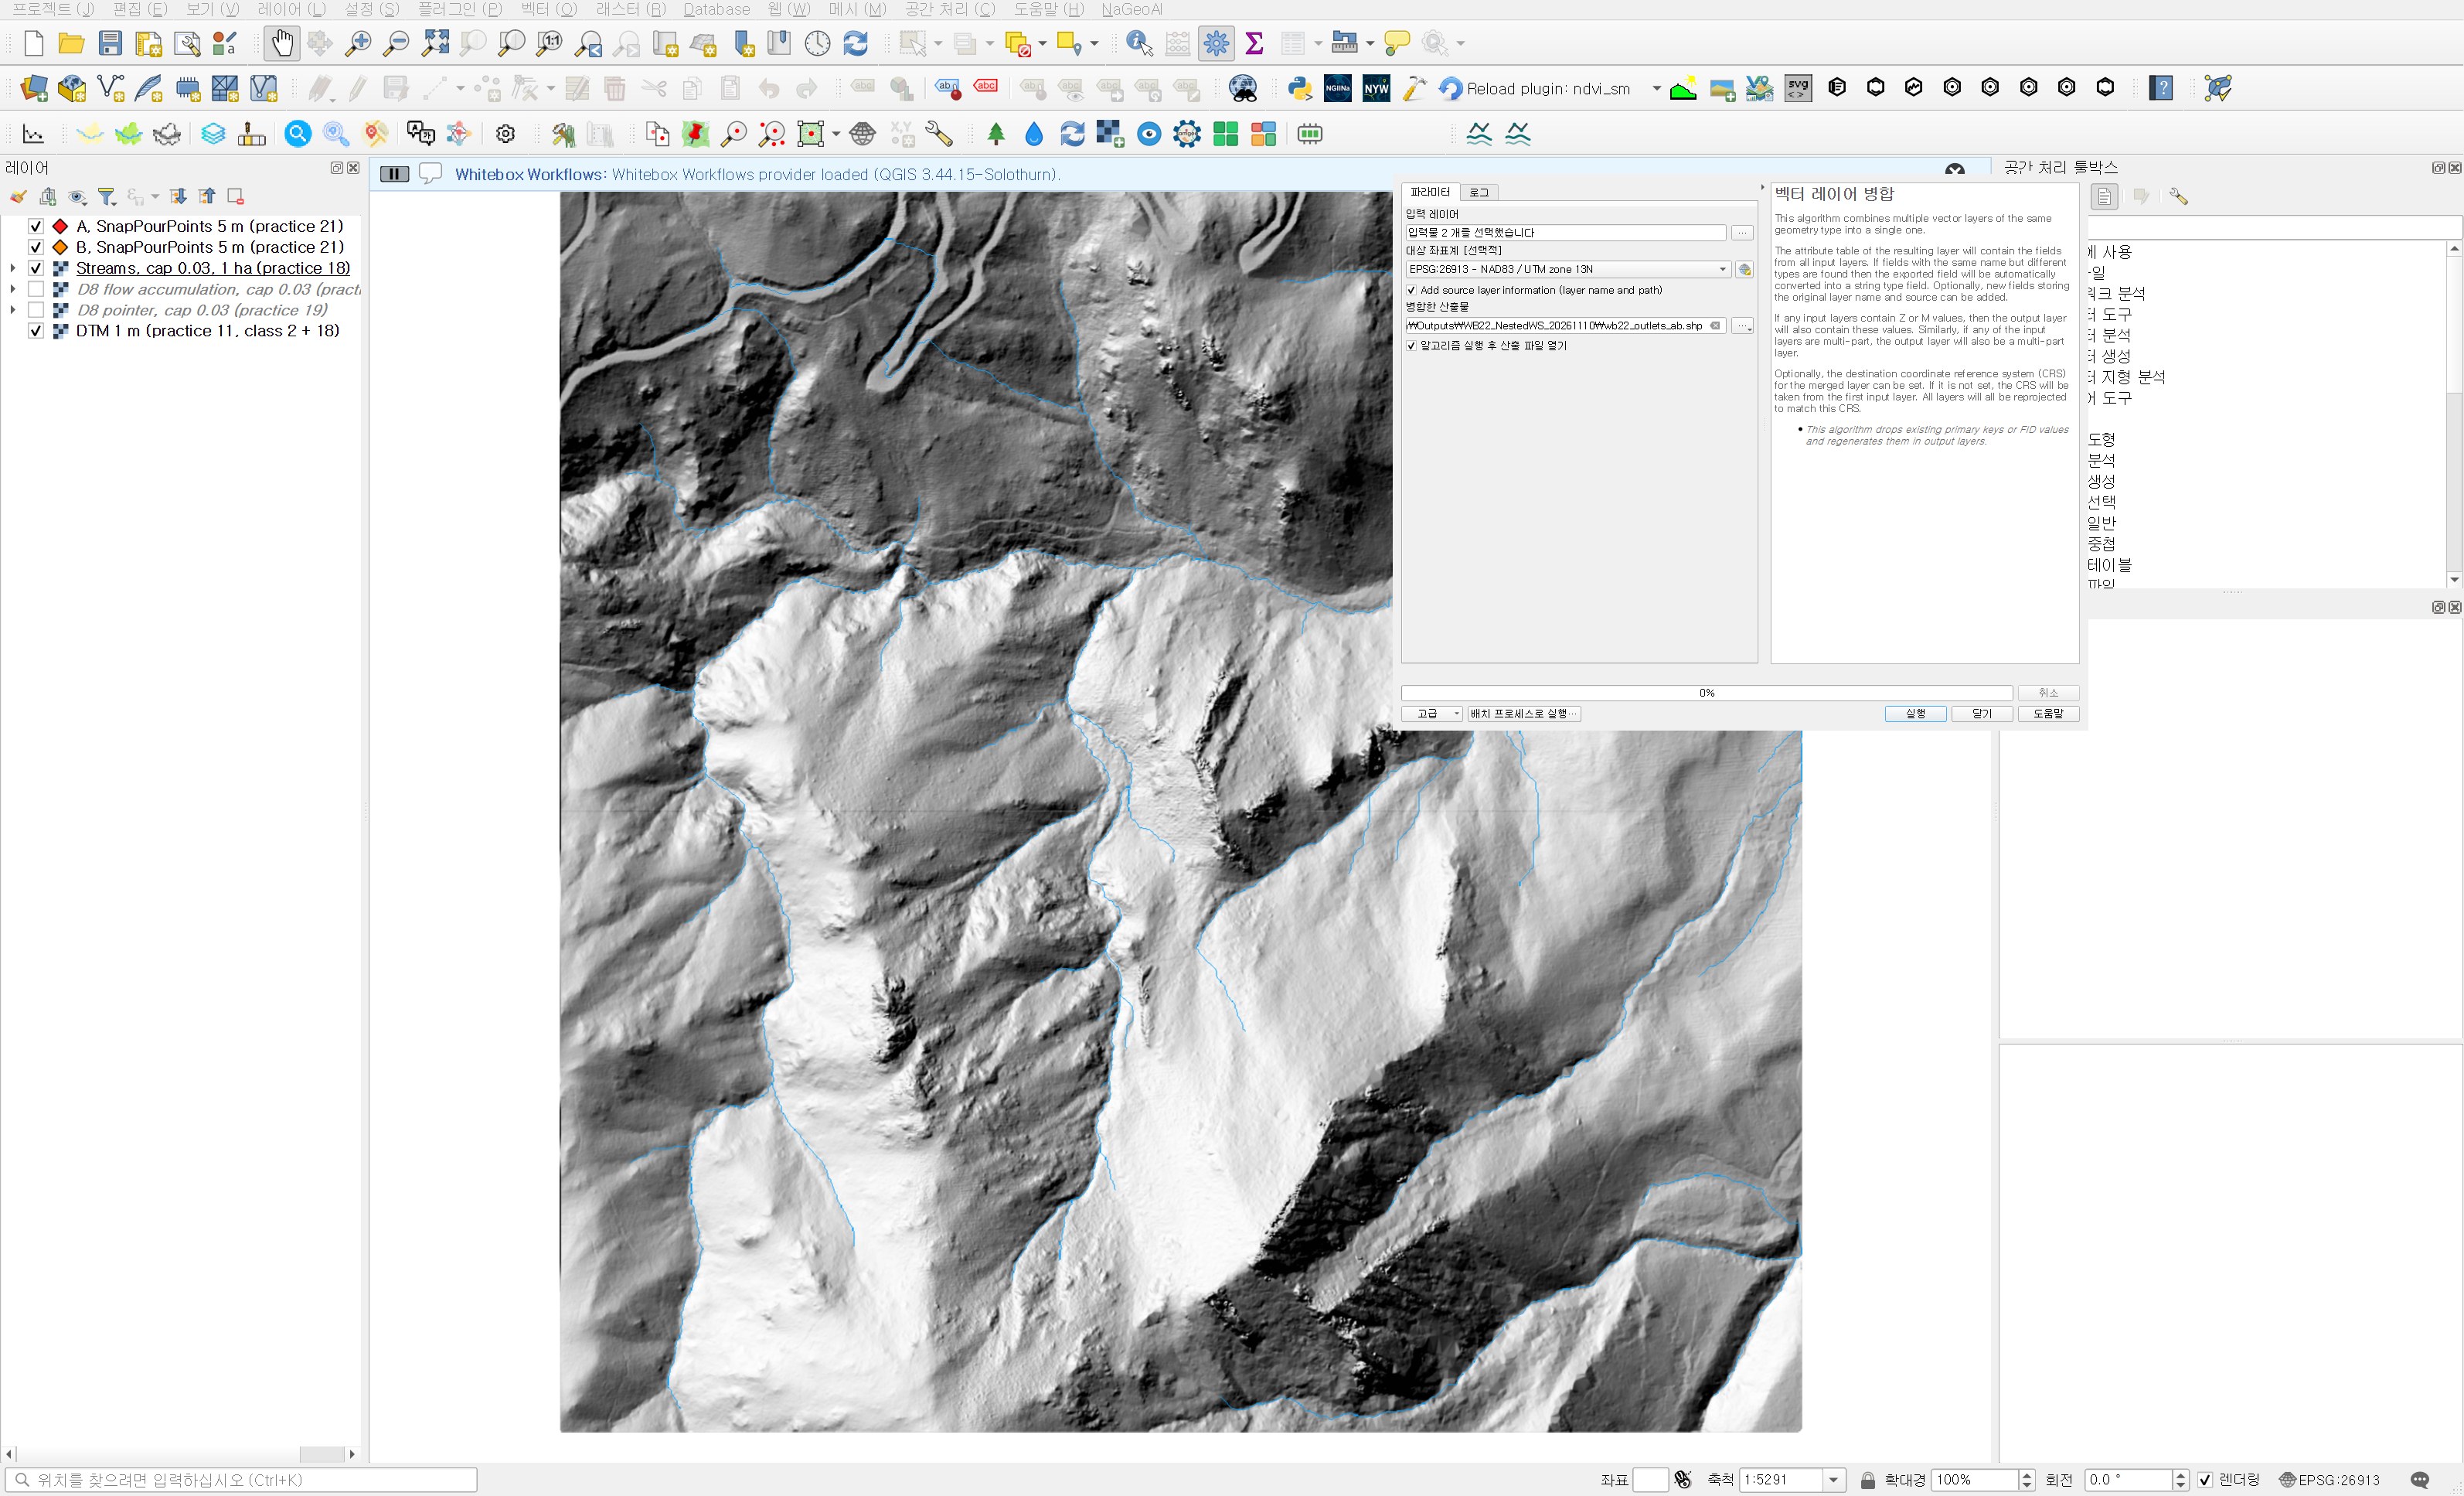
여기서 하나 걸리는 점이 있었다. 21편에서 만든 두 점 파일은 모두 id 필드 값이 1이다. 병합하고 나니 두 레코드가 똑같이 id=1을 갖고 있었다. 관측소 코드처럼 쓸 필드가 겹치는 셈인데, Watershed가 이 필드를 쓰는지 아니면 무시하는지가 다음 단계에서 드러난다.
2단계 — 묶은 점으로 Watershed 한 번
WhiteboxTools → Hydrological Analysis → Watershed에 D8 pointer, cap 0.03(19편)과 병합한 점 파일을 넣었다. ESRI 포인터 체크는 해제했다(포인터를 Whitebox 방식으로 만들었으므로). A, B 순서와 B, A 순서로 한 번씩 돌렸다.
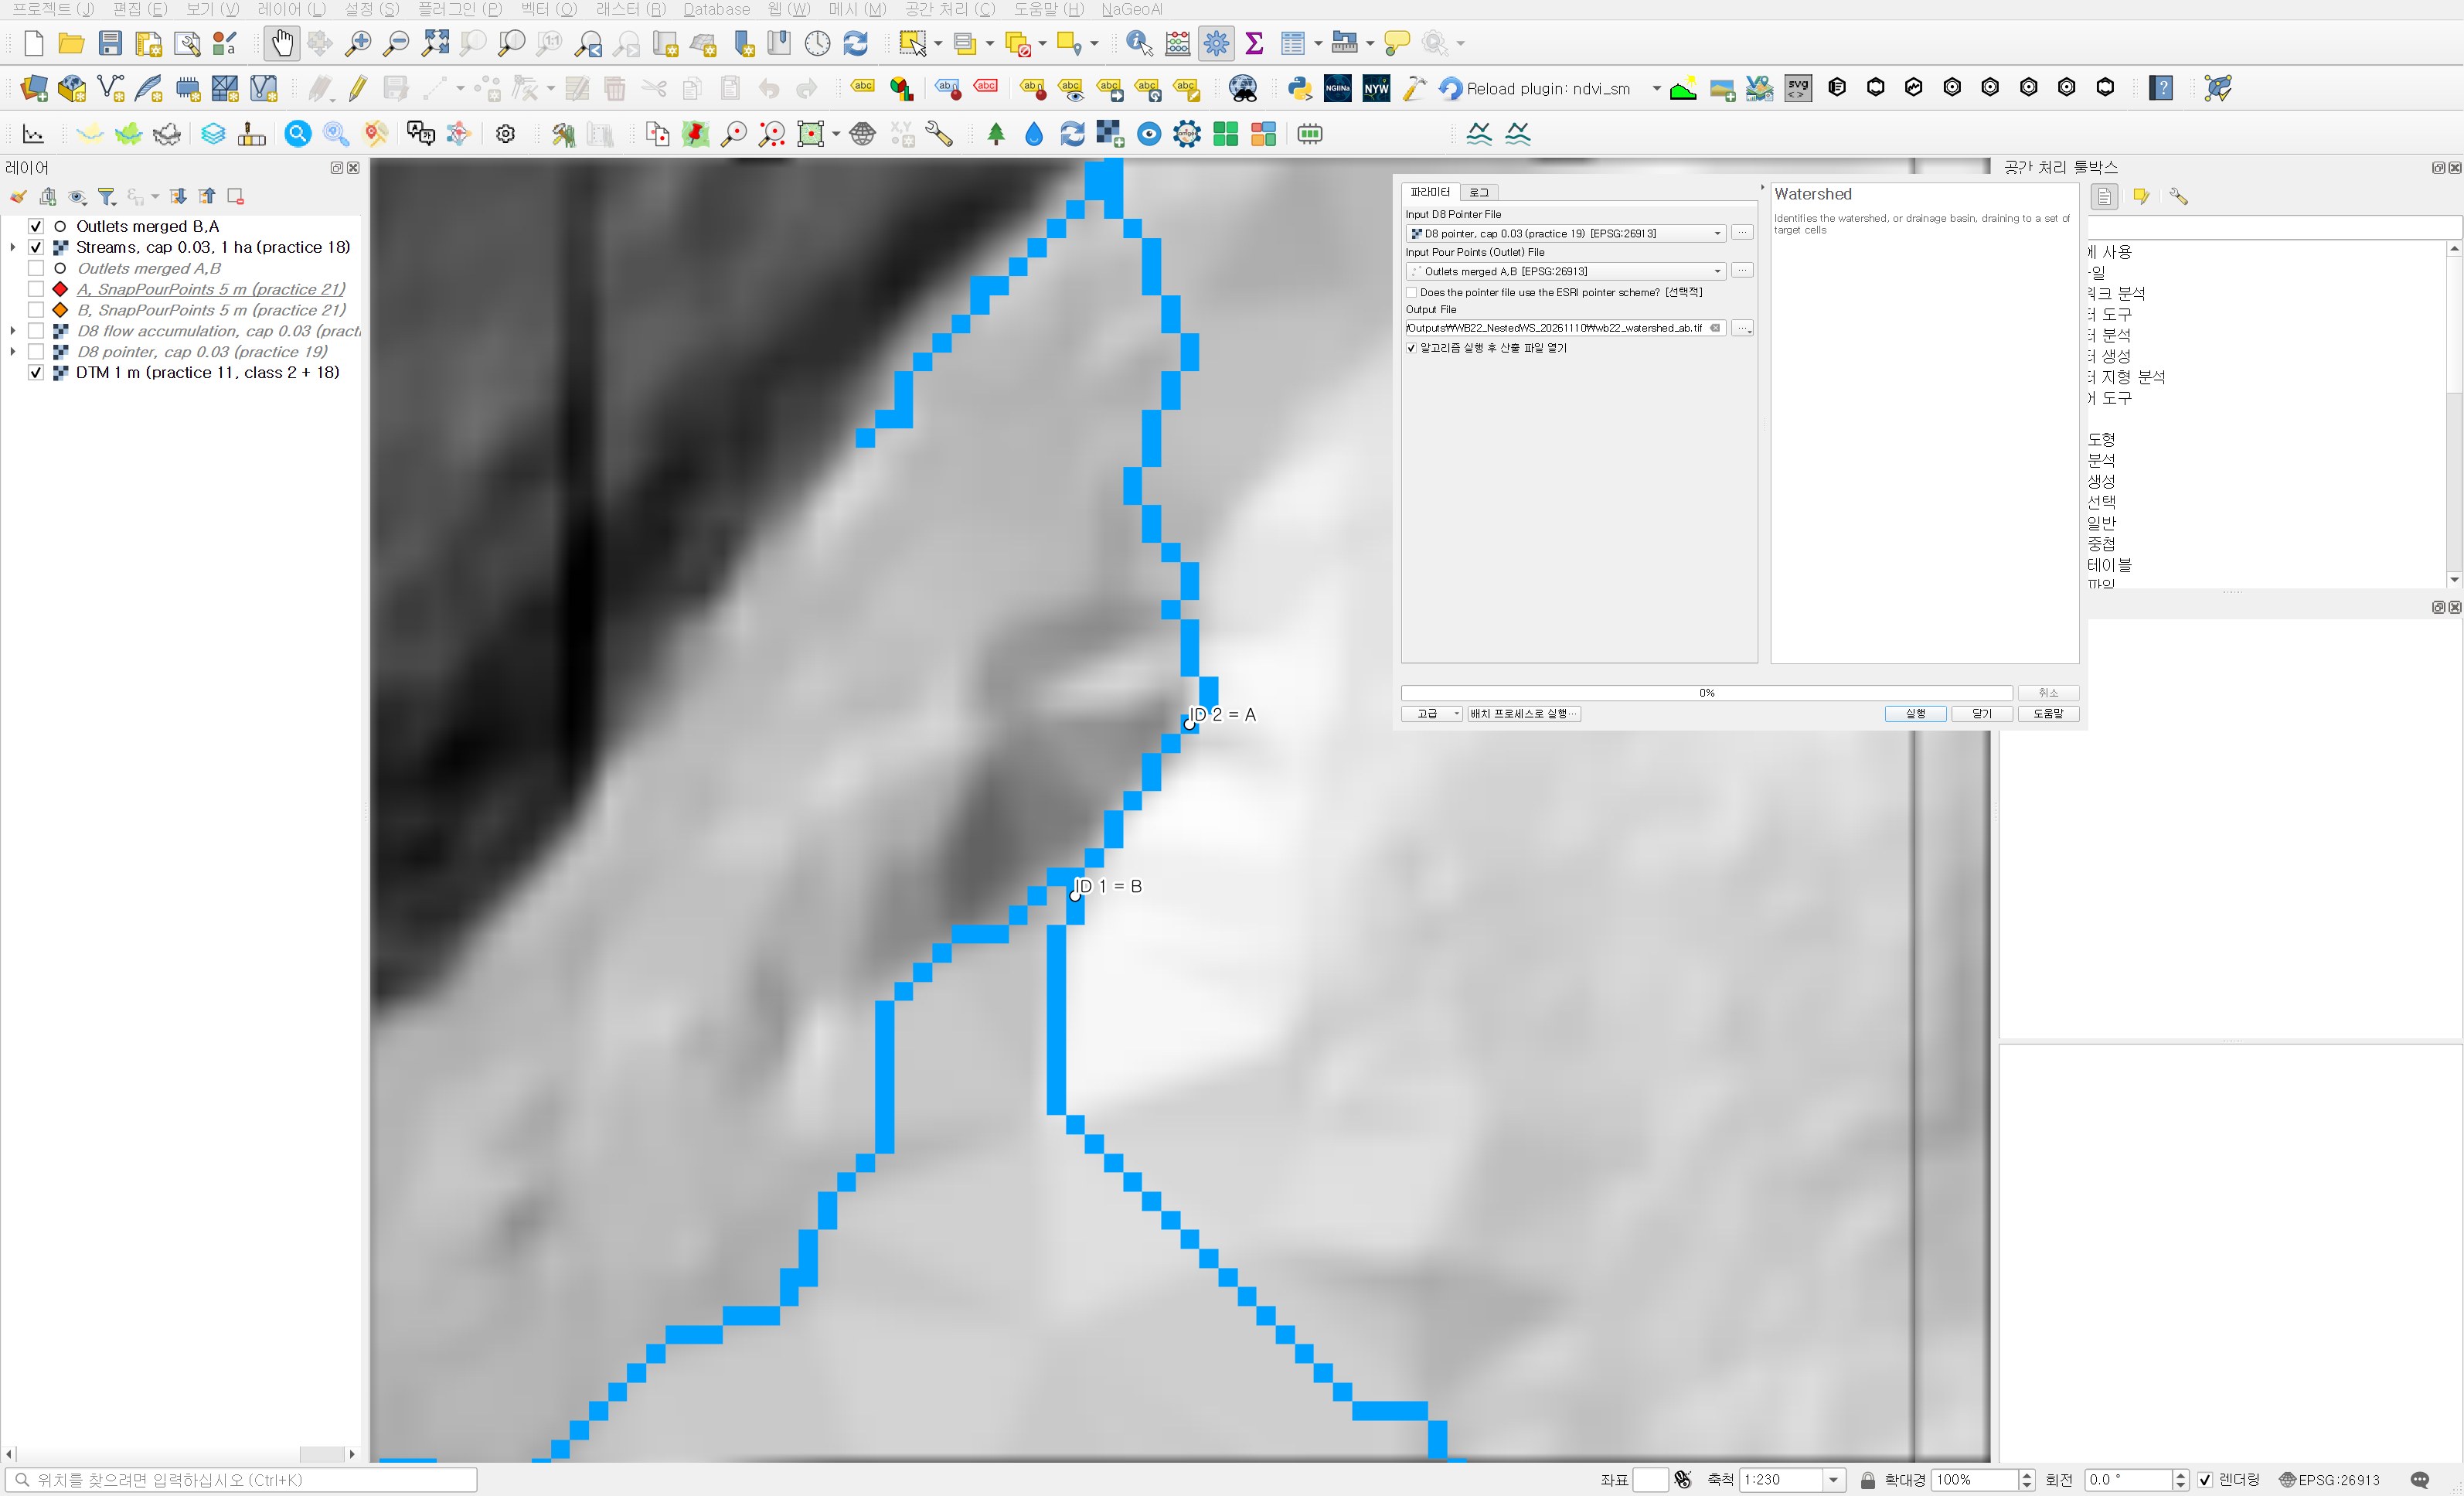
결과 래스터에는 값이 1과 2 두 가지만 들어 있었다.
| 값 | A, B 순서 파일 | B, A 순서 파일 | 셀 수(= m²) |
|---|---|---|---|
| A 몫 | 1 | 2 | 1,218,780(약 121.9 ha) |
| B 몫 | 2 | 1 | 211,372(약 21.1 ha) |
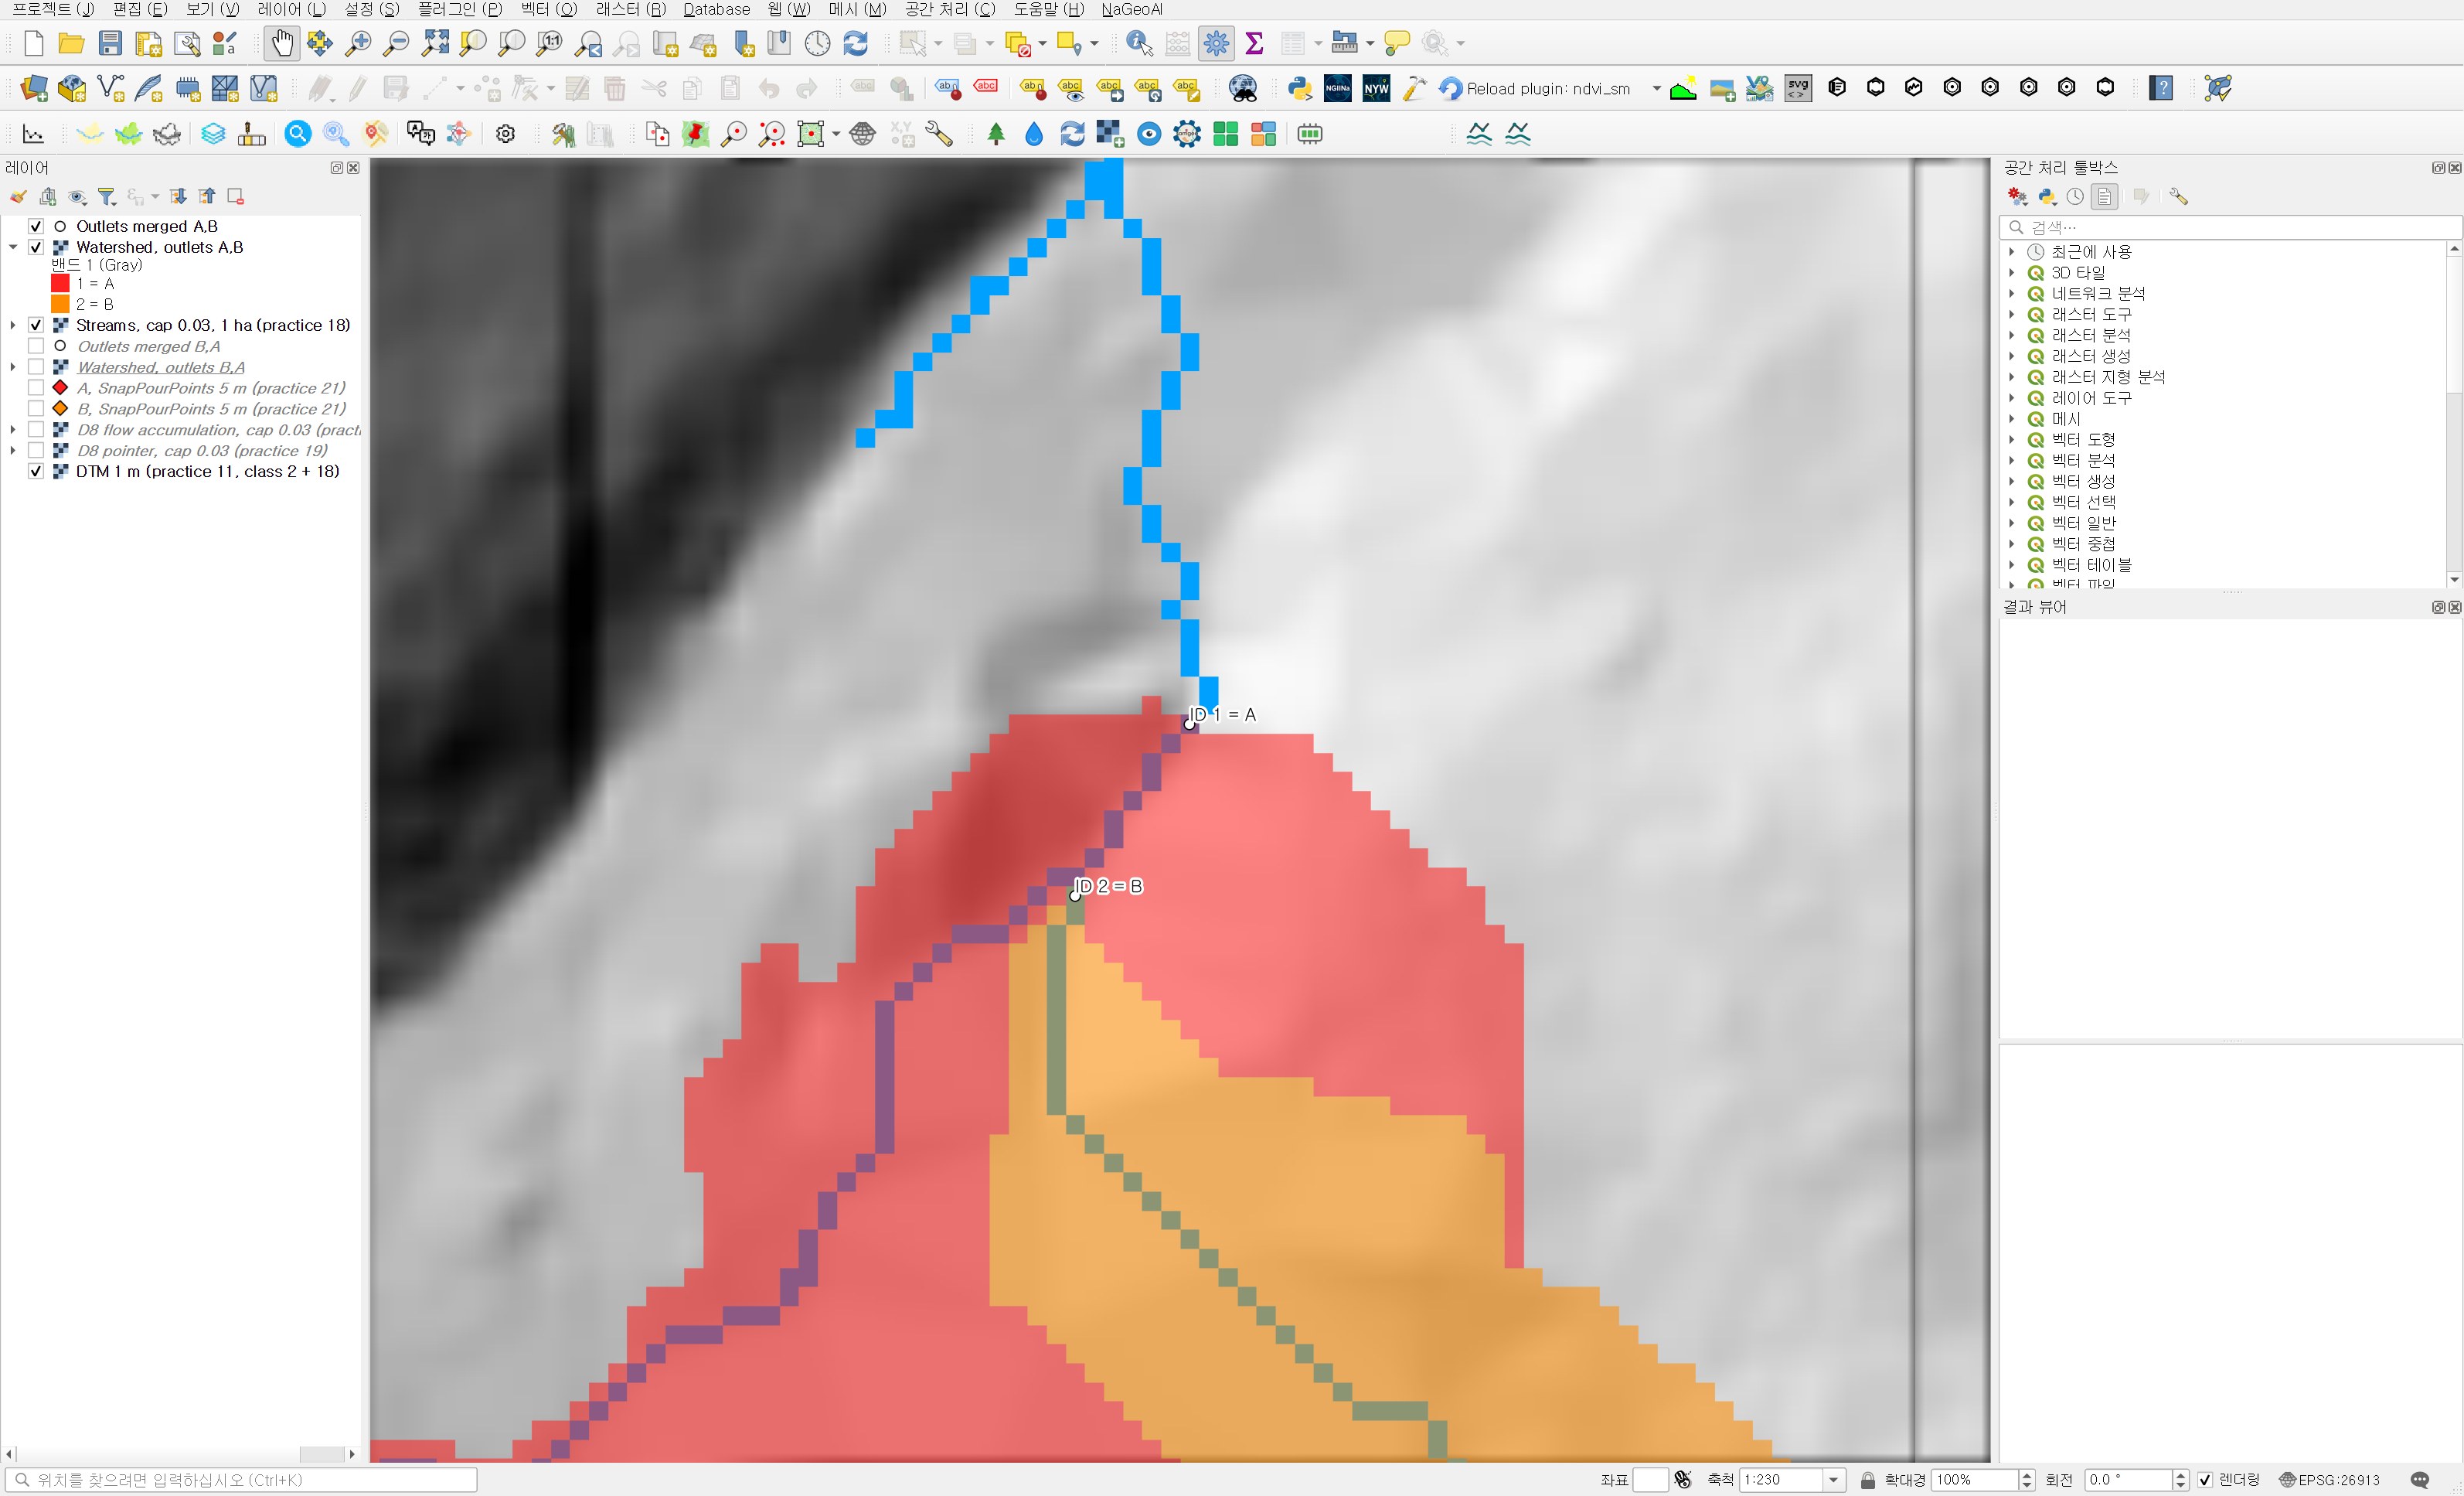
id 필드는 두 점 모두 1인데 결과 값은 1과 2로 갈렸다. 값은 파일 안의 레코드 순서를 따른 것으로 보인다. 순서를 뒤집으면 값만 바뀌고, 셀 하나하나는 그대로였다. 두 래스터에서 값을 맞바꿔 비교한 차이는 0개 셀이다.
A 유역은 왜 줄었나
Watershed는 각 셀에서 포인터를 따라 내려가다가 처음 만나는 유출구의 값을 칠한다. B 위쪽 셀은 A에 닿기 전에 B를 먼저 만나니 B로 칠해진다. 그래서 A 값을 가진 셀은 "A로 흘러가되 B를 거치지 않는 셀"뿐이다. numpy로 같은 규칙(포인터를 따라 처음 만나는 유출구)을 따로 적용해 칠해 보니 Whitebox 결과와 셀별로 하나도 다르지 않았다.
따로 돌린 21편 결과와 맞춰 보면 숫자가 딱 맞는다. 이번 A 몫 1,218,780개 셀에 B 몫 211,372개 셀을 더하면 21편 A 유역 1,430,152개 셀이고, 셀 위치까지 같다. B 몫은 21편 B 유역과 셀 단위로 같다. 하천 셀도 그렇게 나뉜다. 21편 A 유역 안 1 ha 하천 7,761개 셀이 이번에는 A 6,390개 셀, B 1,371개 셀로 갈렸다.
판단
한 번에 돌린 유역 래스터는 "각 유출구의 전체 집수 면적"이 아니라 "유출구 사이 구간이 직접 받는 면적"이다. 이번 A 몫 121.9 ha는 A 전체 집수 면적의 85.2%다. 하류 관측소 유량을 면적으로 나눠 비유량을 낼 때 이 값을 그대로 쓰면 면적을 14.8% 작게 잡게 된다. 반대로 구간별 오염 부하나 구간 유입량을 볼 때는 이게 오히려 원하는 값이다. 어느 쪽 면적이 필요한지를 먼저 정해야 한다.
값이 레코드 순서를 따른다는 점도 실무에서 걸린다. 관측소 코드를 id 필드에 넣어 두었다고 결과 래스터에 그 코드가 찍히지는 않았다. 점 파일을 정렬하거나 필터해서 다시 만들면 같은 유역이 다른 번호를 받는다. 결과를 표로 옮길 때는 래스터 값 1, 2, …를 점 파일의 레코드 순서와 대응시킨 표를 같이 남겨 둬야 한다.
실무에서 챙길 것
- 여러 유출구를 한 파일로 넣으면 위아래로 겹친 유역은 하류 쪽이 상류 몫을 뺀 나머지만 받는다. 전체 집수 면적이 필요하면 유출구별로 따로 돌리거나 상류 몫을 더해야 한다.
- 이번 결과에서 래스터 값은 id 필드가 아니라 레코드 순서를 따랐다. 병합·정렬 후에는 값과 유출구의 대응표를 새로 만든다.
- 병합 전에 점마다 겹치지 않는 코드 필드를 넣어 두면 대응표 만들 때 헷갈리지 않는다. 이번처럼 원본 id가 모두 1이면 그 필드는 쓸모가 없다.
- 유출구 지점은 미리 하천에 붙여 둔 것을 쓴다. 한 파일 안의 점 하나가 지류로 잘못 붙으면 하류 유역 면적까지 같이 바뀐다.
다음 회차
전체 집수 면적이 필요한 경우를 위해 Whitebox에는 겹친 유역을 층별로 따로 내보내는 UnnestBasins가 있다. 다음에는 같은 A, B 점 파일을 UnnestBasins에 넣어, 21편처럼 따로 돌린 두 유역이 한 번 실행으로 그대로 나오는지, 출력 파일이 어떻게 나뉘는지 확인해 보려고 한다.
작업 메모
이번 회차는 QGIS 시작 스크립트로 같은 대화상자에 값을 넣어 실행했고, 화면은 그때 캡처한 것이다. 원본 프로젝트는 그대로 두고 복사본(QGIS_Play_NaGeoAI_20261110_22_nested.qgz)에서 작업했다. 자료 출처는 USGS 3DEP(The National Map) 타일 13SDE474426이고, 원본 점군과 DTM은 다시 배포하지 않는다. 유역 래스터는 출력 파일을 다시 읽어 포인터를 따라 처음 만나는 유출구로 numpy에서 따로 칠한 결과와 셀별로 비교했고, 두 순서 모두 일치했다. QGIS 3.44.15, WhiteboxTools 2.2.0. SHA-256 앞 12자리:
- 입력 DTM 069a9c249240
- D8 포인터 0.03(19편) ce45b57cf7ac
- 옮긴 점 A / B 5 m(21편) .shp 54f3fac90e3e / b2ba31ef9bed
- 병합 점 A,B / B,A .shp dfd95ae7b05b / 7f714af8636e
- 유역 A,B / B,A 12c9fc71b969 / 5653bab48797


댓글 없음:
댓글 쓰기